互联网时代对系统的可靠性提出更高的要求。关键系统往往要求4个9的可用性,也就是每... 展开 >
可靠性系统工程实践
会议室:203出品人:刘道儒
- Topic 1
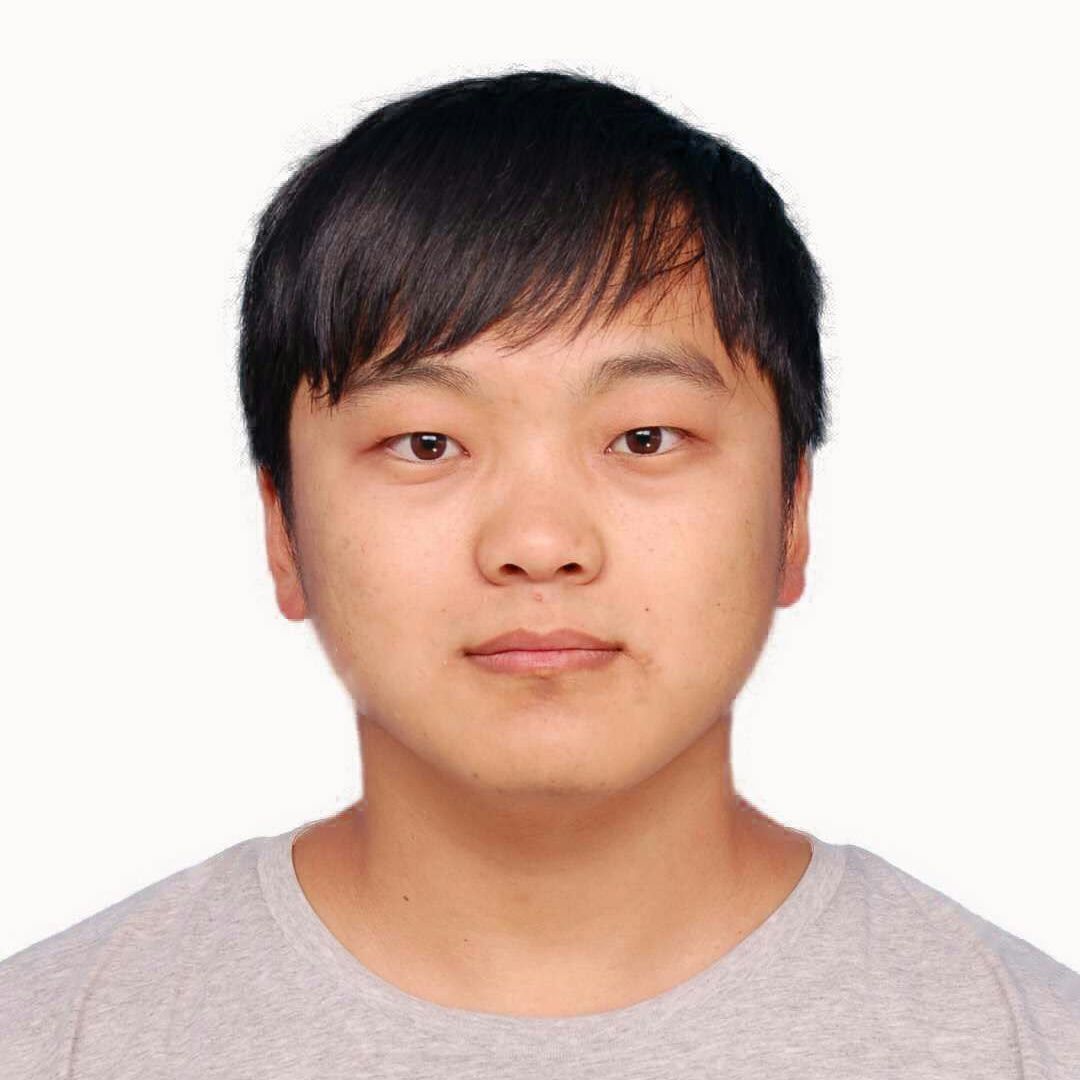
皮振伟
字节跳动 火山引擎云计算高级工程师 - Topic 2
马骎
新浪 微博研发中心基础架构部/架构师 - Topic 3
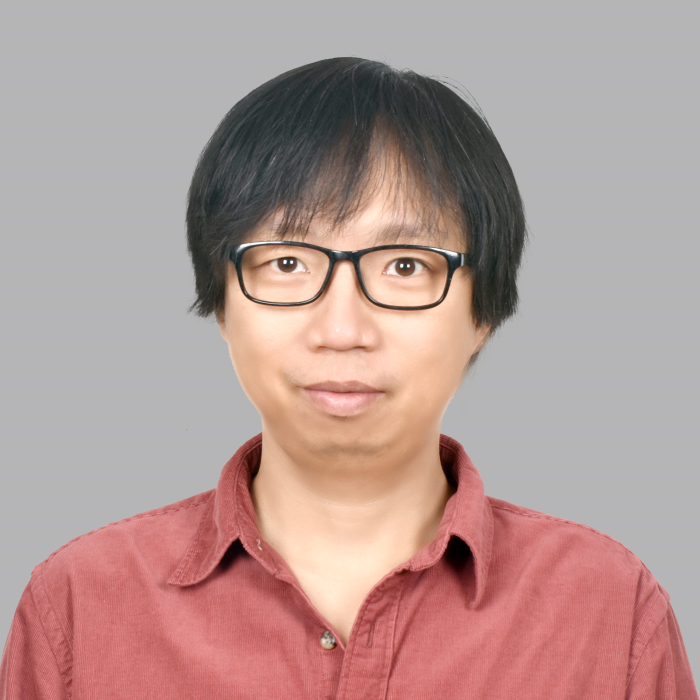
周宇
阿里云 弹性计算/高级技术专家 - Topic 4
周德明
京东到家 研发部/架构师
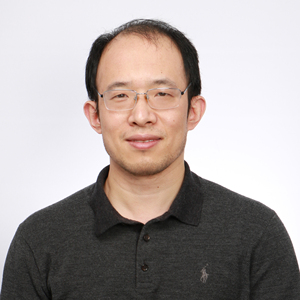
专题出品人:刘道儒
新浪微博研发中心研发总监
刘道儒为微博基础架构部负责人,曾供职于搜狗等公司。负责微博云平台、运维、DBA 等基础平台及关系流、推荐引擎等后端系统的研发工作,同时负责微博热点应对及全站稳定性保障工作。擅长云原生架构及大规模分布式系统的构架和高可用保障,在云原生、混合云、大规模数据的存储、处理、访问、高可用保障等方面有丰富的实践经验。作为项目负责人,曾主导过微博多机房部署、微博A/B测试平台、微博混合云、客户端 Feed 性能优化等项目,并主要参与了微博平台化改造、平台稳定性改造等项目,目前主要关注云原生、混合云、大数据架构、AIOps 等技术方向。
地点:203
专题:可靠性系统工程实践
互联网时代对系统的可靠性提出更高的要求。关键系统往往要求4个9的可用性,也就是每年的不可用时间不能超过53分钟。与此同时,各种开源框架、工具以及工程方法的使用,在提升效率的同时,也带来系统架构复杂,系统失败容易迅速蔓延,副作用被放大。有时一个错误的数据操作或者一行简单的代码缺陷就能使核心系统瘫痪且迟迟无法恢复。为了应对这个挑战,不同的公司结合本身的技术能力和业务特点,形成了多样的可靠性最佳实践。
by 皮振伟
字节跳动
火山引擎云计算高级工程师随着硬件种类的增加和功能多样性、操作系统的复杂度也在提升。操作系统级别的可靠性建设难度也随着提高。从操作系统内核、虚拟化以及工具开发等方面着手,致力于解决内存硬件故障导致的服务不可用、操作系统崩溃以及业务的延迟抖动等问题,业务的可靠性和稳定性得到了较大的改善。
演讲提纲:
- 虚拟化场景下的内存硬件故障处理
- 内核 RAS 能力增强
- 虚拟化支持内存故障事件
- 调度器智能调度
- 虚拟机的崩溃监控以及治理
- 内核、虚拟化增强崩溃监控
- 内核崩溃 log 汇聚,大数据分析
- 虚拟机一键健康检查
- 延迟、性能抖动的监控和工具建设
- ATOP 监控能力增强发现调度延迟
- BCC 支持 TCPRTT 工具实时分析网络延迟
- 总结
- 内存故障预测降低业务影响
- 虚拟机崩溃概率收敛到万分之一
- 系统工具建设助力debug、tracing能力
你将获得:
- 较新、较创新的监控手段,准确监控内存故障,以及预测内存故障降低对业务的影响。
- 较深入的操作系统、虚拟化技术细节,可以了解 PVPanic 的原理以及最新的改进情况。
- ATOP、BCC、Util-linux 等监控、性能工具的部分新特性。
by 马骎
新浪
微博研发中心基础架构部/架构师可靠性保障是一个复杂的系统工程,特别对于可靠性已经出现问题的线上服务,在业务迭代、成本约束、人力投入等方面的约束下 ,提升其可用性需就不再是单纯的技术问题了。
微博推荐引擎作为各类推荐业务在线服务的枢纽环节支持着微博热门流,小视频后推荐等业务,在快速的迭代过程中,其可靠性问题逐渐暴露出来。同时随着业务需求的变化,其在物料规模,已读过滤等方面的限制逐渐成为了限制迭代的瓶颈点。频发的抖动与宕机,快速膨胀到几十万行的代码,极大的消耗了开发同学的精力。在多重的压力下,推荐引擎已经滑向了失控的边缘。
本次分享将介绍将介绍微博推荐引擎在数月的时间里从不可控回到可控,可用性由不足2个9提升至3个9以上,同时提升业务支持能力的经验。
演讲提纲:
- 微博推荐引擎介绍
- 推荐引擎架构与业务特点
- 推荐引擎面对的稳定性与业务挑战
- 保障可靠性的条件
- 服务本身的质量 - 提升程序关键点的能力,保证代码质量
- 外围工具 - 服务治理、问题排查等各方面工具的使用
- 人力 - 开发时间,运维投入的均衡,面对“脏活累活”保持工作动力
- 外部环境
- 改造实践
- 面对频发的性能抖动与宕机,快速接入微博平台统一的运维体系,服务由不可控至基本可控
- 重写引擎内的物料模块,单机物料支撑量从百万级提升至千万级,重写已读功能提升正确率
- 完善外围工具,接入微博通用热点应对、扩缩容与降级机制
- 灵活使用各种工具提升开发效率
- 协调沟通,创造对改造友好的外部环境
- 总结及回顾
你将获得:
- 了解系统性解决可靠性问题的方法与途径
- 了解推荐引擎及其中的技术痛点
- 了解针对业务特点设计自动扩缩容与降级策略的方法
by 周宇
阿里云
弹性计算/高级技术专家阿里云弹性计算产品的计算节点作为百万级客户基础设施稳定性保障。结合 DevOps 方向社区经验,以及阿里巴巴集团已有基础服务基础上,阿里云弹性计算构建了一套智能诊断平台,实现了运维规模、自动化运维能力、客户运维能力、故障快速恢复几方面能力。
本次分享会跟大家介绍我们是如何设计和建设这套体系,以及如何解决我们在过程中遇到的技术难点;最后还会重点介绍阿里巴巴集团以及其他头部客户结合我们的智能诊断运维体系,如何在自身业务上形成最佳实践,希望借此机会与大家共同学习进步。
演讲提纲:
- 背景:为什么要做智能诊断体系?
- 同类型产品调研与分析
- 项目难点与解法
- 智能运维体系设计与实现
- 项目效果与能力开放
你将获得:
- 帮助 DevOps/AIOps 方向的开发者和基础设施类服务的稳定性建设者,了解在超大规模下智能运维需要思考的问题、难点、瓶颈以及阿里的解法
- 学习到处于业界领先水平的故障预测准确率高达99%的技术方案
by 周德明
京东到家
研发部/架构师首先介绍到家开放平台版本演进及全局系统架构,然后重点介绍开放平台接口服务发布系统、开放平台商家自助对接解决方案、基于Web的商家实时消息自助订阅方案、开放平台接口网关统一链路服务化流程、轻量级的商家系统对接快速联调测试解决方案、快速定位商家系统对接业务接口的全链路日志解决方案、开放平台一体化服务运营、统计监控预警系统。最后,分享商家系统对接过程中各类问题的解决方案。
演讲提纲:
- 开放平台版本演进及全局架构
- 开放平台核心系统:
- 内研系统,可动态扩展构建、发布接口服务
- 门户系统,面向商家、开发者的系统自助对接行业解决方案
- 接口网关,统一请求链路、数据安全防控,保障服务高可用
- BMQ系统,基于Web 的商家实时消息下发能力,多级可配置可降级的消息通道,保障平台消息有效触达
- 服务运营,全栈数据支撑,具备实时统计监控预警能力
- 开放平台实践解决方案:
- 门户系统轻量级的商家系统对接快速联调测试解决方案
- 快速定位商家系统对接业务接口的全链路日志解决方案
- 商家系统对接过程中遇到的各类问题汇总及实践解决方案
听众受益:
了解行业内开放平台常规架构、到家开放平台0到1构建过程、如何适配公司业务发展迭代开放平台版本、到家开放平台核心系统架构实践解决方案、商家开发者自助系统对接的轻量级解决方案、以及如何面对商家系统对接过程中遇到的各类问题以及实践解决方案。
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路7号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 17310043226

微信联系我们
小姐姐