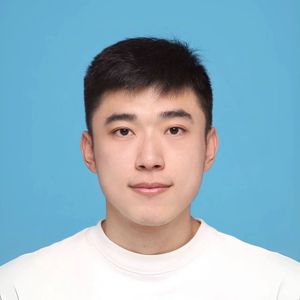
现任快手大模型训练引擎负责人,致力于提升基础大模型的训练效率。有 Colossal-AI、Megatron-LM 等多个开源训练框架的架构设计和研发经验,主导并参与了数千卡规模的大模型训练工作。
讲师介绍
议题介绍
地点: VIP 1
所属专题:大模型训练和推理工程
演讲:超大规模集群下大语言模型训练的最佳实践
快手总结了一套超大规模集群下大语言模型训练方案。该方案在超长文本场景下,在不改变模型表现的情况下,训练效率相较 SOTA 开源方案,有显著的吞吐提升。通过细致的建模,可保证 Performance Model 十分接近真实性能,基于此 Performance Model,解决了大模型训练调参困难的问题。
本次演讲将结合在快手超算集群上的大模型训练经验,阐述大模型训练在超大规模集群下遇到的挑战和热点问题的演变,以及对应的解决方案。同时,针对最具挑战的超长文本场景,进行案例分析。最后,会根据未来大模型的发展趋势,对训练领域的技术探索方向进行探讨。
演讲提纲:
1. 背景与趋势
- 大模型的发展趋势
- 分布式训练的主要难点
2. 大模型训练在超大规模集群下的挑战与解决方案
3. 超长文本场景的案例分析
4. 未来趋势与技术探索
听众收益:
- 超大规模集群上,随着大模型的发展,热点问题的演变和解决方案
- 快手在超长文本场景下的系统解决方案
- 更多大模型训练技术的尝试与探讨
方案痛点:
- 通过计算通信 Overlap 达成了训练吞吐加速,然而由于 GPU 没有独立通信器件导致通信会对计算造成影响,如果没有精细的调优会导致加速效果不符合预期
关注主办方(InfoQ)


联系我们
交通指南
北京国测国际会议会展中心
GUOCE International Convention And Exhibition Center
地址:北京市顺义区临空经济核心区汇海南路6号院20号楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 17310043226

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手