大模型存储加速论坛,聚焦探讨大模型时代的存储挑战与技术革新,共同研究高效存储方案... 展开 >
AI 存储加速
会议室: VIP 2出品人:阮若夷
- Topic 1
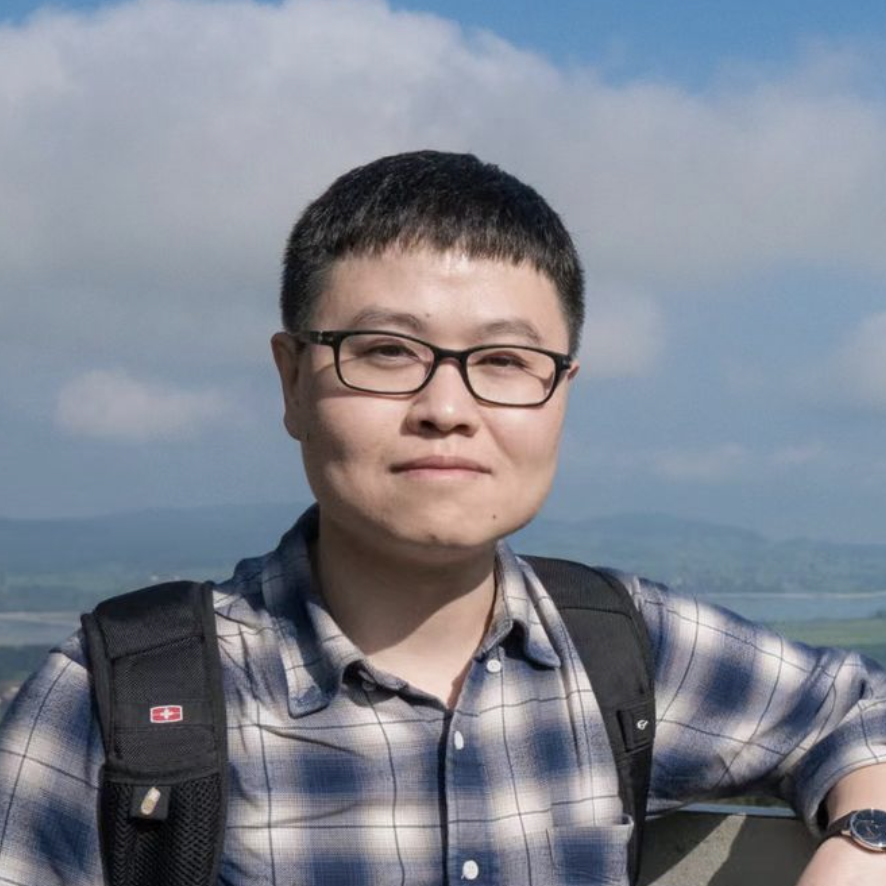
刘键
蚂蚁集团 高级技术专家 - Topic 2
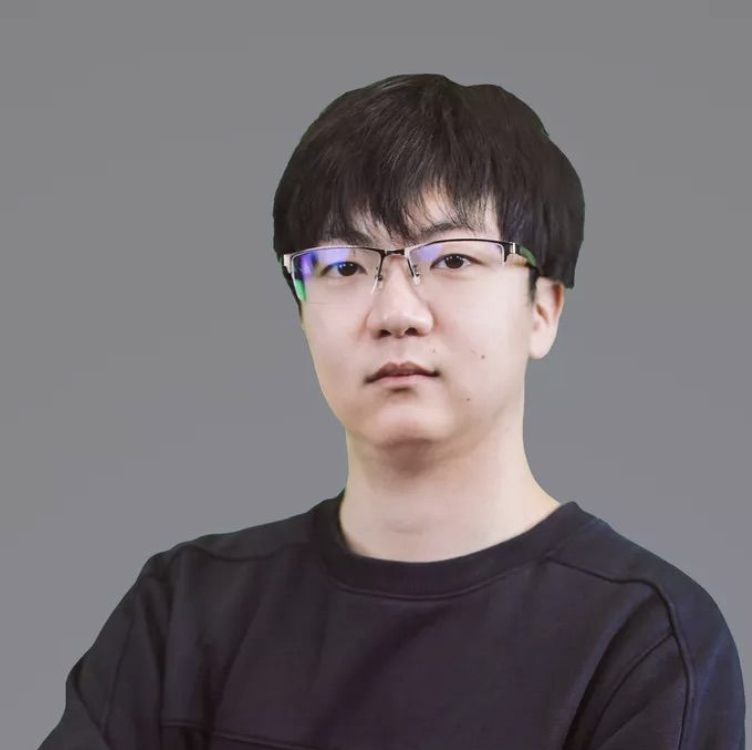
肖文聪
阿里云 高级技术专家 - Topic 3
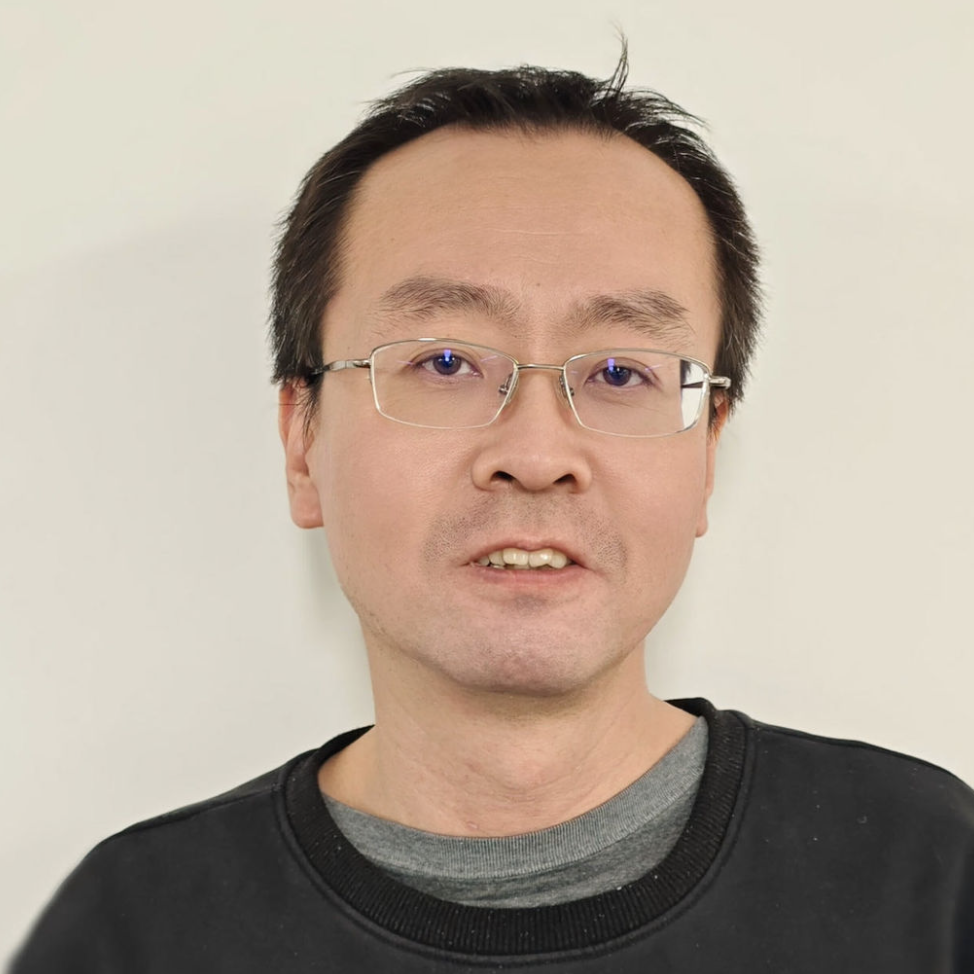
曹雪林
京东云 资深架构师 - Topic 4
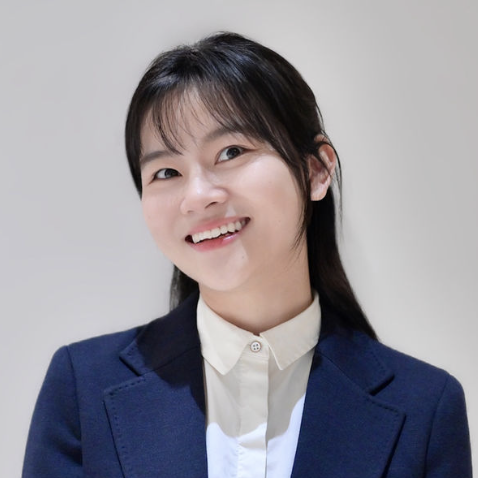
姚婷
华为云 近计算存储架构师
专题出品人:阮若夷
蚂蚁集团资深技术专家
阮若夷,蚂蚁集团资深技术专家,存储与多媒体技术负责人,Ray 中文社区创始人。从事大数据系统、分布式系统和计算、存储数据库领域相关工作十五年。
地点: VIP 2
专题:AI 存储加速
大模型存储加速论坛,聚焦探讨大模型时代的存储挑战与技术革新,共同研究高效存储方案,加速 AI 应用落地。
by 刘键
蚂蚁集团
高级技术专家当前随着大模型技术的快速发展,训练的数据规模越来越大,e.g., 在多模态场景中,单次训练的图片数量可能达到十亿甚至百亿级别并且需要同时处理视频、图片、音频、文本等多种模态数据。训练任务运行时 checkpoint 写入频率也在逐步加快,从天到分钟间隔,对于千亿以上参数规模的训练任务每秒写入吞吐会达到 TB 级数据。为了提高训练效率,减少训练过程中因数据读写开销导致的 GPU 资源浪费,蚂蚁构建了一套大模型缓存加速系统 PCache,具备百亿文件的元数据管理和横向扩展能力;同时采用近端加速以及面向 AI 数据特性的缓存策略,从数据预处理、样本读取、模型加载,到 checkpoint 写入,为训练任务提供数据读写完整的高性能和低成本的解决方案。除此之外,为了适应当前多 AI 算力中心的趋势,PCache 还采用云原生的架构,加快了建站效率和故障时的高可用性;以及通过全增量一体数据同步系统提高了各 AI 站点之间的数据迁移效率,为训练任务的算力调度提供了基础保障。
演讲提纲:
1. 背景介绍:业界和蚂蚁大模型存储需求 & 问题
2. 蚂蚁大模型存储加速整体架构
- 多类型用户接入方案
- 部署模式:和训练任务混部
3. 大模型读写性能优化
- 海量文件元数据管理方案 (文件折叠 + 元数据服务 & 存储分离 + 联邦模式)
- 面向 AI 数据特性的 cache 策略:读取加速 + 提高缓存效率
4. 稳定性 & 产品易用性
- 云原生架构 + 高可用方案
- 多站点/多存储之间的全量和增量数据同步系统
听众收益:
- 了解大模型训练场景中存储可能碰到的问题
- 如何结合存储服务的部署方案、元数据优化、面向 AI 数据特性的 cache 策略、和支持高吞吐的 checkpoint 写入能力为大模型训练任务提供完整的存储解决方案
- 在大模型多算力中心的趋势下,如何提高存储的效率和产品易用性
方案痛点:
- 和训练混部的这种近端加速方案,需要在网络和资源调度上做更好的规划,避免对训练任务的影响,e.g. 数据网络和参数网络
by 肖文聪
阿里云
高级技术专家AI 大模型训练是当前最火的话题,我们发现 AI 大模型训练对于云存储有这巨大的挑战,数据链路的加速能力对于大模型训练任务对性能和稳定有这巨大对影响。在这个演讲中,我将分享这些挑战的根因以及阿里云如何构建分布式缓存产品来应对这些挑战。
DatasetAcc 是阿里云倾力打造的一款全托管弹性 PaaS 数据服务产品,提供面向机器学习场景深度优化的数据加速服务,旨在有效解决云端 AI 任务在数据访问层面所面临的效率瓶颈。该服务通过近端缓存技术为 GPU 驱动的机器学习任务量身定制了加速机制,能够广泛支持包括 OSS、NAS、CPFS 以及 MaxCompute 在内的多种云上数据源,无论是结构化还是非结构化数据,都能有显著的访问速度提升。针对机器学习训练过程中特有的随机小文件 IO 需求和独特的模型数据加载特性,DatasetAcc 进行了深入细致的场景适应性优化设计。其提供了一套面向各类云原生训练引擎的一体化数据集访问加速方案,确保了从数据加载到模型训练整个过程中的高效数据流转,并最终助推 AI 训练任务提效加速。
by 曹雪林
京东云
资深架构师by 姚婷
华为云
近计算存储架构师华为云通过 SFS Turbo 与 OBS 联动提供了大容量、高可靠、低成本的数据持久化层和高效的缓存加速层。作为 Al 训练加速器的 SFS Turbo 通过 MDS Turbo 和全路径软硬件优化实现了低时延数据流传、元数据千万级 IOPS、百亿小文件预热与数据载入加速;通过 AlTurbo 融入 Al 训推生态,与 Mindspore 等计算框架融合,实现了可靠的内存检查点,达成了万卡集群的秒级检查点快存、快恢。
本次演讲将从技术架构角度解读华云存储的一站式数据管理、存储、加速方案。
听众收益:
- 了解华为云存储高性能并行文件系统的三阶段进阶
- 了解华为云盘古大模型的秒级故障快恢及华为云的端到端全栈优化
方案痛点:
- 对于非华为计算框架 Mindspore 的训练任务,检查点快存快恢、训练数据加载加速都需要修改用户代码,易用性有所下降
关注主办方(InfoQ)


联系我们
交通指南
北京国测国际会议会展中心
GUOCE International Convention And Exhibition Center
地址:北京市顺义区临空经济核心区汇海南路6号院20号楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 17310043226

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手