过去十年,谷歌三驾马车论文的发布拉开了大数据时代的序幕,无数优秀大数据计算框架应... 展开 >
数据库与大数据融合之路
会议室: VIP 2出品人:金晓军
- Topic 1
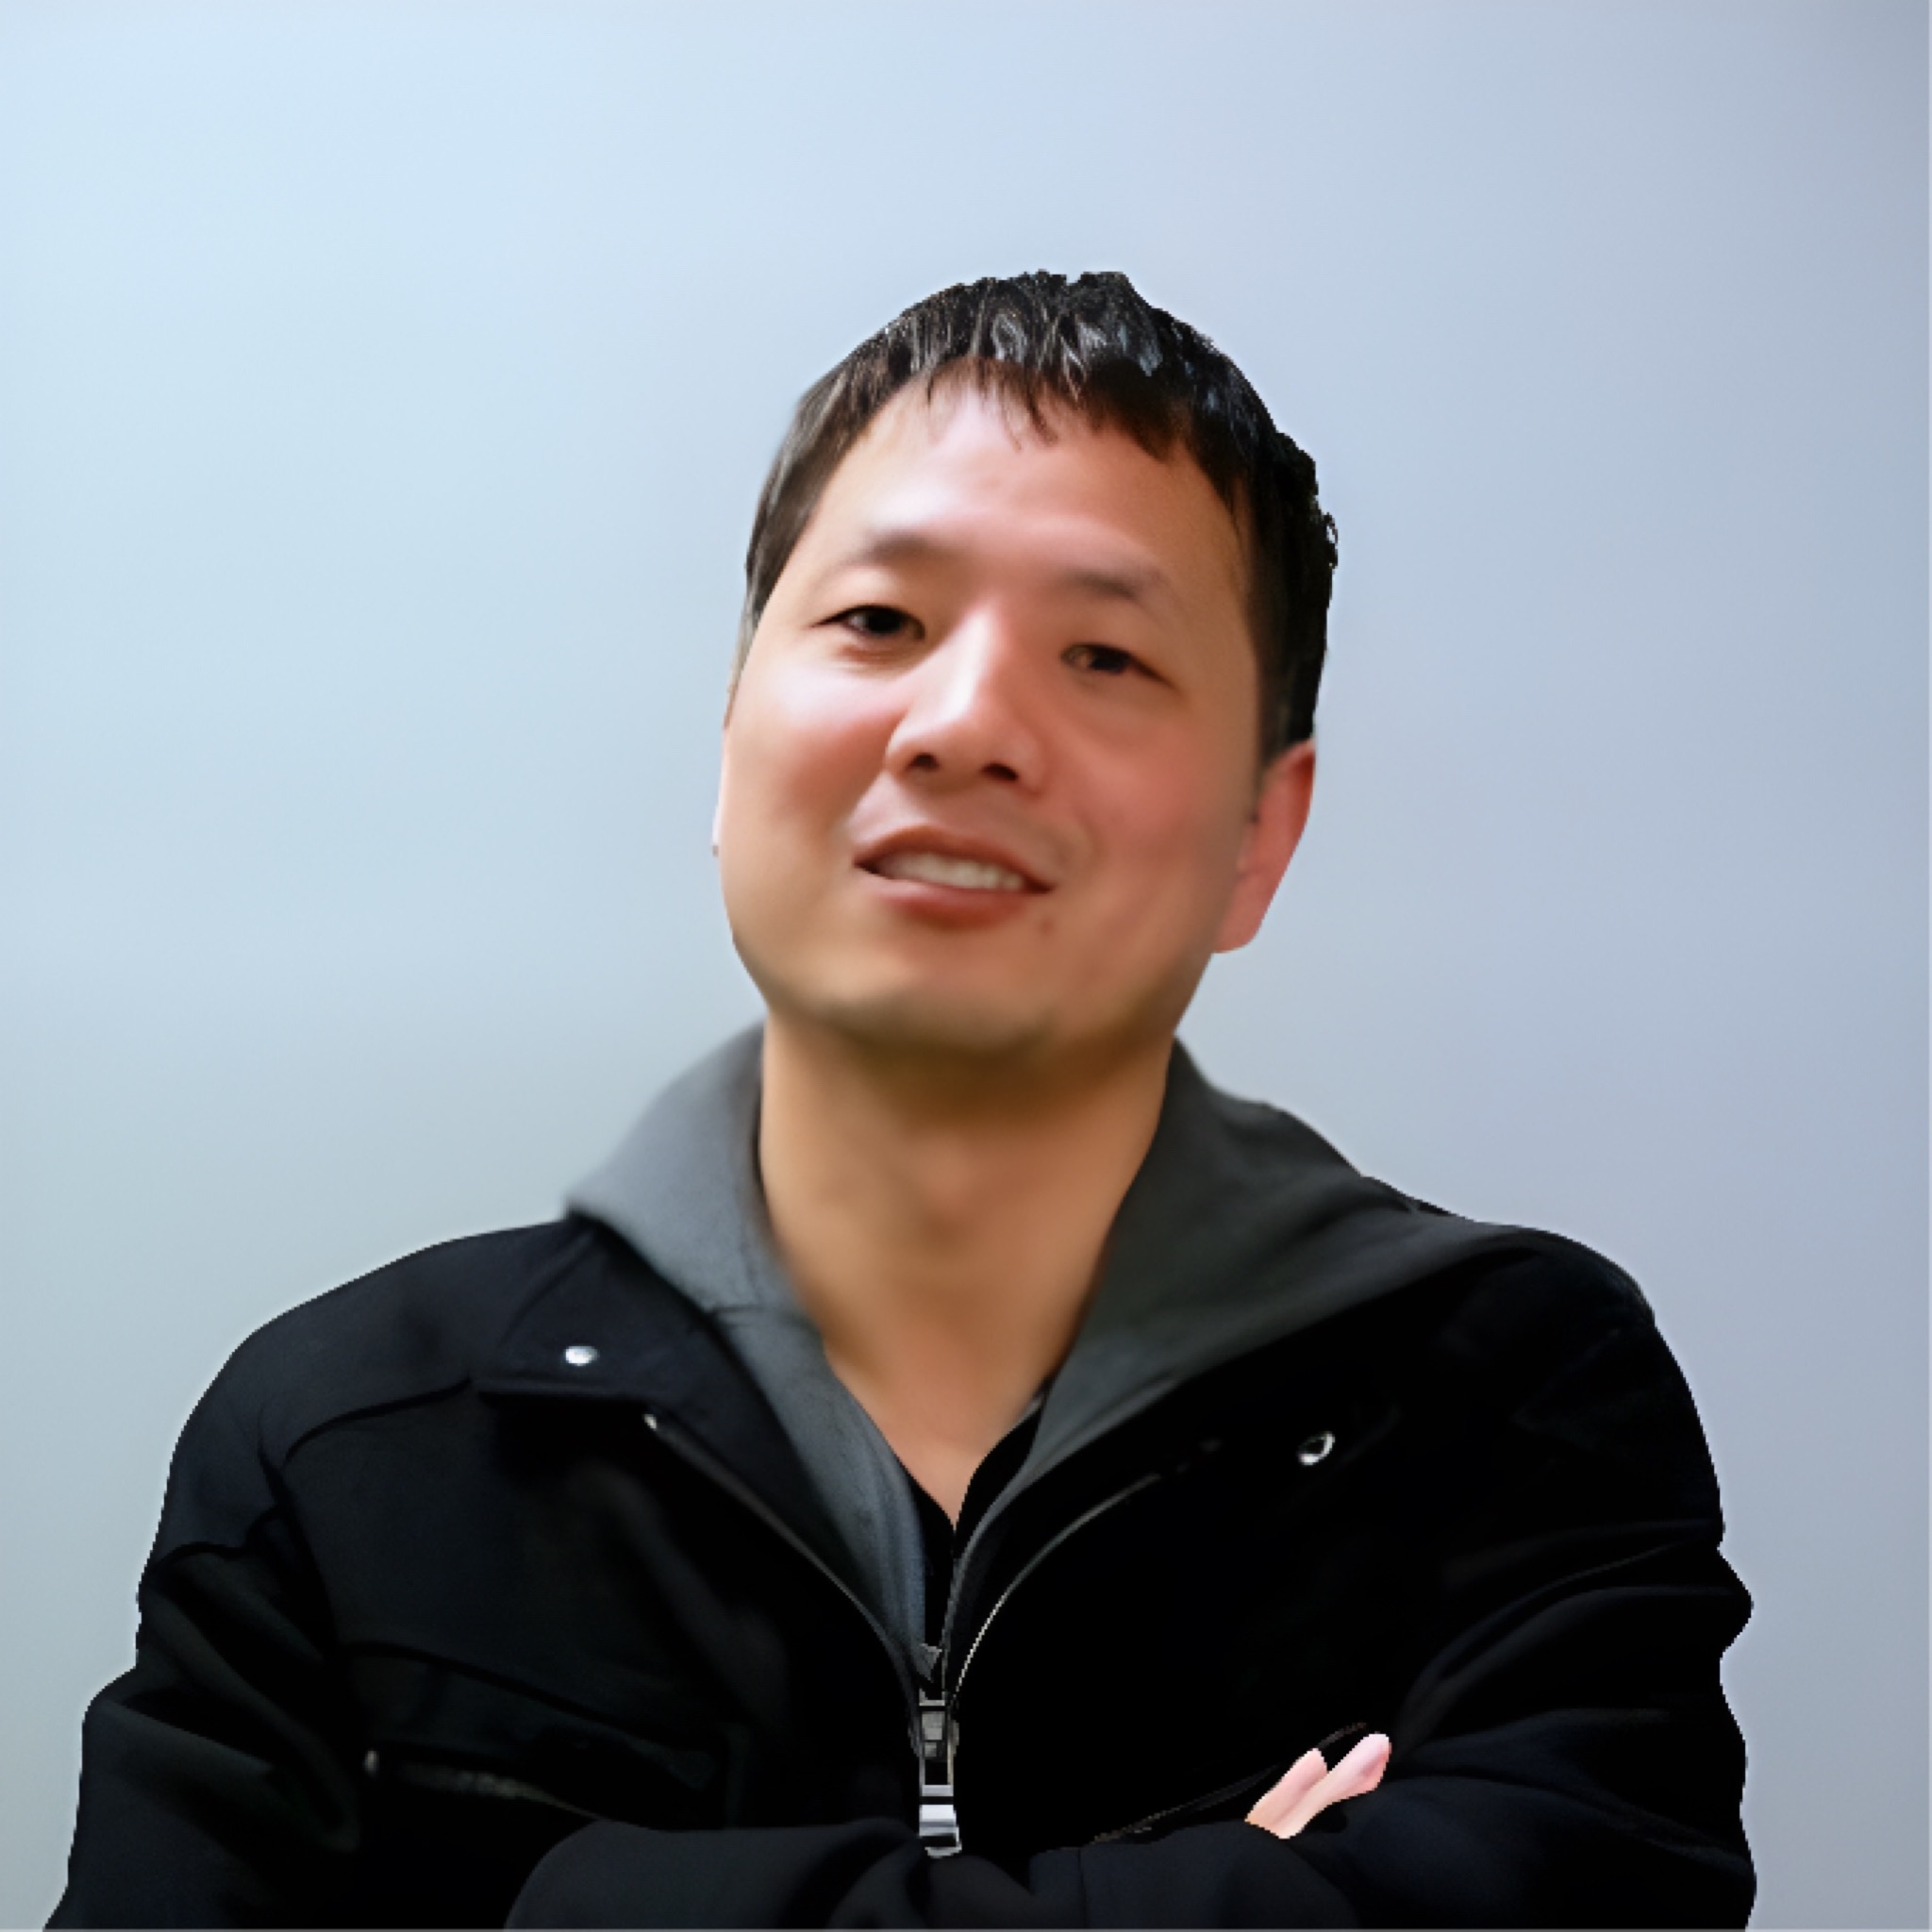
蒋晓伟
ProtonBase 研究员 - Topic 2
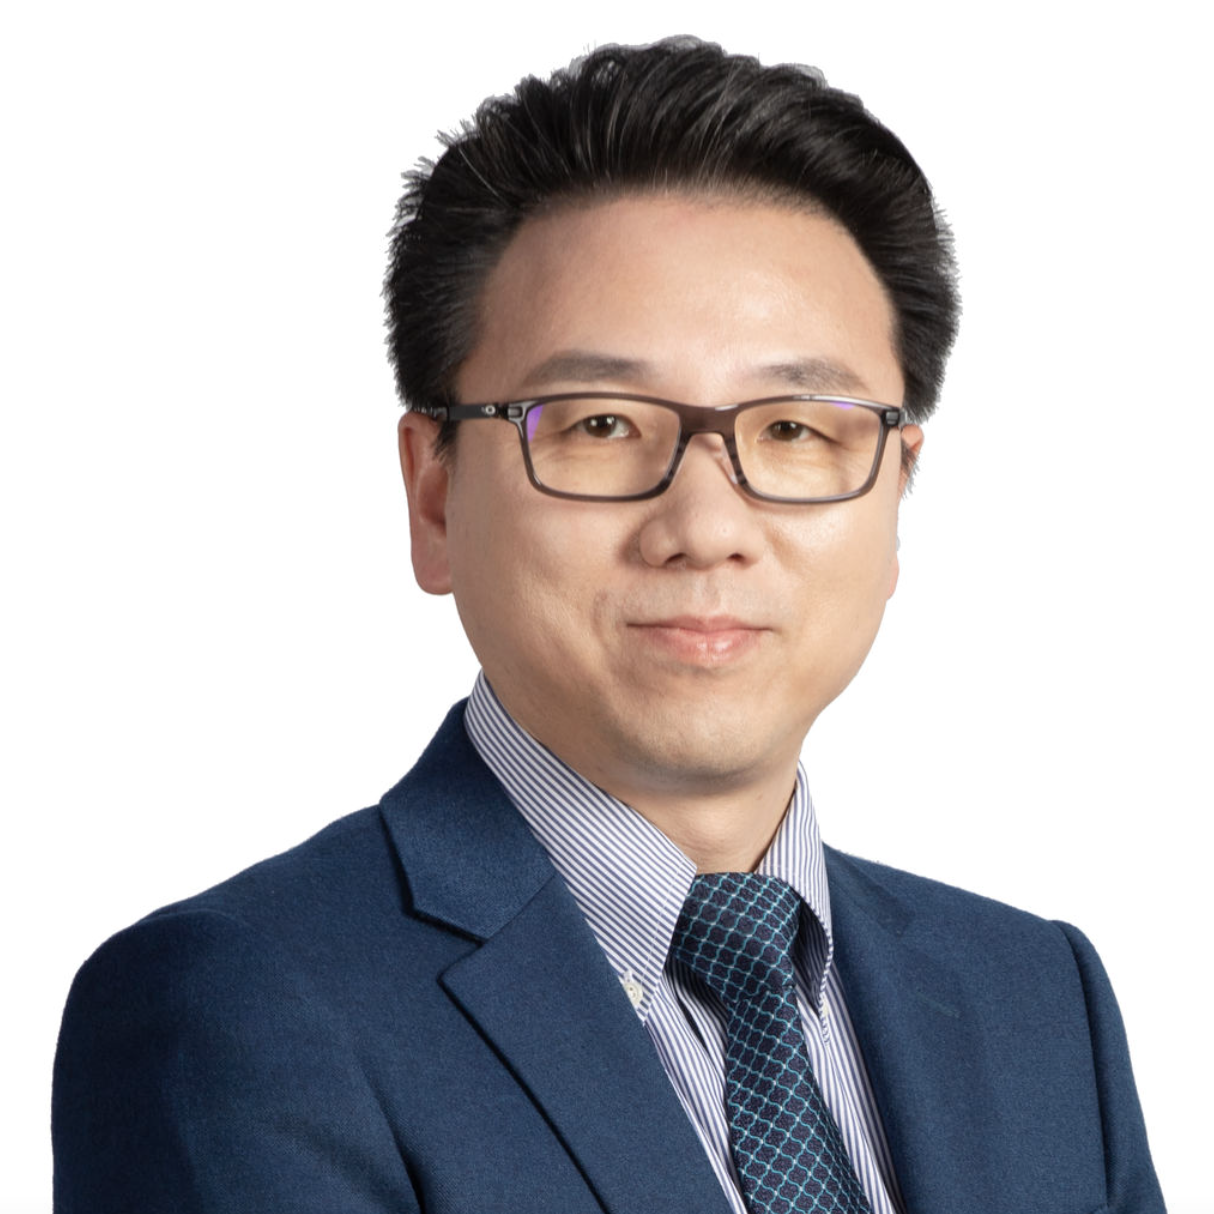
郝峻青
Timeplus 联合创始人 - Topic 3
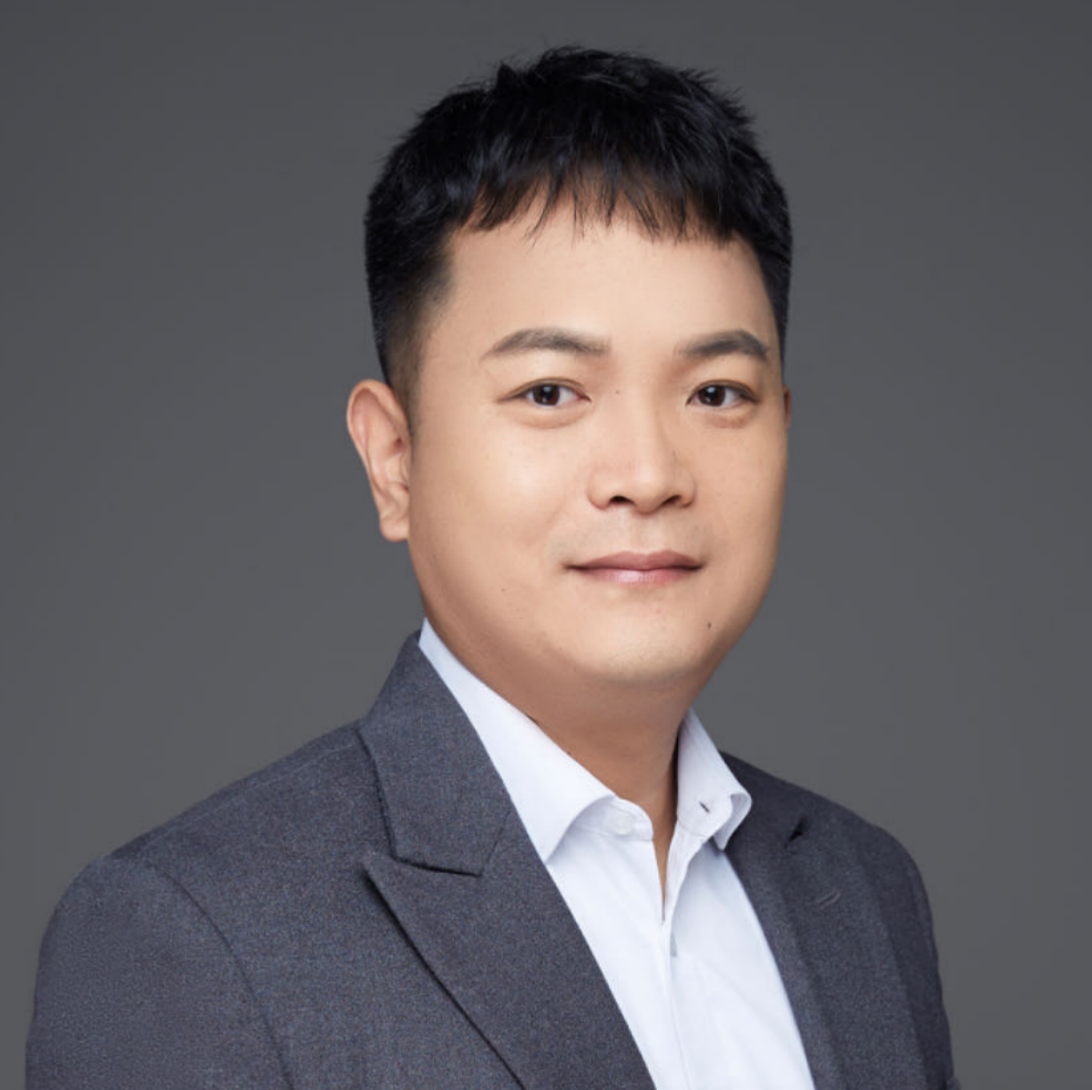
乔云从
Fabarta ArcGraph 高级技术专家 - Topic 4
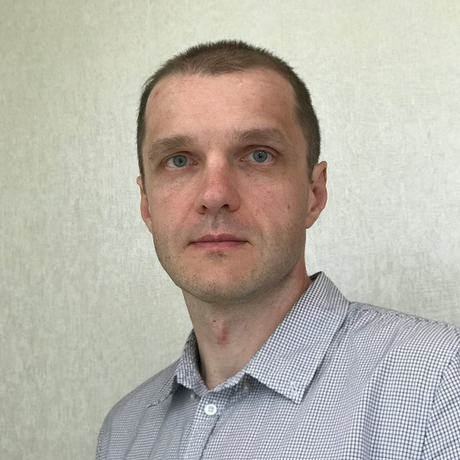
Alexander Zevaykin
Yandex Technical Leader
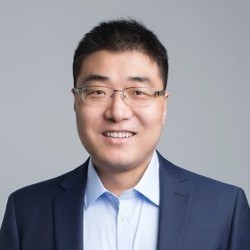
专题出品人:金晓军
小质科技技术 VP
现任小质科技技术 VP,曾任阿里巴巴资深技术专家、网易数据科学中心大数据平台技术负责人。是阿里云交互式分析产品 Hologres 核心开发,担任 Hologres 产品的研发以及商业化相关工作。还曾设计开发阿里云流计算产品 StreamCompute V1.0/Galaxy,支持多届阿里巴巴双 11 实时大屏业务及集团大部分流计算业务。担任网易数据科学中心大数据平台技术负责人期间,负责网易大数据平台建设,自研系统研发与开源组件功能扩展与集成、大数据产品化输出。
地点: VIP 2
专题:数据库与大数据融合之路
过去十年,谷歌三驾马车论文的发布拉开了大数据时代的序幕,无数优秀大数据计算框架应运而生,造就群星闪耀的大数据时代。然而,随着人工智能的崛起,数据量呈指数级增长,数据源日益复杂,企业对实时数据分析的需求与日俱增,这些都给现有的数据架构带来了全新的挑战:我们能否让数据计算变得像数据库一样简便易用且稳定?数据处理链路是否还能更简洁高效?数据库和大数据两者是否能够融为一体?在本专场中,我们将深入探讨数据库与大数据领域的交汇点,深刻了解如何有效结合二者的力量以驱动 AI 时代更灵活、高效、实时的数据洞察与决策。
by 蒋晓伟
ProtonBase
研究员演讲提纲:
1. AI 时代,如何更深入地发掘数据潜在的价值
2. 云原生分布式 Data Warebase 开启处理数据的新范式
3. 构建云原生分布式 Data Warebase 的要素
4. 数据涌现智能,一个系统满足业务全方位数据需求
听众收益:
- 了解数据领域最新发展趋势
- 如何借助新一代数据系统更好地提升业务价值
- 了解AI 时代应当搭建什么样的数据底座
by 郝峻青
Timeplus
联合创始人随着数据驱动决策在商业、金融和科技领域的日益普及,对实时数据分析的需求也随之增加。OLAP 数据库具备高性能的存储以及完备的 SQL 查询能力,而流式数据处理技术为低延迟的实时数据分析提供新的技术方案,通过对 OLAP 数据库的存储和查询引擎进行流批融合处理的改造,可以有效地将流式数据处理的实时性与 OLAP 数据库的高效存储及 SQL 能力相结合,从而使得 SQL 数据查询可以从单纯的对历史数据的批处理查询转换为更加灵活的跨流式数据 / 历史数据的融合查询,大大简化实时分析技术方案。本次演讲将从业务场景出发(如:实时数据集成及 ETL,实时指标分析场景等),并结合真实的应用(如:Timeplus Cloud 实时可观测性,头部证券公司量化交易指标实时监控),阐述相关的技术方案以及其中涉及到的流式数据处理和 OLAP 数据库技术如何结合等问题.
演讲提纲:
1. OLAP 数据库 VS 流式数据处理
2. OLAP 数据库的流批融合应用场景
3. OLAP 数据库的流批融合的技术挑战
4. OLAP 数据库的流批融合技术方案
5. OLAP 数据库流批融合案例分析
听众收益:
- 了解 Timeplus 在 OLAP 数据库流批融合技术的最新进展以及实践经验
- 了解新的解决实时分析问题的思路和方案
- 了解实时分析技术的发展趋势与前景
方案痛点:
- Streaming SQL 的标准化
- Streaming Only 场景下的数据存储冗余
by 乔云从
Fabarta
ArcGraph 高级技术专家与传统关系型数据库相比,图数据库在处理复杂关系数据时具有显著的优势。特别是在需要进行深度搜索及图模式识别的场景中,如金融风控、推荐系统等。尤其是在金融风控领域,图数据库可以帮助金融机构快速识别风险和机会,提升风控能力和效率。但在业务系统对实时性的需求越来越高,同时伴随着越来越复杂的业务模型,图数据库的功能、稳定性和性能仍经受很大挑战。
本次分享,我们将深入探讨图数据库的现状及其在大数据应用中的技术挑战与应对方案,分享用图数据库支撑实时业务系统的先进解决方案、图的查询优化的一些技巧,以及图数据库时序图的典型应用场景,并结合在金融风控场景下的多种图模式的应用,深入探讨图数据库在这些场景中的独特优势。我们还将分享一些图数据库在金融风控系统中的实践案例,展示图数据库的强大功能和应用价值。
by Alexander Zevaykin
Yandex
Technical LeaderYDB is a versatile open-source Distributed SQL Database that combines high availability and scalability with strong consistency and ACID transactions. It provides services for ML-products and goes ahead of vector search.
Outline:
The database is used for industrial operations within Yandex. Among its clients, Yandex Market, Yandex Alice, and Yandex Taxi. They are some of the largest and heaviest AI-based applications.
The database provides true elastic scalability, capable of scaling up or down by several orders of magnitude.
At the same time, the database is fault-tolerant. It has been designed to work across three availability zones, ensuring that the database continues to function even if one of the zones becomes unavailable. The database automatically recovers after a disk failure, server failure, or datacenter failure, with minimal latency disruptions to the applications.
Currently, work is underway to implement accurate and approximate nearest neighbor search for machine learning purposes.
Takeaways:
- Architecture of a distributed fault-tolerant database
- Approaches to the implementation of vector search on large amounts of data
关注主办方(InfoQ)
联系我们
交通指南
北京国测国际会议会展中心
GUOCE International Convention And Exhibition Center
地址:北京市顺义区临空经济核心区汇海南路6号院20号楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 17310043226

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手