RAG(Retrieval-Augmented Generation)是一种结合... 展开 >
RAG 与向量数据库
会议室:国昌厅- Topic 1
张红兵
Fabarta 解决方案负责人 - Topic 2
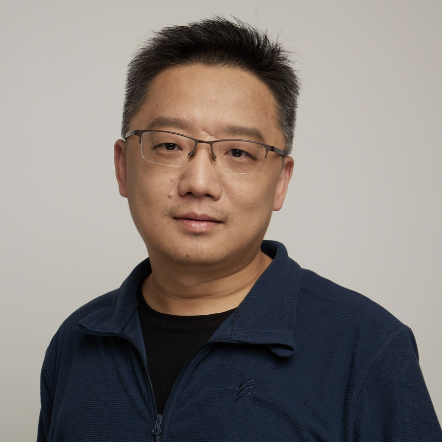
张颖峰
英飞流 创始人 - Topic 3
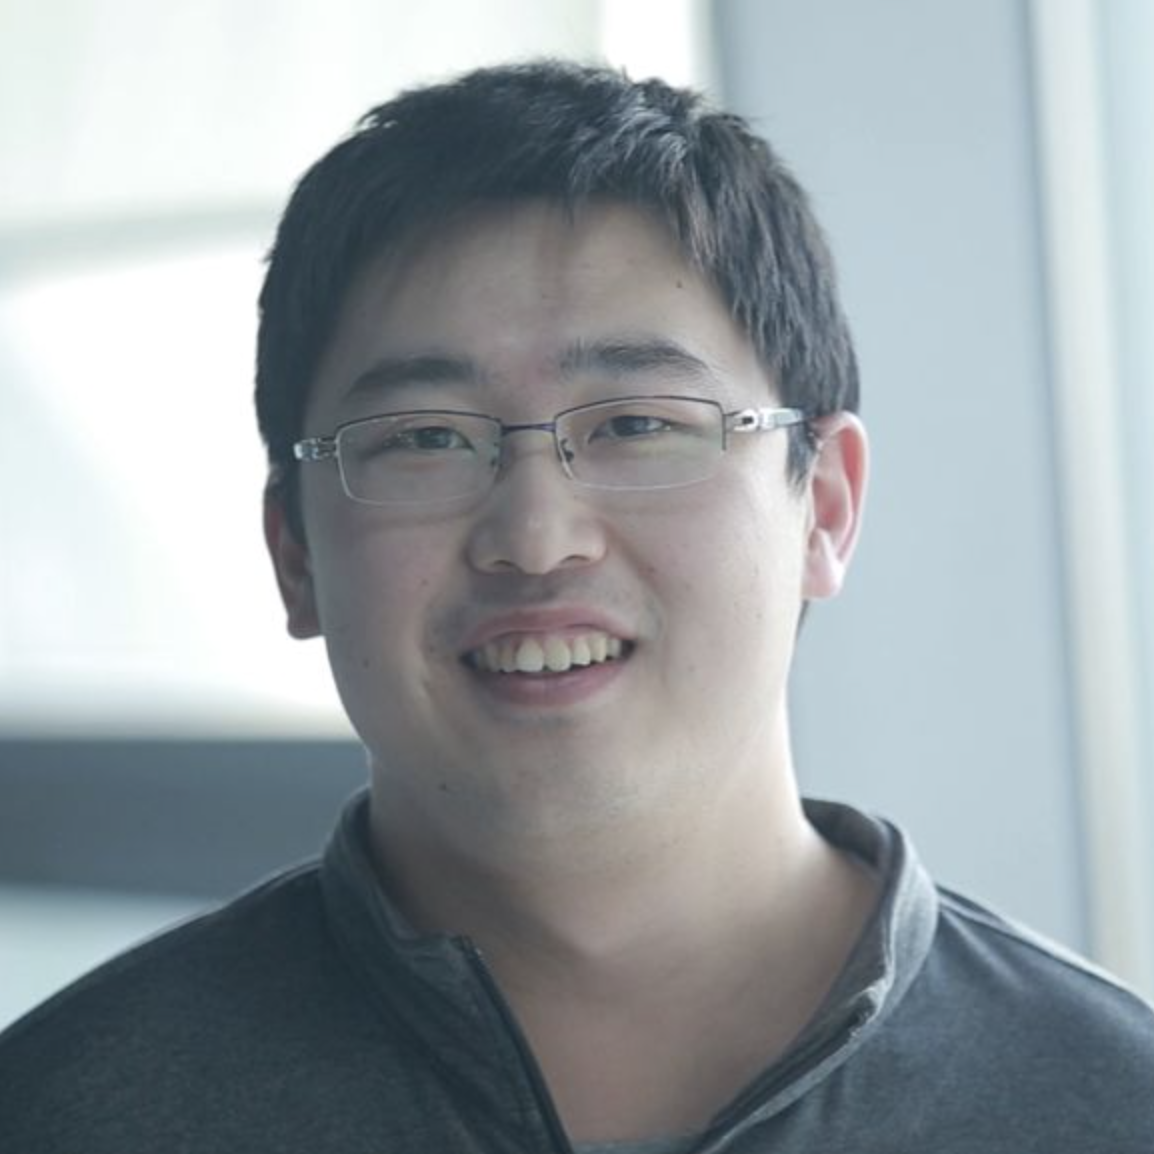
孟圣智
九章云极DataCanvas 资深架构师 - Topic 4
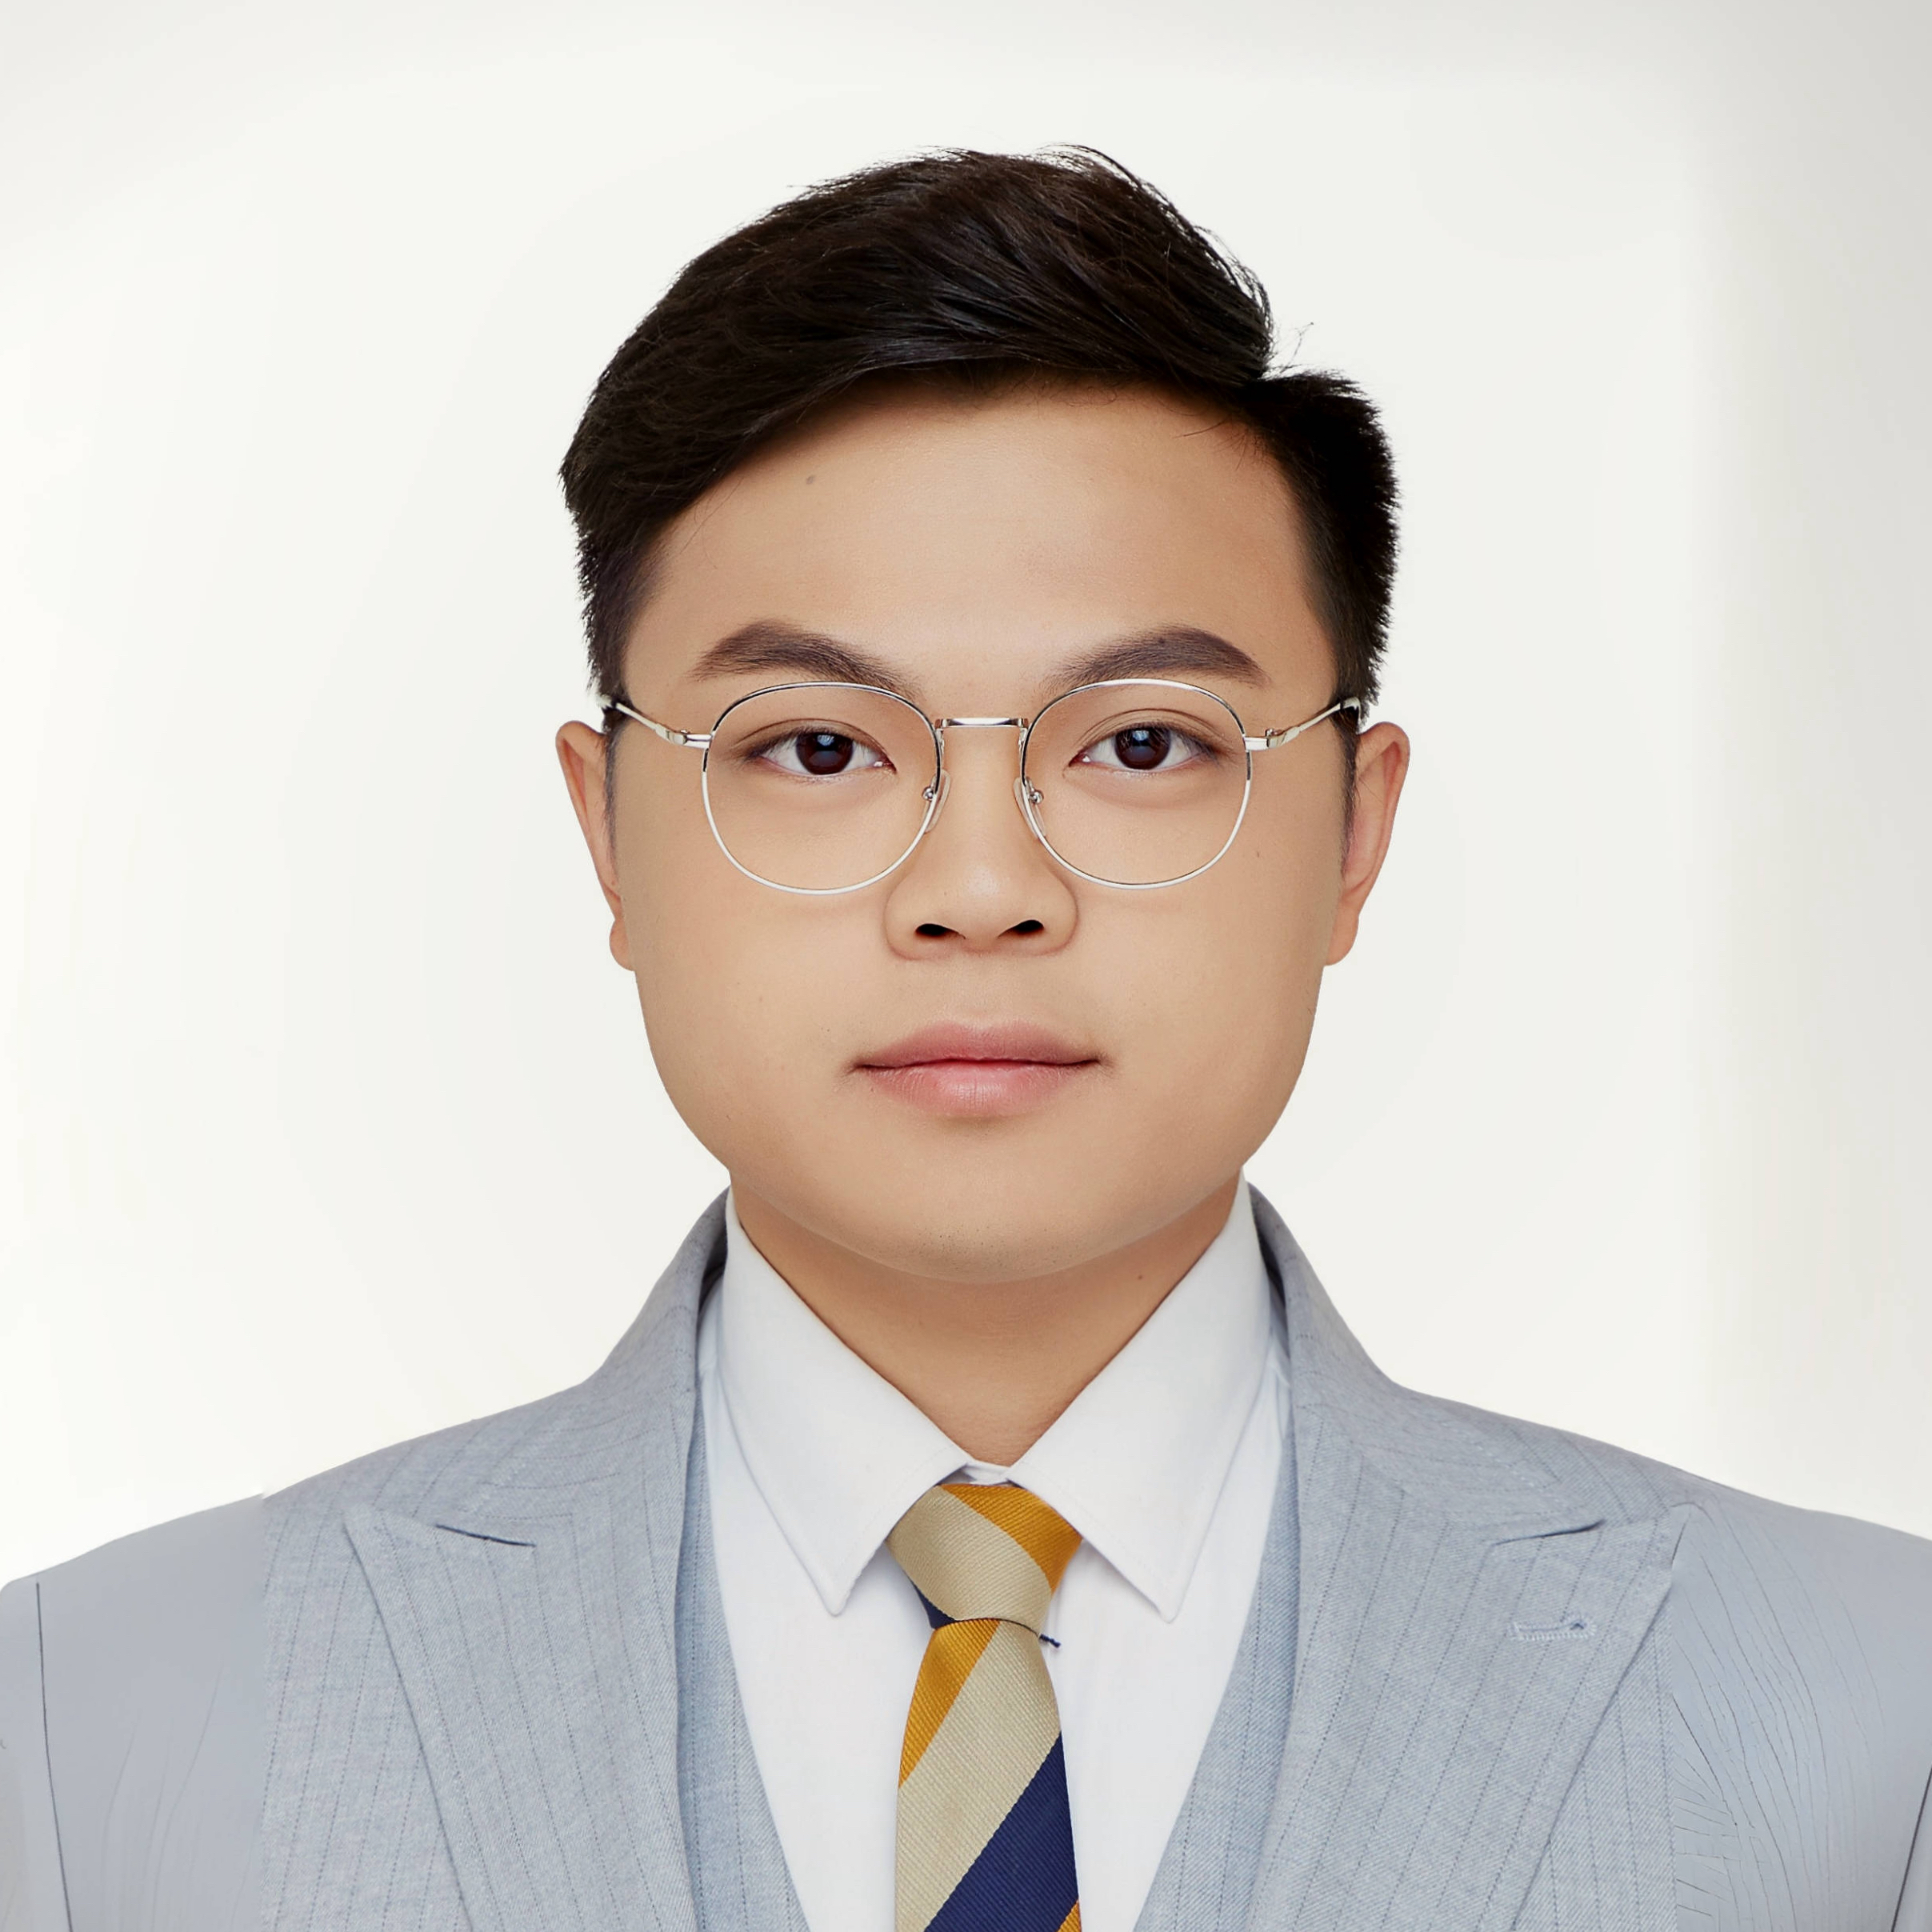
苏鹏
爱可生 AI 创新事业部负责人
地点:国昌厅
专题:RAG 与向量数据库
RAG(Retrieval-Augmented Generation)是一种结合了检索和生成的技术,它通过从海量数据中检索查询到的信息,来增强语言模型的生成能力。向量数据库为这种检索提供了高效的数据结构和存储方式,也天然有着多模态和 Embedding 计算的支撑能力,可以说在 RAG 架构中扮演着至关重要的角色。不过,是否应采用纯向量数据库,还是有更超越的方法,目前仍存在争议,OpenAI 表示将提供一款 Retrieval 检索工具,让用户无需创建或搜索向量,这进一步给讨论加了一把火,本专题希望对此进行探讨,包括但不限于 RAG 应用框架、多模态技术创新、检索型向量库优化实践、分析型向量数据库实践等核心热点领域。
by 张红兵
Fabarta
解决方案负责人AIGC 时代,大模型与企业本地数据相结合的典型实现方式是 RAG 方案(本地知识库 + 向量数据库 + 大模型),而 RAG 实际落地中还存在诸多问题。本次分享将结合落地案例实践经验,针对企业实际、复杂的数据现状,提供全新的解决方式——基于多模智能引擎的大模型知识库方案。对企业多源、异构数据进行解析,智能抽取数据之间的关系并提供低代码方式进行数据探查;将非结构化数据解析以及向量化。在多模态智能引擎中以图的形式存储确定的知识,以向量的形式存储非结构化的知识,以图和向量融合的方式构建大语言模型驱动的企业知识中台。同时,利用低代码技术快速构建包括智能对话、摘要、标签、生成、text2data 在内的各种知识应用,为企业大模型用落地提供有效的技术支撑。
演讲提纲:
演讲提纲:
1. 背景与趋势
- 大模型与企业本地数据融合的典型方式——RAG 最佳实践与现存问题
2.多模态数据解析
- 非结构化文档关系自动抽取构建——多层级关系抽取
- 结构化数据自动关联与探查
3. 图和向量赋能大模型应用
- 利用图结合 RAG 提供智能应用构建能力
4. 知识服务智能构建
- 基于低代码的知识服务构建
5. 落地应用案例分享
- 实际客户落地经验分享
6. 总结与展望
听众收益:
- 当前 RAG 的最佳实践以及典型问题
- 基于图和向量融合的方式构建智能知识库最佳实践
- 典型的知识服务以及落地实践经验
方案痛点:
- 从实践角度出发,我们发现在落地过程中需要针对性结合具体业务场景进行图的构建
- 图和大模型的融合方案需要基于多模态数据构建图。如果客户场景是基于非结构化数据构建细粒度的图谱,则需要一定成本,当前情况下无法实现完全自动化图谱的构建
- 在进行方案落地时,首先需要让客户充分了解和熟悉新技术方案,才能更好地推进落地与应用
by 张颖峰
英飞流
创始人RAG 是 LLM 服务 B 端的最广泛场景,也是标准使用范式。RAG 系统技术栈开源软件很多,可以很快地利用它们搭建起一个 demo,但是真正落实到 B 端服务,面临的挑战却很大,实施周期也很长。 本分享根据 RAG 落地实践,给出解决这些问题的几个要点,并根据这些要点,推导出搭配 RAG 的数据库,应该具备什么样的能力。最后,本分享给出围绕这些 RAG 痛点设计的新一代开源 AI 原生数据库 Infinity 的系统架构和实现,以及我们的端到端 RAG 解决方案框架设计细节。
演讲提纲:
1. 主流 RAG 的架构设计
2. RAG 实践的痛点总结
3. 如何解决 RAG 面临的问题
4. 开源数据库 Infinity 的系统架构
5. 开源数据库 Infinity 跟各类数据库的对比
6. 展望 RAG 未来的发展
听众收益:
- 了解 InfiniFlow 在各行业实施 RAG 的一手实践经验
- 了解开源 AI 原生数据库 Infinity 的实现细节
- 了解 RAG 技术的能力边界和未来展望
方案痛点:
- AI 原生数据库只是解决 RAG 落地挑战的必备手段之一,除数据库之外,还需要其他数据库之外的措施,才能缓解 RAG 的痛点。另一方面,Infinity 作为一款全新开发的开源数据库,在产品成熟度还有差距,分布式架构还没有准备好,因此需要一定的时间来演进。
by 孟圣智
九章云极DataCanvas
资深架构师by 苏鹏
爱可生
AI 创新事业部负责人大模型已经狂奔了一年多的时间,大家都在探索如何将自己的业务与大模型进行深度结合,而新技术总会面临落地难的问题,在我们内部研发时,我们创新性地设计了多智能体 RAG 方案,并取得了良好效果。在本次分享中,我将向大家介绍 RAG 落地过程中的现状、问题,以及在我们团队内部的最佳实践,希望能够给正在做或计划做 RAG 落地的团队一些启发。
内容大纲:
- RAG 落地过程中的现状和问题
-
技术重点
2.1 信息提取
2.2 信息检索
2.3 RAG 评估
-
爱可生智能化数据库运维实践
3.1 业务背景
3.2 实现方案
3.3 方案效果
-
总结与展望
你将获得:
- 了解当前 RAG 落地现状
- 了解数据库垂直领域的 RAG 落地实践
- 了解 RAG 实现业务改造的基本策略
方案痛点:
- 复杂的多源数据如何进行有效提取与整合
- Agent 如何有效地整合到业务流程中
关注主办方(InfoQ)


联系我们
交通指南
北京国测国际会议会展中心
GUOCE International Convention And Exhibition Center
地址:北京市顺义区临空经济核心区汇海南路6号院20号楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 17310043226

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手