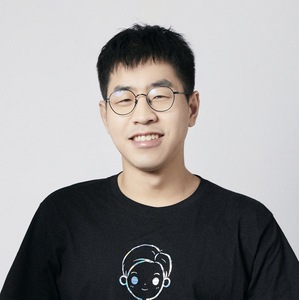
李经纶,Apache Hadoop Committer,火山引擎 EMR 技术专家。长期从事大数据领域存算引擎研发工作。在 Hadoop 的存算一体、存算分离架构、大规模 Hadoop 集群治理等方向上有深入积累。
讲师介绍
议题介绍
地点:钻石厅A
所属专题:下一代 Data for AI 技术架构
演讲:云上数据湖在LLM场景的挑战与解决之道
在过去的几年里,数据湖方案从快速兴起,到被众多客户广为接受。在当下的时间点,数据湖方案已经相对足够成熟,能够应对客户的海量大数据分析场景。随着近期的大模型潮流兴起,又对数据湖方案提出了更大的挑战。例如:传统 HMS 上云的种种问题、Catalog 在大数据和 AI 上的割裂、AI 对 IO 访问模式的新需求、云上构建传统数仓的困难以及生态的问题等等。在本次 Talk 中,我会分享上述挑战,并说明我们的解决之道。
演讲提纲
1. LLM 场景下对传统数据湖方案提出的挑战
- 挑战一:结构化数据和半结构化数据对Catalog提出更高要求
- 传统 HMS 不适合搬迁到云上
- 大数据和 AI 的 Catalog 割裂
- 挑战二:经典对象存储越来越难以满足 LLM 场景海量数据的访问要求
- 大模型场景对 IO 带宽扩展性要求极高
- GPU 资源昂贵,而远程随机 IO 延迟过高影响效率
- AI 生态对 POSIX 语义适配度最高,但是对象存储语义和 POSIX 语义相去甚远
- 挑战三:大数据和AI复杂的场景对通用数据湖的要求越发迫切。
- 云上构建传统大数据数仓非常困难
- 传统大数据数仓缺乏AI生态
- 火山引擎的解决之道及最佳实践
2. 火山引擎的解决之道及最佳实践
- 解法一:火山统一 Catalog 同时管理结构化、半结构化、非结构化、AI 模型数据
- 云上服务化的多租户 Catalog
- 统一 AI 和大数据的 Catalog设计
- 解法二:火山存储加速层针对性优化大数据和 AI 场景的 IO 访问
- 火山大数据加速层实现 IO 带宽扩展性
- 本地数据缓存将随机 IO 延迟降低 2 个数据级 ( 10ms -> 0.1ms )
- TOS fuse 客户端无缝连接 TOS 和 POSIX API
- 解法三:基于开源数据湖格式构建通用数据湖
- 基于 Iceberg 方案构建通用数据湖
- Iceberg 同时桥接大数据 和 AI 生态
3. 经验总结和未来展望
实践痛点
- 对象存储的透明加速在大数据、AI 场景下牺牲了语义层面的兼容
- 元数据扩展性牺牲了元数据的缓存加速
演讲亮点
大模型对数据湖提出的新挑战,包括半结构化、非结构化 、AI 模型数据的管理,以及 IO 访问的针对性优化
听众收益
- 了解在数据场景下很成熟的基础设施体系在 AI 场景下有何本质挑战
- LLM场景在 Catalog、存储、计算方面到底有何实质性的更高要求
- 火山引擎是如何从现有大数据体系演进到适用 AI 场景的大数据体系
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手