以 ChatGPT 为代表的大模型技术变革,正在以非常快的速度不断进步,并深刻影... 展开 >
大模型基础设施与算力优化
会议室:红宝石CD厅出品人:张德兵
- Topic 1
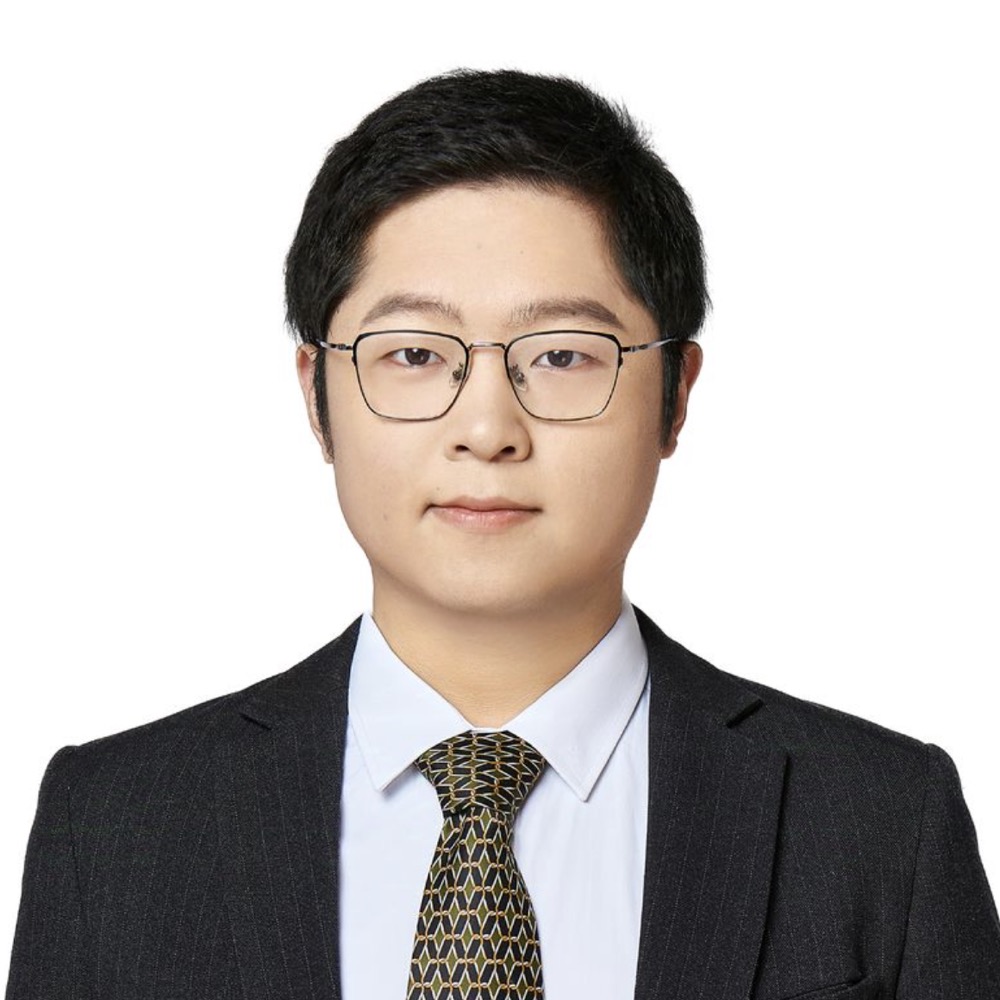
于子淇
小红书 资深技术专家 - Topic 2
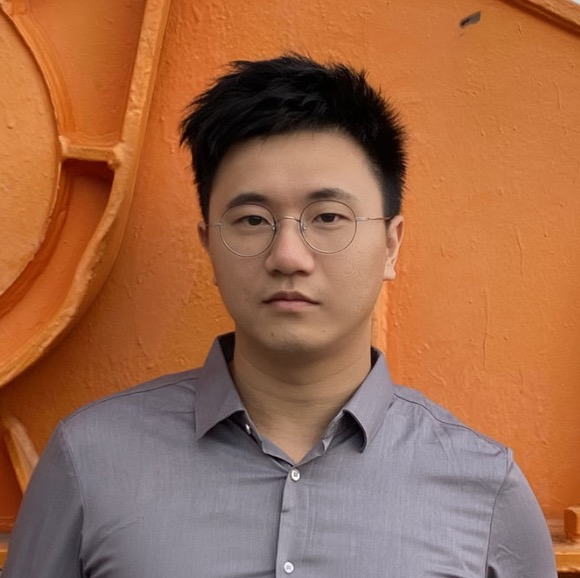
ZOMI 酱
华为 昇腾生态技术首席 - Topic 3
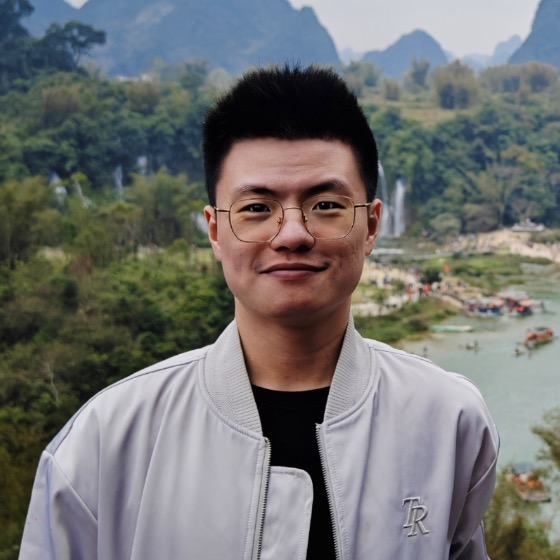
何蔚然
月之暗面 推理系统负责人 - Topic 4
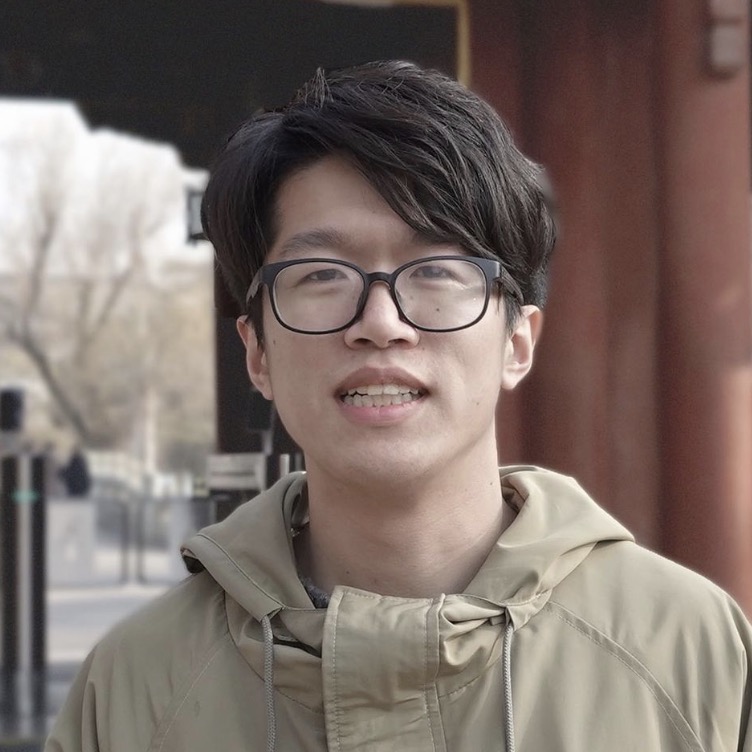
姜慧强
微软亚洲研究院 软件开发工程师 - Topic 5
涂小兵
商汤 高性能计算与推理部高级总监
专题出品人:张德兵
小红书大模型技术负责人
张德兵,小红书大模型技术负责人。曾任格灵深瞳首席科学家,快手多模态智能创作负责人,发表顶级学术论文十余篇,带领团队获得包括国际权威人脸识别竞赛 FRVT 世界冠军在内的多项学术竞赛冠军,长期关注CV/NLP/多模态等相关技术。目前专注于大语言模型和多模态大模型的全链路技术研发和应用。
地点:红宝石CD厅
专题:大模型基础设施与算力优化
以 ChatGPT 为代表的大模型技术变革,正在以非常快的速度不断进步,并深刻影响着各行各业的创新与发展。大模型不仅仅是数据、算法的进步和突破,同时也考验着整个大规模分布式基础设施, 且 Scaling Law 定律在给未来技术突破带来更大想象的同时,也给基础设施和算力优化带来了巨大的挑战。本专题将聚焦大模型基础设施建设与算力优化这个方向,深入探讨如何搭建稳定高效大模型基础设施,提高各类大模型训练推理过程中的 Scaling 的效率和成本,为一线技术工程师和高级技术管理人员提供前沿知识、一手的实践经验和有深度的技术判断。
本专题讨论的方向涵盖:
- 基于 NV 集群的基础设施:在 NV GPU 生态下,如何高效部署大规模集群,并支持高效的分布式训练策略;
- 基于国产芯片的训练和推理:在 NV 芯片供给面临比较大挑战和不确定性的情况下,探讨国产芯片的可行性;
- 大模型大规模训练的挑战:如何持续高效的提升大模型的参数量和训练效率,充分发挥每一份算力和数据的智能;
- 大模型推理性能优化:在大规模应用中,如何持续降低成本,从而真正能支撑起大规模的 AI Native 应用。
通过本专题,参会人员可以了解到最前沿的大模型技术动态,与来自不同行业的专家进行交流合作。我们将结合行业趋势和实践案例,提供深入的行业判断、实用的技术策略和创新的解决方案,帮助从业者更好地解决这些难题,更好地推进大模型技术探索的边界和释放大模型技术的潜力。
by 于子淇
小红书
资深技术专家多模态大语言模型(Multimodal Large Language Model,MLLM)从大规模预训练中获得图文理解、创作、知识、推理、指令遵循等能力(Capability),通过可监督微调(Supervised Finetune,SFT)激发对应的能力。除此之外,我们还希望模型输出具备特定的风格、符合人类偏好、对齐人类价值观,因此需要引入基于人类的反馈信号的强化学习方法(Reinforcement Learning from Human Feedback),进一步优化模型效果。PPO(Proximal Policy Optimization)算法是 OpenAI 在 RLHF 阶段采用的算法。PPO 算法中涉及到多个模型的协同训练和推理,设计和实现一套高效、准确的 RLHF 训练系统,是关键挑战之一。
本次演讲主要介绍小红书大模型团队自研 MLLM RLHF 训练框架的实现以及性能优化。通过训练和推理的混布调度优化等实现,保证极致的性能,希望能给大家带来一些帮助。
演讲提纲
1. RLHF 的背景
- PPO 算法
- 训练原理
- 效果评估
2. RLHF 框架设计和优化
- 基于 actor/critic 的 offload 同构组网架构
- 基于 Ray 的训推一体的训练调度优化,异步算子并发执行优化
- 精度对齐:RM 精度要求
3. 推理引擎优化
- 训推一致性
- Medusa 提升采样效率
4. 实践案例与展望
- 多模 LLM 展示
- 未来计划
实践痛点
- RLHF PPO 算法的资源消耗复杂度过高
- RLHF 训练 PPO 精度的敏感性
演讲亮点
- 收敛速度超越 trlx 1 倍
- 训练速度超越 openrlhf 1 倍
听众收益
- RLH F对于 PPO 架构上的优化
- RLHF 精度细节上的踩坑点
by ZOMI 酱
华为
昇腾生态技术首席万卡集群在执行大规模网络模型训练任务时负载重,受到功耗挑战、网络拓扑、可靠性和故障恢复、并行计算、成本分析等多方面的挑战。越来越多开发者希望更好地驾驭万卡集群,提升大规模网络模型在万卡集群训练的集群整体性能。本议题旨在深入探索如何在万卡昇腾 NPU 集群上,基于业界典型 AI 框架和 MindSpeed 分布式并行加速库,结合网络拓扑优化算法和华为开源 HCCL 集合通信库协同优化,将深入剖析万卡集群训练过程中涉及的技术原理和难点,探讨万卡集群训练的性能和稳定性策略,最后结合案例讲解面向万卡集群性能提升的实践。
演讲提纲
1. 万卡集群的核心技术栈
- 分层万卡集群的技术栈及核心场景
- 智算场景下分布式加速库相关的使用新趋势
2. 万卡集群可观测数据采集和处理的需求和技术难点
- 根据智算服务部署、数据规模、多租的特点,如何稳定低实现万卡集群训练大模型
- 如何应对大规模智算集群性能提升
3. 万卡集群的性能提升架构设计
- 整体设计目标与愿景
- 围绕性能提升、稳定性、生态能力等方面,展开介绍核心架构
4. 万卡集群的未来展望
实践痛点
- 如何有效实现秒级别的快速恢复能力,提升大模型训练的集群稳定性
- 如何确保在网络拓扑等资源约束下提升集群算力可用率 MFU
- 如何与业务场景相结合,在大模型训练提升性能场景下保持训练精度
演讲亮点
- 深入探索面向万卡集群训练大规模模型的技术架构,该架构以卓越性能为核心,依托高稳定性的系统设计,实现万卡集群性能提升
- 贴近实际大模型训练的业务场景,超大规模模型 LLM/MLM 进行训练的技术实践,包括不限于分布式并行算法、集合通信优化算法等
听众收益
- 了解万卡集群训练的核心技术与发展趋势
- 结合华为昇腾相关技术,深入到万卡集群训练核心技术原理和实现细节
- 帮助听众理解万卡集群训练的技术挑战,集群性能提升的未来发展方向
by 何蔚然
月之暗面
推理系统负责人随着大型语言模型的社会影响力日益增强,相应的人工智能产品用户基数也在迅速扩大。目前,AI产品发展的一个主要挑战是如何在有限的计算资源下,有效应对日益增长的用户需求。本议题从实际业务出发,探讨在固定集群资源的条件下,通过采用单点和分布式推理架构,提升集群处理大规模请求的能力,过程中遇到的挑战以及我们的解决策略,希望能给大家带来一些帮助和思考。
演讲提纲
1. 大规模推理挑战
- 优雅的集群过载
- 超长上下文性能挑战
- 故障定位与自动运维
2. 单点性能优化
- 混合并行策略
- 长上下文推理优化
3. 分离式架构 Mooncake
- 设计场景 —— SLO vs MFU - 分离式架构设计
- 集群调度策略、热点均衡
- 开源计划
4. 未来展望 - 硬件能力展望
- 更细粒度的池化分离
- 分离式内存系统
实践痛点
- 生产环境高负载下有效地过载
- 线下测试与线上负载的解耦
演讲亮点
- 经过实际生产环境大规模验证的分离式推理系统,面对真实线上负载实现性能提升
- 从实际业务出发,分析推理系统设计决定和关键技术
听众收益
- 了解分离式架构在实际生产环境中的挑战与发展趋势
- 了解未来硬件/算法演进方向
by 姜慧强
微软亚洲研究院
软件开发工程师Long-context LLMs Inference的prefilling 阶段由于 Computation bottleneck 造成的长时延 (单卡 A100,1M 8B 约 30 分钟) 给 Long-context LLMs 的应用造成了困难。而 Attention 尤其是Long-context Attention 实际上是非常稀疏且动态的。利用这种动态稀疏性,我们将 Long-context Attention 存在的动态稀疏归纳成三种 Pattern,通过离线搜索出每个 Head 最优的稀疏Pattern,并利用很小的 overhead 在线确定动态稀疏 index,再结合动态稀疏编译器 PIT 和 Triton 进行高效的动态稀疏 GPU 运算,产生实际加速比。我们对市面上主流的 Long-context LLMs , like LLaMA-3-1M, GLM-4-1M, Yi-200K, Phi-3-128K, Qwen2-128K 在RULER,InfiniteBench,Needle Test,LM 等任务中进行了测试,结果显示其具有几乎相同的性能。
本次演讲将主要跟大家分享 LLMs 推理算法侧优化方法,包括量化,剪枝,模型架构优化,FFN 动态稀疏计算等方面的研究和实践。
演讲提纲
1. LLMs 推理算法侧优化方法讨论:如量化,剪枝,模型架构优化,FFN 动态稀疏计算等
2. 长文本 LLMs Inference 遇到的一些挑战
- Attention 结构平方复杂度导致的 Prefilling 阶段较高的 TTFT
- 解码阶段 KV cache 存储压力,计算要提供一个合理 TTFT 的 API 服务理论上需要对 Attention 进行多少倍加速
3. 研究思考
- 优化 Long-context LLMs Inference 的相关方法,包括 training from scratch 和 training-free 两大类方法。
- Attention 是动态稀疏的,Attention 的动态稀疏在空间上具有聚集性,呈现出三种不同的 pattern;
4. 解决方案
- MInference、decoding 和多轮推理
- 实现细节,包括 GPU Kernel 实现
- 评测结果,包括有效性和高效性
5. 总结和未来展望
实践痛点
- 对于短文本场景,利用动态稀疏性可能会引入 overhead,获得的加速比较低
演讲亮点
- LLMs 推理算法侧优化方法,包括量化,剪枝,模型架构优化,FFN 动态稀疏计算等方面
- 首个有效降低长文本大模型推理中预填充阶段成本并保持性能的解决方案
- 协同设计的算法和系统,能够在无需训练的情况下实现端到端加速
听众收益
- 了解算法侧优化 LLMs Inference 的思路和 Long-context LLMs inference 前沿研究动向和潜在的优化思路
by 涂小兵
商汤
高性能计算与推理部高级总监随着人工智能领域的发展,越来越复杂的大型语言模型正在被广泛应用于各个行业,这些模型的推理需求也随之大幅提升。鉴于国际供应链的持续不确定性,我们或将面临因依赖英伟达芯片而产生的潜在风险与挑战。为此,我们采用了英伟达和国产化芯片混合的异构分布式推理方案,该方案将充分发挥两种芯片的优势,确保系统的高效性和稳定性,同时减少对单一供应链的依赖,提升推理能力和自主控制能力。
推理优化已经不局限于算子层面,需要站在系统全局的角度分析并解决问题,需要设计者有全面的技术积累(分布式、算法、算子优化、量化),需要站在异构大集群的背景下思考问题。本次演讲将分享商汤高性能计算与推理团队自研的异构分布式大模型推理系统遇到的挑战以及实现,希望能给大家带来一些帮助和思考。
演讲提纲
1. 异构分布式大模型推理系统优化
- 大模型推理已经演变成一项复杂的系统级别优化
- 适配不同芯片的分布式异构推理系统
- 模型快速加载,推理 POD 快速拉起
2. 多元算力芯片推理优化
- 推理芯片评测选型
- 多元算力芯片深度推理优化
3. MOE 的推理优化
- MOE 的兴起
- MOE 的推理优化方案
- MOE + MLA 的优势
4. 大规模异构推理集群的未来展望
- 更大规模的异构集群的管理调度
- 高效的多模态融合推理
实践痛点
- 异构芯片之间的通信交互优化
- 如何快速的进行多元算力芯片选型
演讲亮点
- 深入剖析多样化芯片适配优化方案
- MOE + MLA 的深度推理优化方案
听众收益
- 了解多元算力芯片技术发展趋势
- 了解大模型推理系统的现状和演进方向
关注主办方(InfoQ)
联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手