在技术迅猛发展的今天,软件系统的稳定性和可靠性已成为互联网公司的生命线。近年来,... 展开 >
线上可靠性工程
会议室:钻石厅C出品人:党受辉
- Topic 1
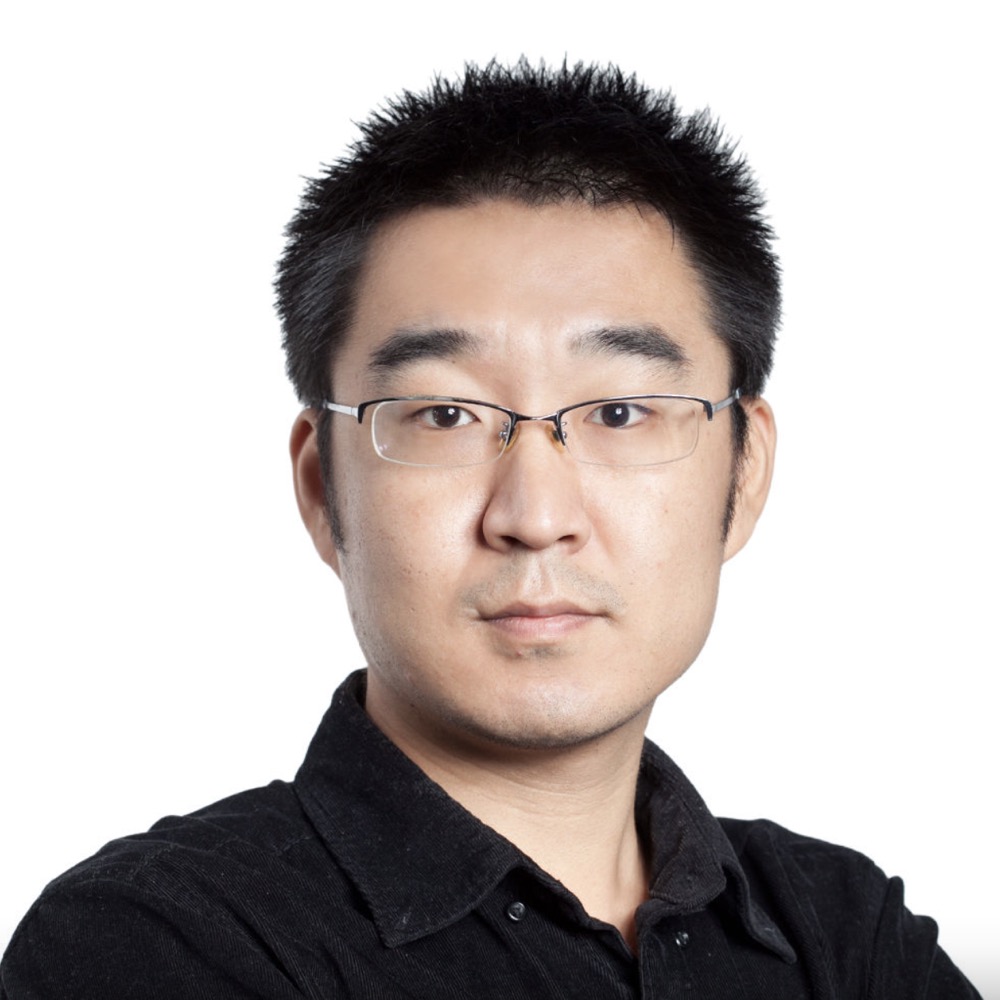
杨军
腾讯 IEG 技术运营部 SRE 总监 - Topic 2
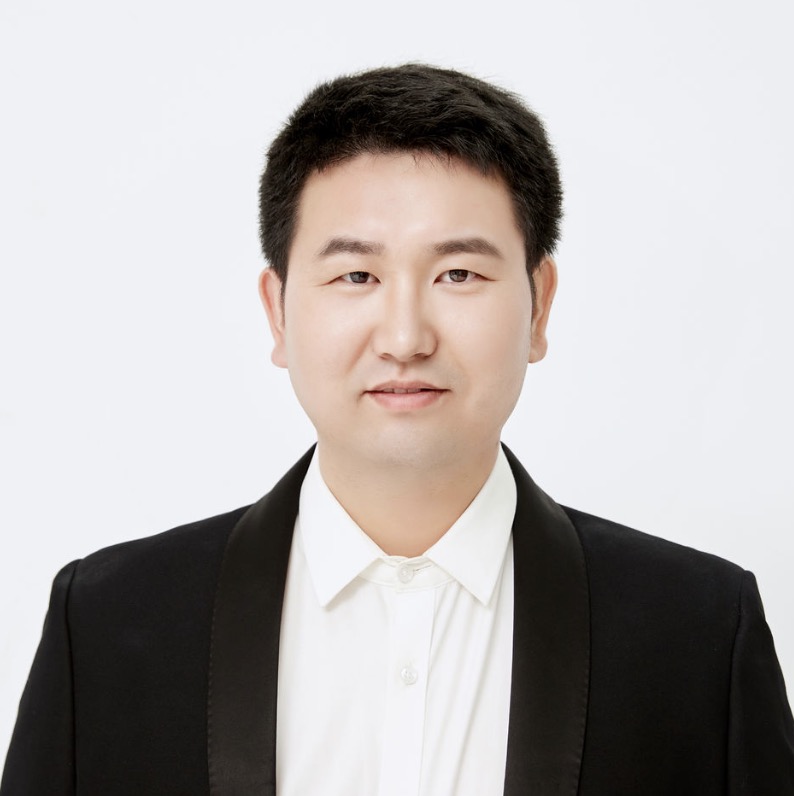
刘凯宁
蚂蚁集团 SRE 技术专家 - Topic 3
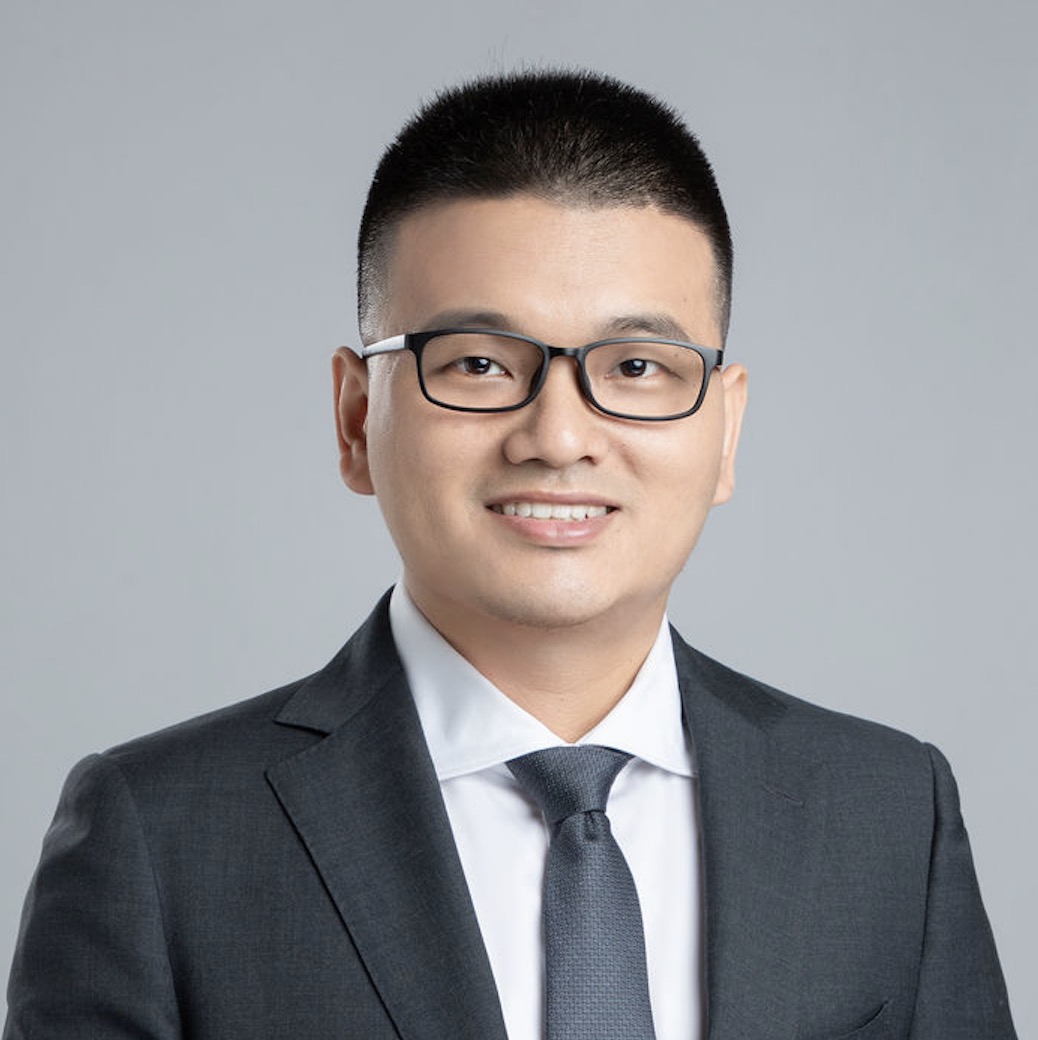
周昕毅
携程 云原生研发总监 - Topic 4
刘昊
哔哩哔哩 基础架构部平台工程负责人
专题出品人:党受辉
腾讯 IEG技术运营部助理总经理,专家工程师
党受辉,腾讯 IEG 技术运营部助理总经理,专家工程师。腾讯游戏 SRE 负责人,负责研发工具链、运维自动化、线上可靠性等研运一体基础设施平台蓝鲸智云;信通院 SREelite《SRE 实践白皮书》作者之一。
地点:钻石厅C
专题:线上可靠性工程
在技术迅猛发展的今天,软件系统的稳定性和可靠性已成为互联网公司的生命线。近年来,多家知名互联网公司遭遇的软件系统故障,不仅影响了用户体验,也暴露了在可靠性工程和业务连续性规划方面的不足。这些事件促使服务提供商、用户及整个行业开始深刻反思,并加强在这些领域的投入和改进。
软件系统的稳定性问题不仅给用户带来不便,还可能导致企业声誉和经济损失。随着对服务质量要求的提高,线上可靠性工程逐渐成为互联网公司的核心竞争力之一。
线上可靠性工程是代码发布到生产环境之后的技术运营过程,是代码产生使用价值的环节,很多公司的 SRE 工程师会围绕这个环节展开各类工作,例如 SLI/SLO 管理、故障应急、用户体验优化、618之类的重大节点技术保障、容量管理及成本优化、混沌工程、综合算力调度、业务全生命周期工具建设等。
如果线上可靠性工程出现问题,那么前期在应用产品设计、研发测试、发布变更等环节的所有投入都可能变得毫无意义。
本专题将从 SRE 视角保障业务线上可靠性为出发点,邀请不同公司的稳定性技术专家,分享他们在各自的业务场景中的可靠性/ 稳定性保障的实践经验,共同探讨线上可靠性工程的问题的解决思路。
by 杨军
腾讯
IEG 技术运营部 SRE 总监除了从架构、容灾、监控的角度提升可靠性之外,用户体验的波动也影响着用户对线上系统稳定性和可靠性的感知。在全球网络环境下,云服务商众多,网络延迟多变,成本计算复杂,影响因素难料,单纯依赖人的选择应用的部署节点,已经不能完全满足业务在用户体验方面的要求。
腾讯游戏 SRE 团队,利用 AIOPS 能力,从数据工程角度,通过分析全球网络数据,云服务商数据,用户访问模拟等方式,建立一套用户体验评价体系,找到了一种相对通用的全球网络环境下的用户体验优化实践方案,为海外业务发展提供关键决策。这是一套实践方案不仅适用于游戏行业,也同样适用于其他互联网行业的用户体验优化方案。
演讲提纲
1. 真实的全球网络环境到底什么样?
- 复杂的全球网络线路
- 每天都可能会变化的路由
- 非技术原因网络波动
- 断崖式的网络质量变化
2. 腾讯游戏全球网络环境优化实践
- 游戏战斗服智能选择场景介绍
- 如何通过数据模拟玩家行为?
- 数据采集
- 匹配重现
- 迭代最优解
- 如何通过数据工程验证效果?
- 增加测速服务器
- 模拟匹配
- 模拟对战
3. 非游戏业务的应用实践
- 此方法的本质
- 通用流程
- 定制与适配
4. 经验总结和未来展望
- 在业务逻辑上寻找优化点
- 降低成本,提升通用性
实践痛点
- 数据存储与分析成本成本高
- 分析结论在实际应用中的时效性
演讲亮点
- 基于业务实际数据的真实实践案例
- 用数据工程的方法改善玩家体验
听众收益
- 了解全球网络现状
- SRE 团队的 AIOPS 能力需要具备哪些基础设施
- 学习数据模拟和数据验证工程的实践方法
- 游戏体验优化方案如何应用在非游戏业务
by 刘凯宁
蚂蚁集团
SRE 技术专家线上故障到底是什么?谁应该为线上稳定性负责?如何评价应急过程到底是做的好还是不好?
近年来国内外多家知名公司都出现过重大故障,线上可靠性变得越来越重要,同时由于不同公司的主营业务、企业性质、公司规模等差异较大,稳定性保障思路和落地方案也是百花齐放。但有一些最核心、最本质的问题还是急需被定义和讨论清楚。
本次分享主要介绍蚂蚁的故障应急体系,通过实际的故障案例来简要介绍故障定义、组织阵型、平台能力、应急流程、应急评价等内容,并分享 AIOPS、LLM 大模型等能力在应急定位中的落地情况,以期能够回答业务稳定性保障要“做什么”、“谁来做”、“怎么算做得好”等问题,希望能给大家带来一些新的保障思路。
演讲提纲
1. 引子:一个真实的线上故障
- 是怎么发现的?
- 是怎么定位根因的?
- 是怎么止血的?
- 是怎么复盘的?
2. 蚂蚁故障体系构建
- 故障的定义、分类,以及对应的平台能力和评价指标
- 故障数据如何驱动日常稳定性保障工作的开展和能力演进
3. 蚂蚁应急体系构建
- 应急的目标和各阶段的数据指标定义,组织阵型设计和对应的评价指标
- 应急各阶段的目标和平台能力支撑
4. 一个线上故障的全生命周期
- 从故障定义、故障注入、故障发生、故障发现、故障响应、故障定位、故障止血、故障复盘全生命周期进行详细的分析,并尽可能多的展示实践效果
5. 未来已来
- AIOPS 助力应急定位快速发现故障原因的方法
- 通过 LLM 加速故障复盘及 ACtion 跟进
实践痛点
- SRE 团队与开发团队、质量团队在稳定性保障事项中的目标、分工、合作方式,会因各公司的组织结构差异而有非常大的不同,在落地的过程中难免会有一些冲突
- 故障应急的根因定位能力非常依赖公司的基础设施基建,AIOPS 和 LLM 在落地的过程中会不可避免的遇到定位准确率低、定位结果方差大的问题
演讲亮点
- 以业务稳定为中心的、以风险事件及线上故障数据为驱动的、以 SRE 能力提升和平台能力演进为路径的技术风险整体防控方案
- AI 大模型在应急根因定位、应急快恢决策、应急 Action 跟踪等方面的能力实践和未来展望
听众收益
- 了解蚂蚁集团风险事件和线上故障管理的设计思路及现有能力
- 了解蚂蚁集团应急全流程的设计思路、平台能力、机制流程
- 了解典型故障应急的全流程应对及处理方案
- 探索 AI 大模型能力如何落地到故障应急领域
by 周昕毅
携程
云原生研发总监在 AI 浪潮冲击之下,很多 IT 企业的 SRE 团队都在尝试落地 AIOps,通过 AI 进行运维流程洞察、AI 辅助运维决策、AI 自动根因分析等,提升 SRE 工作效率,进而提升网站稳定性。越来越多的 IT 企业选择云原生架构进行系统部署,交付和运维管理效率得到了提升。但这也致使系统的可观测体系变得越来越复杂,监控和日志数据膨胀的速度也远超大家的预期。可观测性数据的三剑客(Metrics、Tracing、Logging )是 SRE 工程师处理监控、告警、问题排查等需求的重要依赖。如果说标准化是自动化运维流程落地的压舱石、那么可观测性数据的质量就是 AIOps 落地的最重要拼图,没有高质量运维监控数据,AIOps 只能停留在纸上谈兵。
本次演讲主要携程对内部可观测平台进行架构升级的工程实践,涵盖 Metric 和 Logging 数据进行统一治理、为 AIOps 落地提供数据和工具支撑;最后会介绍云平台团队通过使用 AI 工具来提升平台运维效率的真实案例,希望能给大家带来一些帮助。
演讲提纲
1. 携程可观测性平台现存问题
- 监控指标只增不减
- 日志场景只增不减
- 非关键的指标占用大量的计算存储资源,核心指标的实时性得不到保障
- 各类监控工具烟囱林立,资源没有打通,无法统一治理
2. 数据治理实践
- Metrics 数据治理
- Logging 数据治理
- 统一监控 Agent 落地实践
3. 升级架构助力 AIOPS 落地
- 通过物化视图等技术实践,提升数据时效性
- 通过分层存储技术将数据冷热分离, 降低丢失率,提升数据可靠性
- 通过建设数据质量度量工具,提升数据准确性
4. 实践案例与展望
- 使用 AI 工具来提升平台运维工作效率的案例
- 可观测平台架构升级的问题总结和未来展望
演讲亮点
- 可观测性平台架构升级的实际案例,重在实践
- AIOPS 落地的前置依赖
实践痛点
- 监控领域随着时间推移,会产生大量的老旧系统、老旧数据,相关遗留问题,也不是仅靠一次架构升级可以完全解决,需要持续投入精力做治理;
- 如何与业务实际需求结合,不断调整技术方案和需求适配,保障最核心的链路;
- 可观测性数据的价值挖掘,数据实时性和准确性需要放在第一位
听众收益
- 主流的监控告警、可观测性工具选型
- 了解监控和日志数据持续膨胀的治理方案
- AIOps 依赖的可观测性数据集质量保障体系
- AI 工具如何协助处理琐碎的日常运维工作
by 刘昊
哔哩哔哩
基础架构部平台工程负责人近两年,随着企业降本增效的持续深化,企业 IT 服务的稳定性受到了一定的冲击,这点从微博热搜上也能初见端倪。如何确保过往企业在服务高可用、业务多活和基础架构容灾等方面的投入是真实有效的,当保障故障和灾难来临时,业务连续性不受过重损失?这是当下诸多公司面临的一大挑战。
本次分享将从 B 站的容灾演练体系构建入手,逐步拆解体系,带大家深入了解 B 站在容灾演练上的组织阵型搭建模式、运营机制设定方法以及容灾产品能力建设,最后通过结合业务实践为大家展示 B 站是如何通过容灾演练体系来支撑业务多活、大促保障和研发质量交付等多个环节的,希望能为大家带来一些稳定性保障的新思路。
演讲提纲
1. 新形式下的稳定性挑战
- 分析当下基础设施层故障频发、业务高可用手段失效的原因
- 如何破局?主动出击,以演带练
2. 轻量级容灾演练体系构建
- 组织阵型搭建:横向容灾演练推进小组、基础架构
- 运营机制流程:如何围绕演练风险分,通过容灾演练专项牵引基础架构和业务 BU,有效推进演练工作
- 容灾产品能力:从混沌引擎能力演进、容灾场景定义、演练全生命周期管理、演练可视化、智能演练防护来详细介绍容灾相关产品能力
3. 业务场景实践
- 业务多活场景:借助容灾演练能力,确保业务多活的有效性
- 活动大促场景:活动场景的容灾演练点快速挖掘和针对性演练
- 需求交付场景:在常态化的需求交付阶段,助力质量保障部门快速完成服务依赖演练
4. 总结展望
- 总结 B 站的实践效果和过程反思
- 未来如何通过 LLM 挖掘更多的容灾场景,提升容灾演练的效率
实践痛点
- 如何有效的定义和模拟容灾演练场景
- 如何组织多 BU 和多职能角色进行项目落地
演讲亮点
轻量级的容量演练体系设计思路和实践参考
听众收益
- 了解 B 站如何轻量级在组织内部常态化实施容灾演练
- 了解 B 站容灾演练的技术演进路线、组织搭建模式和运营机制流程,掌握体系化的解决方案
关注主办方(InfoQ)
联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手