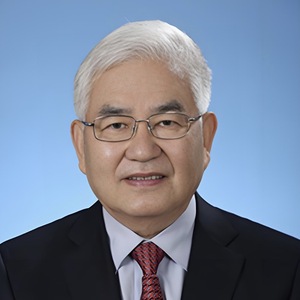
郑纬民,教授,博士生导师,中国工程院院士。1970 年毕业于清华大学自动控制系,1982年获清华大学计算机科学与技术专业硕士学位。曾任中国计算机学会理事长。2019 年当选中国工程院院士。主要学术方向为网络存储系统。长期从事网络存储系统科学研究、工程建设和人才培养,在存储系统扩展性、可靠性和集约性等科学问题和工程技术方面,取得了国内外同行认可的创新性成果;研制的网络存储系统、容灾系统和自维护存储系统在多个重大工程中发挥了重要作用。获国家科技进步一等奖1项、二等奖2项、国家技术发明二等奖1项,何梁何利科技进步奖。
讲师介绍
议题介绍
地点:中华厅
所属专题:主题演讲
演讲:关于人工智能大模型的几点思考
2025 年,人工智能加速从单模态向多模态发展,大模型在各行业广泛落地。在此进程中,人工智能大模型生命周期的各个环节对算力和存储产生了爆发式需求。数据获取时,海量小文件存储面临挑战;数据预处理开销成为大模型训练瓶颈;模型训练任务负载重、硬件出错概率高;模型微调需平衡数据规模与质量;模型推理存在算力困境。
这些问题该如何解决?在当前大模型产品中又如何落地相应解决方案?本次演讲将深入剖析,并将分享 Kimi 幕后的大模型推理架构 Mooncake。Kimi 从初期频繁算力扩容仍宕机,到如今能平稳承载高速增长的流量,Mooncake 发挥了关键作用,且该成果已于近期荣获第 23 届 USENIX 文件与存储技术会议(FAST25)最佳论文奖。
演讲提纲
1. 2025 年 AI 大模型的两个特点
- AI 大模型从单模态迈向多模态的发展趋势
- AI 大模型在各行业落地带来的变革
2. 人工智能大模型生命周期的五个环节
- 数据获取:收集不同模态海量文件时,面临海量小文件存储难题,如元数据管理困难、现有文件系统难以满足需求等
- 数据预处理:对分布式技术提出挑战,其开销逐渐制约大模型训练,需创新数据处理方式
- 模型训练:检查点文件读写对存储系统要求高,现有策略性能不佳,需优化存储策略以应对硬件错误和大规模数据存储需求
- 模型微调:精调垂域模型需要可控算力,同时要平衡数据规模与质量,以提升模型在特定领域的性能
- 模型推理:实时处理用户请求,需要稳定可靠算力,当前面临算力困境,需探索新的推理架构和优化方法
3. 构建国产智算系统的核心基础软件
- 清华大学 “八卦炉” 智算系统解析:介绍 “八卦炉” 在国产超算上的应用,以及对多种国产芯片的支持和性能优化成果
- Mooncake——Kimi 幕后的大模型推理架构:剖析 Mooncake 以 KVCache 为中心的架构设计、工作原理和优势,以及其在提升 Kimi 性能方面的关键作用
4. 三步让企业明确如何利用 AI 大模型
- 指导企业通过明确关键问题
- 评估数据质量
- 判断人力与 AI 的适用性,以及选择和微调模型等步骤,有效利用 AI 大模型实现转型发展
听众受益
- 清晰把握大模型的技术发展趋势
- 全面熟知人工智能大模型开发生命周期各环节的问题与解决方案
- 深入了解 Kimi 背后的大模型推理架构
- 掌握判断企业是否适合利用 AI 大模型转型的方法
本专题下其他演讲
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手