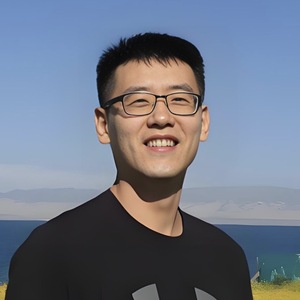
浙大硕士毕业后加入网易,先后参与网易 UU 网游加速器、易信、云信等项目。现任网易云信音视频技术负责人,全面负责实时音视频、流媒体 AI 处理、AI数字人、直播、点播、WE-CAN 全球传输网等项目的架构设计与研发。对音视频、AI 技术在流媒体的应用、高性能服务器以及网络传输等领域均有多年的工作与项目经验。
讲师介绍
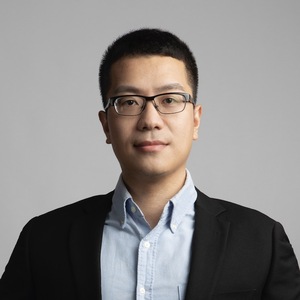
专题演讲嘉宾:吴桐
网易云信音视频技术负责人,流媒体首席架构师
议题介绍
地点:中华厅 1
所属专题:AI 重塑行业运作模式
演讲:多模态对话引擎:从语音表征到 LLM 微调的架构演进和技术实践
面对行业数据孤岛和交互低效的挑战,企业智能化升级亟需突破传统技术瓶颈。数据孤岛现象导致企业内部信息流通不畅,各部门数据难以整合,严重影响决策效率和业务协同。同时,现有交互系统响应迟缓,无法满足实时性需求,尤其在客户服务和智能交互场景中表现突出。
为解决这些问题,云信提出创新方案,融合声纹、情感、环境音等多维信号,结合大语言模型的动态微调能力,实现个性化对话理解。这种融合方式不仅提升了交互的自然度和准确性,还支持互动、打断和交互识别,显著改善用户体验。此外,通过“ LLM+ASR+TTS ”以及 LLM 实时交互的混合模式,企业能够快速部署符合自身场景的 AI 智能体。这种模式在教育 AI 口语教练、医疗问诊辅助、社交陪聊与助聊、AI 智能客服等多个场景中实现落地应用,展现了强大的跨模态数据协同能力。
本次分享我将深入解析这些技术背后的实现原理,探讨从语音对话到智能体对话的技术演进路径,并展望脑机接口、3D 空间音频等前沿技术的发展方向。
演讲提纲
1. 大模型带来对话交互变革
- 传统语音系统在语义理解、场景适配、多模态协同的局限性
- 大模型驱动的多模态能力重构人机交互逻辑
- 对话式 AI 语音智能体技术的突破与创新
2. 技术引擎:大模型融合的对话式语音 AI 技术架构
- 多模态语音基座:端到端语音表征学习 + 大语言模型微调框架
- 动态场景感知:声纹/情感/环境音的多维度信号融合
- 推理加速:流式语音处理与模型蒸馏的工程优化
- 语音-语义联合建模:基于 Prompt 的上下文对话理解增强
- 噪声场景鲁棒性:对抗训练与声学特征解耦技术
- 个性化交互:用户画像实时嵌入的动态参数微调
3. 场景落地:跨行业应用实践与教训
- 教育场景:AI 口语教练技术解析与应用
- 医疗领域:智能问诊辅助系统
- 社交领域:基于大模型的智能伴聊、助聊
- 嵌入式场景:对话式 AI 在 IoT 场景的效果优化
4. 未来展望:多模态交互的无限可能
- 脑机接口与语音 AI 的融合探索
- 3D 空间音效与 AR 场景的沉浸式交互
- 对话式 AI 与硬件结合的多种展望
您认为,这样的技术在实践过程中有哪些痛点?
- 不同大模型、同一大模型在不同场景下的调优问题非常复杂,训练优化问题
- 对话进程中,AI 对其他人声识别造成的对话中断问题(AI 对话进行打断机制)以及多人对话的选择性识别问题
- AI 对 Prompt 的理解程度带来的角色塑造和对话问题
- AI 对话相应的实时性,不同场景下的延迟思考与实时响应的平衡和技术优化问题
演讲亮点
- 分享对话式语音 AI 智能体的实现逻辑
- 提供不同行业的应用实践案例
- 大模型结合语音训练的经验和教训
- AI 在音视频技术升级上的实践
- 对话式 AI 在社会公益和社会价值的落地实践
听众收益
- 了解教育、语聊、社交、客服等不同场景下的 AI 落地经验
- 了解大模型与对话式 AI 结合的技术细节和实现路径、教训
- 了解对话式 AI 在硬件领域(AI 玩具)的落地实践
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手