高欢,快手快意多模态基座模型负责人,主要负责AI生成场景背后的多模态理解研发工作,深度参与快手多个 AIGC 算法技术落地。目前的主要研究兴趣包括:多模态大语言模型、视频理解编码器、大语言模型,曾在 NeurIPS、ACL、AAAI、ECCV、ICDE 等顶级学术会议上发表多篇论文。
讲师介绍
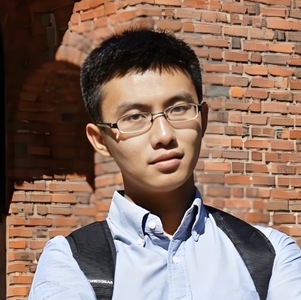
专题演讲嘉宾:高欢
快手多模态模型高级算法专家
议题介绍
地点:中华厅2
所属专题:多模态大模型及应用
演讲:多模态理解技术在短视频上的思考与应用
本次演讲我将围绕社交短视频理解任务展开。首先介绍多模态理解技术的发展现状,讲述应用产品视角和学术定义视角的多模态理解能力,并介绍业界主流的技术方案。随后将围绕社交短视频的特点和痛点展开,介绍一套经过验证的解决方案流程。最后,将围绕两个近期的热门多模态方向进行讨论:视觉 R1 和 Benchmark 。
演讲提纲
1. 多模态技术的发展
- 多模态技术的应用产品
- 多模态理解任务分类:感知、认知、定位、推理
- 模型结构:多模态特征融合、动态分辨率处理
- 长视频理解挑战和解决方案:帧采样和 Token 丢弃
2. 社交短视频理解的难点
- 社交短视频的特殊性
- 社交短视频理解任务
3. 社交短视频理解任务的解决方案
- 数据飞轮:社交短视频并不是脏数据
- 信息堆积方案:非端到端,有利有弊
- 视频 Token 压缩方案:内容完整性非常重要
- 效果对比
4. 未来与展望
- 视觉 R1,真的想好要推理什么了吗?
- Benchmark 比比皆是,足够衡量多模态理解能力吗?
您认为,这样的技术在实践过程中有哪些痛点?
- 忠实于内容和联想推理,在视频理解上是一对跷跷板的存在。剪辑特效类视频与自然事件类视频是影响模型偏好的两个不同方向。基于自己的业务场景,如何找到最佳的平衡点,是最重要的痛点
演讲亮点
- 多模态技术飞速发展,“刷榜秘籍”已经漫天都是,但本次演讲不教大家如何刷榜,而会与大家交流如何从实用的角度看待多模态理解问题
听众收益
- 交流多模态理解上更有意思和有价值的工作方向
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手