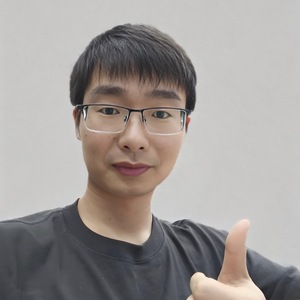
郭刚平,字节跳动基础架构可观测团队研发工程师,多年可观测领域从业经验,在可观测系统架构设计、大规模数据链路性能优化、稳定性保障方面有比较多的实践经验,现任火山引擎托管 Prometheus 产品研发负责人。
讲师介绍
议题介绍
地点:兴盛宴会厅
所属专题:加速与反哺:AI 时代的可观测实践
演讲:火山引擎 Prometheus 面向大模型场景的优化实践
近年来,AI 技术发展迅猛,相关产品和解决方案已深入社会经济的方方面面,成为驱动创新、提升效率的重要引擎,AI 应用的其可观测技术也成为了行业关注的一个焦点,Prometheus 作为云原生监控领域事实标准,被广泛应用于 AI 大模型和智能驾驶领域的可观测任务,用于实现最佳性能及减少故障。本次演讲我将分享火山引擎托管 Prometheus 在服务 AI 领域客户(如火山方舟)过程中,积累的保障 AI 推理服务时序数据库稳定性的关键技术实践,希望能给听众带来一些启发和思考。
演讲提纲
1. 大模型场景指标观测需求和挑战
- 推理训练场景指标大规模高基数问题
- 方舟大量接入点带来十亿级别的时序基数
- 自动驾驶云大量短时训练任务引起高基数
- 单指标高基数导致大查询
- 在线推理服务扩缩容调度需求
- 流量高峰需要快速扩容对查询可用性的要求
- K8s 基础的 HPA 不满足要求,需要基于 GPU 等自定义指标来作为扩缩容依据
- 推理服务流量亲和性调度对指标实时性的要求
- 大流量租户 Qos 保障需求
- 写入链路
- 网关共享集群导致的租户间写入相互影响
- 查询链路
- 单一租户大查询影响同一集群下的其他租户可用性
2. 新时代下 Prometheus 核心演进思路
- 端到端稳定性保障
- 集群粒度、租户粒度、查询粒度
- 写入水平扩展、统一聚合查询,支撑大规模数据量
- 原地数据分析 & AIOps 数据探查
- 大规模场景下大模型的监控架构
3. 火山引擎托管 Prometheus 优化实践
- 高基数问题
- 高流失率高基数时序场景下的短时查询优化
- 查询预聚合降低基数
- 与业务侧对齐打点最佳实践方案
- 在线推理调度对指标可用性&实时性的需求
- 近用户集群侧实时指标缓存
- 大流量租户 Qos 保障
- 写入链路
- 大流量租户网关自动拆分独立分组
- 查询链路
- 大查询发现和治理
- 面向" Never OOM "的查询组件设计
- Shuffle Sharding 查询
- 聚合工作区 突破单集群规模上限
- Sharding 写入 & 聚合查询
- 写入链路
4. 大模型场景实战效果
- 稳定支撑火山引擎方舟十亿级时序读写,实现业务零改造低成本水平扩展
- 近集群侧实时指标,助力在线推理服务 TTFT 延迟降低 40%
5. 未来与展望
- 更高性能、更低成本的下一代时序存储
- Inplace 时序数据分析能力
- AIOps 能力内外复用上云
实践痛点
- 时序的高基数问题是个持续易反复的问题,因为生产端是不受控的,如何在保障系统稳定性的前提下尽最大努力保障用户的可用性和体验是一个持久战,不仅仅是技术层面,也需要用户侧的宣贯和配套的基础建设来减少不合理使用姿势
听众受益
- 了解端到端构建稳定的监控方案
- 了解大规模场景下大模型的监控架构实践
- 了解 Prometheus 创新性技术落地
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手