字节跳动 AI Platform 部门技术专家,扣子罗盘效果评测后端技术负责人。持续关注大模型领域的 AgentOps 的前沿动态和效果评测解决方案,对 AI 应用效果评测有深入的实践和理解。
讲师介绍
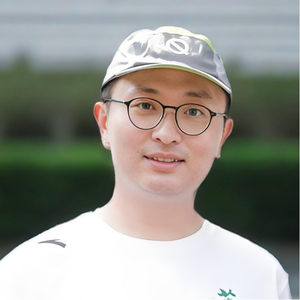
专题演讲嘉宾:史海量
字节跳动技术专家
议题介绍
地点:台州宴会厅 3
所属专题:AI 中间件:加速智能应用开发
演讲:AgentOps 实战:字节复杂 Agent 的效果评测与迭代优化
2025 年,Agent 从概念验证进入生产落地阶段,企业从传统 chatbot 转向多轮、多模态、跨工具的复杂智能体开发。相比传统软件测试,Agent 效果评测面临指标定义模糊、结果不确定性高、线上表现波动大等新挑战。本演讲我将结合字节在多业务线 Agent 落地过程中的经验,系统解析从评测集构建、指标体系设计、到持续集成与线上监测的全链路实践方法,探讨如何在不确定的 AI 行为中建立可复用的效果评测体系,并支撑快速迭代与线上稳定运行。
演讲提纲
1. 引言
- 背景
- Agent 应用开发现状
- 企业从传统 Chatbot 到复杂 Agent 开发测试迭代转变
- 从实验性项目到生产级应用的转变
- AgentOps:Agent 效果评测新范式
- 传统应用测试 VS Agent 效果评测
- Agent 应用开发现状
- 挑战
- 持续集成:区别于工程质量的确定性指标,面对大模型的不确定性,如何快速达到线上生产标准?
- 线上监测:效果如何持续线上应用的效果并不断优化迭代?
- 面对越发复杂智能的 Agent,如何设计好科学的指标,全方位的评判 Agent 各个环节?
2. Agent 效果评测核心流程解析
- 效果评测核心流程
- 测试阶段:离线评测质量准出、持续集成
- 线上阶段:在线评测持续监测效果、迭代优化
3. 字节效果评测的实践步骤
- 构建持续迭代的评测集数据
- 多模态、多轮对话等评测集的构建方法
- 选择适合不同业务场景的评测指标
- Agent、多模态、多轮对话、一致性等业务指标设计与实践
- LLM-As-Juge、Code 等评估方法实践
- 基于灵活智能的评测实验结果,发现 badcase
- 单实验分析、多实验结果的对比分析的方法
- 洞察 insight:如何用 Agent 智能发现问题给出建议
- 线上阶段持续的效果观测、优化和迭代
- 用在线评测的方式发现线上性能和效果问题
4. 用户案例
- 字节内部:直播业务
- 短视频合规审核场景,人审如何转大模型机审提效,评测集管理、多模态、多轮对话评测方法
- 商业化:Agent 评测解决方案
- 全码 Agent 应用,基于 trace 的在线评测、评测集管理能力
5. 未来规划与展望
- 复杂 Agent / Multi-Agent 如何进行更好的效果评测
您认为,这样的技术在实践过程中有哪些痛点?
- 面对越发复杂智能的Agent,如何设计好科学的指标,全方位的评判 Agent 各个环节?
- 如何做好开发阶段的效果准出评测和线上阶段的线上效果监测?
- 如何结合业务情况,构建合适的评测集和选择合适的评估指标?
演讲亮点
- 评测集管理构建、评估器选择与设计、评测报告分析洞察等最佳实践分享
- Agent在线评测、多模态评测、多轮对话评测等多种场景化评测方法分享
- 基于字节内部真实业务的效果评测最佳实践
听众收益
- 了解 AI 应用效果评测的通用评测流程和方法
- 了解字节内部真实业务效果评测的最佳实践、一手经验
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手