在 AI 快速演进的时代,掌握模型训练与微调的能力,意味着你可以真正掌控 AI ... 展开 >
模型训练与微调
会议室:兴盛宴会厅出品人:张海俊
- Topic 1
陈锐彪
百度 资深工程师 - Topic 2
赵鹏
阿里巴巴 算法工程师 - Topic 3
赵伯罕 博士
算秩未来 资深技术专家 - Topic 4
郑茂
腾讯 混元应用算法负责人
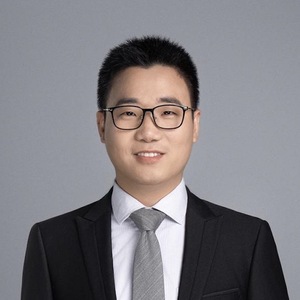
专题出品人:张海俊
科大讯飞AI 工程院内核技术部副总监
张海俊,科大讯飞高级算法工程师,AI 工程院内核技术部副总监,长期从事语音智能唤醒、语音通用识别、通用神经网络推理框架、深度学习训练框架和超大模型训练相关研究研发,当前主要集中在大模型训练工程优化,深度参与讯飞星火大模型的工程研发。
地点:兴盛宴会厅
专题:模型训练与微调
在 AI 快速演进的时代,掌握模型训练与微调的能力,意味着你可以真正掌控 AI 的核心价值。无论是打造行业专用模型、提升预测精度,还是降低部署成本,模型训练与微调都是实现这一切的关键环节。然后当前模型训练与微调面临诸多挑战,如:数据准备复杂、训练资源消耗大、微调策略多样、评估指标不统一、部署链条长等。本专题将聚焦于模型训练与微调的实战技巧,邀请行业专家分享他们在实际项目中的经验与见解。我们将探讨从数据准备到模型部署的全流程实践,了解模型训练微调的工程优化和效果调优手段,揭示模型训练与微调的最佳实践和未来趋势。
专题可能涵盖的内容:
- LLM 训练和微调的性能优化
- 数据构建和模型优化策略
- 模型评估和验证机制
- 大模型训练过程的问题和解决方案
- 面向不同场景的训练和微调落地应用
by 陈锐彪
百度
资深工程师本次演讲将重点分享飞桨在文心 4.5 系列大模型训练中的性能优化实践,涵盖多模异构 MoE 结构下的工程挑战与系统性解决方案,包括混合并行策略、负载均衡优化、显存效率提升及 FP8 训练等关键技术。
演讲提纲
1. 多模异构 MoE 模型的工程挑战
- 视觉模块对流水并行的影响
- 变分数据对负载均衡的影响
- 多模态联合训练对存算均衡的影响
2. 多模型结构混合并行
- 视觉编码并行策略
- MoE 并行策略
3. 分层多模负载均衡策略
- 粗粒度数据重排
- 变长序列并行模式
4. 极致存算均衡技术
- 显存友好 MoE 架构
- 显存优化流水编排
- 细粒度重计算
- FlashMask
- 稀疏掩码技术
5. FP8 训练与优化
- 算子融合
- FP8 通信优化
- FP8显存优化
6. 大规模集群训练技术
- 高效自动故障感知、定位、容错机制
7. 总结与展望
您认为,这样的技术在实践过程中有哪些痛点?
- 多模型结构混合并行策略的工程实现
- 多模数据负载均衡
演讲亮点
- 针对多模异构 MoE 模型的多模型结构混合并行策略实现,能最大化并行效率
- 多模态负载均衡策略,降低多模变分数据对端到端性能的影响
听众收益
- 了解飞桨大规模分布式技术及其在文心模型上的应用
- 了解大模型训练的难点及其常见解决方案
by 赵鹏
阿里巴巴
算法工程师当前 AI 编程领域正迎来重大变革。传统的 FIM(填充中间)模式已无法满足开发者对复杂编辑操作的需求,AI 编程助手亟需从单一续写能力升级为支持增、删、改全面操作的 NES(下一代编辑与抑制)模型。本次演讲我将系统介绍我们如何通过“全文重写”方案实现 NES 能力,并突破高性能推理、训练数据构建与模型优化等关键技术难题。我们将重点分享 SP Edit 推理方案如何实现 1000+tokens/s 的生成速度,以及如何融合静态代码与动态日志数据构建训练集。此外,针对训练中遇到的回滚、能力冲突等典型问题,我们提出基于 DPO 和 SFT 的优化策略。最后,通过 IDE 回放与 LLM 评测相结合的评估体系,验证 NES 模型的实际效果,并展望其与 Agent 协同工作的未来方向。
演讲提纲
1. 背景与模型演进
- AI Coding 需求升级:从 FIM 到 NES
- FIM 与 NES 的效果对比与案例展示
- 单行补全与 NES 的冲突与融合
- NES 模型的输入输出设计与 IDE 协作方式
2. 推理方案与性能优化
- 全文重写 vs. 定点编辑的权衡
- sp edit 推理方式与性能优化(1000 token/s)
- 效果对比与落地案例
3. 数据构建与迭代
- 单行补全扩充方案
- 基于 PR 的数据构建方式
- 日志驱动的动态数据收集
4. 模型训练与优化实践
- SFT 提升 NES 基础能力
- DPO 针对 bad case 的优化策略
- GRPO 规则设计与能力扩展
5. 评测与反馈机制
- IDE 回放策略与真实场景评测
- EM 强对比与 LLM 评测结合
6. 未来展望
- NES 与 Agent 的竞争与合作
- Agent + NES 的 AI Coding 最佳实践
您认为,这样的技术在实践过程中有哪些痛点?
- 数据构建成本高
- 模型输出样式冗余度高
- 跨文件编辑能力不足
演讲亮点
- 相较于单行和 NES 共存方案,此方案复杂度和灵活性更高
- 相较于位点预测 + 区域修改,我们推理能支持全文重写,同时通过 Special Token 设计可以控制模型输入输出时间
听众收益
- NES 成熟实现方案,完整设计思路
- 行业的新动向
by 赵伯罕 博士
算秩未来
资深技术专家大规模语言模型训练与推理已经进入万亿参数时代,GPU 集群的稳定性与效率成为瓶颈。现有框架如 Megatron-LM 在并行训练中虽能扩展规模,却面临慢节点诊断困难、流水线调度刚性、CPU/GPU 资源耦合严重、可解释性不足等问题。针对这些挑战,算秩未来和上海期智研究院联合研发了 MegatronApp,一个围绕 Megatron-LM 的开源增强工具链,包括:
- MegaScan:基于 CUDA Events 的时间轴追踪与慢节点检测(仅 1–2% 开销)
- MegaFBD:前后向解耦,支持异构资源映射,提升资源利用率
- MegaDPP:动态流水调度,支持深度/广度优先切换,缓解带宽瓶颈
- MegaScope:中间张量的压缩可视化与扰动注入,支持交互式解释
实测结果显示,GPU 利用率可提升约 25%,传输负载降低 50%,系统整体开销控制在 <2%。本次演讲我将结合具体踩坑案例与优化经验,分享 MegatronApp 在大规模训练场景中的价值与未来展望。
演讲提纲
1. 背景与痛点
- LLM 训练进入万亿参数规模,分布式训练复杂度急剧上升
- 典型问题:
- GPU/链路不稳定导致级联延迟,但是由于集合通讯的延迟传导特性难以定位训练异常
- 1F1B 流水调度刚性,难以适配动态网络波动,无法充分利用网络、显存资源
- Forward/Backward 资源耦合,造成不必要的通讯开销和通讯阻塞
- 可解释性工具缺乏,难以深入探索训练中间结果和模型能力之间的联系
2. MegatronApp 的整体方案
- 一个围绕 Megatron-LM 的增强工具链
- 四个核心模块:MegaScan、MegaFBD、MegaDPP、MegaScope
- 设计目标:低侵入、轻量化、模块化,可按需启用
3. 核心模块与技术突破
- MegaScan(性能诊断与根因分析)
- 基于 CUDA Events 的低开销追踪(开销 <2%)
- 时间轴对齐 + 通信组依赖还原,准确识别慢节点
- 实例:GPU 降频/链路抖动的定位经验
- MegaFBD(前反向解耦)
- Forward 与 Backward 拆分到不同设备执行
- 利用虚拟 rank 与通信协调器解决线程级死锁问题
- 实例:在【 H100 + 4090 】异构集群中提升约 25% 的资源利用率,充分发挥不同类型 GPU 的硬件优势
- MegaDPP(动态流水调度)
- 支持深度优先/广度优先两种遍历顺序
- 基于显存与带宽状态的自感知调度
- 实测:8 卡节点在 200G IB 网络上,传输窗口有效增长2.4倍,传输负载降低 50%,通信压力显著降低
- MegaScope(可视化与解释)
- 动态张量采集与分层压缩,避免 I/O 瓶颈
- Attention 热图、激活分布轨迹、交互式扰动注入
- 实例:在 Jailbreak 场景下利用 Megascope 降维功能快速定位发挥“越狱作用”的 token
4. 踩坑经验
- 多进程通信并发死锁:如何通过剔除依赖实现基于 NCCL 的多组并发异步通讯
- 多实例交互下的调度问题:前后向解耦场景下如何保障上游数据的供给效率
5. 实践效果
- GPU 计算效率:提升 ~25%
- 传输负载降低 50%
- 监控开销:控制在 1–2%
- 更强的异常定位与调试能力
6. 经验总结与展望
- 工程实践心得:如何在工业级训练框架中实现低侵入增强
- 最佳实践:性能诊断、调度策略、自适应资源映射
- 未来展望:
- 自适应调度与鲁棒性训练
- 开源生态建设与社区合作
您认为,这样的技术在实践过程中有哪些痛点?
- 可视化和监控功能会引入少量运行开销
- FBD 技术本身会引入额外的固定协调开销,因此在计算时间较长的模型上效果比较显著
演讲亮点
- 深度耦合训练框架,即插即用,无需额外调用成本
- 面向异构场景,支持使用消费级显卡的训练平台
听众收益
- 对于大模型训练框架的调优经验和 idea
- 对于一线大模型训练的工业级需求
- 对分布式大模型训练的原理和未来趋势探讨
by 郑茂
腾讯
混元应用算法负责人腾讯混元开源其国际翻译比赛冠军模型 Hunyuan-MT-7B,该模型参数量为 70 亿,支持 33 种语言和 5 种民汉语言/方言互译,是一个轻量级但能力全面的翻译模型。同时开源的还有业界首个翻译集成模型 Hunyuan-MT-Chimera-7B,它可综合多个翻译模型的结果生成更优翻译,支持接入包括 Deepseek 在内的其他模型。开源不到一周的时间,混元翻译模型登顶 Hugging Face 模型趋势榜第一位。
在 ACL WMT2025 比赛中,Hunyuan-MT-7B 在 31 个语种中获 30 项第一,涵盖常见语种及多个小语种。Hunyuan-MT-7B 在参数受限情况下击败了多个更大规模的模型。在 Flores200 测评数据集上,其表现也领先同规模模型,媲美更大模型。
该模型采用的训练范式涵盖预训练、监督调参、翻译强化等环节。其轻量设计带来多项优势:推理速度更快、支持 FP8 量化进一步提升性能 30%,部署灵活且成本更低,适用于从服务器到边缘设备的多种环境。目前该模型已应用于腾讯会议、企业微信、QQ 浏览器等业务。
本次演讲我将主要介绍腾讯混元大模型团队在混元翻译模型上的训练优化方法。提出大模型翻译能力训练范式,分享在业务应用中的优化经验,希望能给大家带来一些帮助。
演讲提纲
1. 大模型时代机器翻译面临的挑战
2. 大模型机器翻译能力构建
- SHY 训练范式设计
- CPT 阶段关键技术难点
- SFT 阶段关键技术难点
- RL 阶段关键技术难点
3. 业务应用中遇到的困难
- 领域术语翻译效果优化
- 低资源语种翻译效果优化
4. 总结与展望
您认为,这样的技术在实践过程中有哪些痛点?
- 训练流程过长导致成功率偏低
- post-train 阶段训练高质量 reward model 是效果提升的关键
演讲亮点
- 提出业界首个翻译大模型的训练范式,并拆解各个关键环节的关键技术方案,切实提升翻译模型的可用性
听众收益
- 了解业界最先进的翻译大模型在训练过程中遇到的效果调优问题,包括训练框架涉及、post-train 关键技术难点解决方案等
- 了解腾讯翻译在落地应用中遇到的问题和解法
关注主办方(InfoQ)
联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手