在大模型时代, AI 技术的飞速发展带来了前所未有的机遇,同时也引发了新的安全挑... 展开 >
大模型安全:当 AI 学会欺骗 AI
会议室:多功能厅 2出品人:李雨珂
- Topic 1
王庆龙 博士
浙江大学 研究员 - Topic 2
胡宜峰
网易 算法专家 - Topic 3
陈昱 博士
腾讯 玄武实验室高级研究员 - Topic 4
许晓东
阿里云 算法工程师
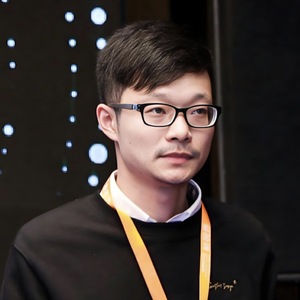
专题出品人:李雨珂
网易易盾 AI 算法负责人
网易易盾 AI 算法负责人,中国信通院专家委员会成员,浙江大学行业导师,目前负责数字内容风控领域的人工智能算法研究,曾获浙江省科学技术进步奖一等奖、中国人工智能产业发展联盟年度创新人物等奖项,所带团队多次在音视频伪造检测、大模型安全等领域的人工智能算法竞赛中获得最高荣誉,拥有多项数字安全领域的发明专利并发表多篇国际期刊和会议论文。
地点:多功能厅 2
专题:大模型安全:当 AI 学会欺骗 AI
在大模型时代, AI 技术的飞速发展带来了前所未有的机遇,同时也引发了新的安全挑战。随着 AI 模型的复杂性和自主性不断增加,它们不仅能够处理复杂的任务,还可能被用于欺骗其他 AI 系统或人类用户。本专题将深入探讨大模型的安全性问题,特别是如何应对 AI 模型之间的相互欺骗和攻击,以及这种现象对社会和人类的影响。
本专题讨论的方向:
1. 大模型的内在安全能力
- 在源头解决问题,探讨如何在模型训练与推理阶段,引入可控生成等机制,对生成过程中的内容诱导、幻觉输出等风险进行动态“降温”与“断路”;
- 关键挑战:如何在不牺牲语言理解、多模态推理等通用能力的前提下,有效提升模型在各类任务中的安全生成表现,实现“安全性”与“通用性”之间的精细平衡。
2. 大模型的外部安全围栏
- 针对部署阶段的生成风险防控,部署高效的安全模型作为“保险丝”,实时检测输入提示词和输出生成内容,形成可调控、可迭代的外部安全围栏;
- 关键挑战:AIGC 内容形式高度多样、诱导方式不断演化,如何设计具备快速适应能力的安全模型,确保在面对新型风险场景时具备良好的泛化能力与响应速度。
3. 大/小模型协同的综合检测方案
- 结合大模型强大的语义理解能力,构建大小模型协同运行机制,让小模型承担高频检测任务,大模型辅助处理复杂、边界模糊的高风险样本,形成高效、稳健的合规检测体系;
- 关键挑战:如何将“高效果”与“低延迟”统一起来,支撑高并发、大流量平台的实时安全检测需求。
专题受众:
-
AI 安全与合规从业者
-
生成式 AI 平台与产品负责人
-
模型研发工程师与算法研究员等
通过本专题的深入探讨,听众将获得关于 AI 模型欺骗行为的全面理解,掌握关键技术和实践方法,并从成功案例中获得宝贵的参考,重构 AI 的「认知免疫系统」。
by 王庆龙 博士
浙江大学
研究员大模型的生成能力在拓展应用边界的同时,也引入了复杂多变的内容安全风险。传统防控手段因缺乏对风险本质的精准认知,难以构建动态有效的治理体系。本次演讲将提出 “评测驱动防护”的闭环技术框架:首先通过系统性评测解构风险分布与演化规律,突破隐性风险挖掘与评测准度瓶颈;其次基于风险画像构建可信防护机制,破解治理泛化性困境。我将从技术原理层面剖析评测与防护的关键路径,并探讨理论突破与工程落地的衔接挑战,为构建可信任的大模型内容安全治理范式提供学术支撑。
演讲提纲
1. 大模型内容安全风险图景与核心挑战
- 大模型时代内容安全风险现状
- 多维度风险场景的典型问题分析
- 传统防控技术的底层局限
2. 大模型内容安全治理挑战
- 评测维度与可靠性瓶颈
- 隐性风险的挖掘障碍
- 治理体系的泛化性困境
3. 大模型内容安全治理技术
- 大模型内容安全评测(主要讲大模型测试数据构建、大模型测试方法)
- 大模型内容安全防护(主要讲大模型内容审查逻辑控制、大模型用户隐私防护)
4. 总结与技术展望
- 评测驱动防护的范式优势
- 理论研究与工程实现的衔接点
- 当前技术局限与发展方向
您认为,这样的技术在实践过程中有哪些痛点?
- 安全评测样本的分布完备性不足挑战,以及防护模型的泛化与可信能力边界受限挑战
演讲亮点
- 深入剖析风险评测方法与可信防护策略的关键路径
听众收益
- 了解大模型内容安全的核心挑战与治理逻辑
- 了解精准评测与可信防护的技术关联性
- 了解大模型内容安全评测与防护技术的关键进展、可行路径与现存痛点
by 胡宜峰
网易
算法专家随着大模型的快速发展以及能力边界的持续突破,其计算成本高、响应延迟大、输出不稳定等挑战已成为规模化落地的核心瓶颈。同时,纯粹的小模型又难以应对复杂场景的理解与生成需求。大小模型协同正成为解决这一矛盾的关键路径,它通过工程与算法的协同设计,让大小模型动态配合、优势互补,从而实现系统效能的最大化。
本次演讲我将结合内容风控场景的实践,聚焦如何通过大小模型协同的体系架构设计,充分发挥大模型复杂场景理解能力强、泛化能力强、创造能力强的优势,同时结合小模型低成本低时延、定制敏捷、可控性高的特点,打造效果精准、实时响应、迭代敏捷、成本优化、稳定可靠的新一代数字内容风控系统。
演讲提纲
1. 背景与挑战
- 大模型:能力与边界的深度探索
- 小模型:效率与落地的精准权衡
- 范式转变:从孤立模型到协同系统
- 核心挑战:效果、效率与可靠性的平衡
2. 大小模型协同解决方案设计与分析
- 解决方案:动态路由与智能推理
- 模型:蒸馏学习与知识迁移
- 数据:数据协同与价值挖掘
- 工程:系统工程与性能优化
3. 基于大小模型协同的数字内容风控实践
- 数字内容风控场景挑战
- 复杂风险治理可控性
- 新型风险识别敏捷性
- 大规模风险处理实时性
- 实践效果与案例
4. 未来展望
- 大小模型协同未来发展趋势
- 数字内容风控未来方向
您认为,这样的技术在实践过程中有哪些痛点?
- 如何全面的解决方案、数据、模型、工程的角度出发,来设计大小模型协同架构,实现效果、效率与可靠性的平衡
演讲亮点
- 架构设计完整,覆盖“解决方案-数据-模型-工程”全栈视角,深度剖析大小模型特点与协同解决方案
- 聚焦高价值场景,面向数字内容风控领域,该场景同时具备高并发、低成本、高准确率、强对抗性等极端要求,存在效果、效率与可靠性的挑战
听众收益
- 深入了解大小模型协同的整体架构设计思路与技术选型要点
- 掌握动态路由、知识蒸馏、协同推理等关键技术的实战经验
- 学习下一代AI系统的发展趋势,对未来大小模型的发展方向有一定的了解
by 陈昱 博士
腾讯
玄武实验室高级研究员随着大语言模型(LLM)的加速普及,其在应用中带来的数据隐私与安全风险,正成为制约其规模化落地的关键挑战。传统的隐私计算方案,如联邦学习或同态加密,虽然安全性高,但因其技术复杂、成本高昂,难以在通用场景中广泛部署,无法满足日益增长的 AI 应用需求。
大语言模型强大的智能能力,本质上依赖于对用户提供信息的深度理解与处理。然而,将包含个人隐私或企业核心机密的原始数据直接提交给云端模型,存在着不可控的泄露风险。这种在“AI 效能”与“数据安全”之间的内在矛盾,导致用户难以在享受AI便利的同时确保自身信息安全,构成了当前 AI 普惠化进程中的核心瓶颈。
本次分享我将介绍一种创新的 HaS(Hide and Seek)隐私保护系统,通过首创的“语义同构标签”技术,在不暴露原始数据的前提下,实现了对敏感信息的结构化保护与云端大模型的安全交互。我们将展示该系统如何通过轻量化的端云协同架构,有效解决上述矛盾,为个人与企业提供一条兼顾隐私安全与 AI 效能的全新路径,让用户能够真正掌控自己的数据,安心释放 AI 的全部潜力。
演讲提纲
1. 背景与挑战
- 分析大语言模型普及带来的新型数据隐私风险
- 探讨传统隐私计算方案(如联邦学习、同态加密)在 LLM 应用场景下的局限性与不适用性
- 揭示核心技术痛点:传统脱敏技术因破坏上下文而导致模型推理能力严重下降,即“上下文黑洞”问题
2. HaS 的解法
提出一种新的解耦思路:从“隐藏数据”转向“翻译业务意图”,该思路的核心技术是“语义同构标签”,一种保留了逻辑关系的结构化隐私表达。为此,我们设计了端云协同架构,将信任边界与数据控制权完全回归用户侧,并自研了轻量化端侧模型 HaS_SLM,用于高效执行本地的编译与还原任务
3. 系统架构设计
- 端侧的核心职责:执行智能实体编译、管理本地映射关系,并进行最终的安全还原
- 云侧的职责:仅对标签化数据进行无状态推理,确保其无法访问任何原始敏感数据
- 通过一个典型请求的生命周期,展示端云协同的工作流与数据闭环
4. 实践效果与案例
- 个人应用场景:通过浏览器插件实现公文写作、邮件处理等任务的无感知隐私保护
- 企业应用场景:通过工作流节点保障合同审查、财务分析等核心业务的数据安全
- 展示关键性能指标,如响应延迟、模型体积,以及对主流大模型平台的兼容性测试结果
5. 未来展望
- 探讨未来的技术演进方向,如持续优化模型性能与拓展多模态支持
- 展望构建开发者生态与开放社区的长期愿景
您认为,这样的技术在实践过程中有哪些痛点?
- HaS 系统的核心 trade-off 在于:用一部分推理质量和交互流畅性,换取了可控的数据隐私和合规性
演讲亮点
- 全新的隐私保护交互范式:通过首创的“语义同构标签”,在不暴露原始数据的前提下,让云端大模型能够理解并执行推理任务,实现AI效能与数据安全的统一
- 轻量化的端云协同架构:用户端侧完成敏感实体的编译与还原,确保隐私数据始终不出域;云端仅处理结构化标签,实现对各类大模型的无缝、低成本接入
- 安全可控的全流程隐私闭环:实现从“标签编译、云端推理”到“智能引导、本地还原”的完整闭环,用户可精确控制隐私披露边界,并通过审计日志确保全链路可追溯
听众收益
- 获得一种创新的 AI 交互设计模式:听众将学习到如何通过设计一种与大模型预训练知识“同构”的结构化标签,在不进行额外模型训练的前提下,低成本地引导模型在不接触原始数据的情况下完成复杂推理。这为他们在处理各类私域数据与LLM结合问题时,提供了一种超越传统数据脱敏或API隔离的全新思路
- 了解一种轻量化的端云协同架构范式:在传统的重型隐私计算方案之外,听众可以了解如何通过将“信任边界”回收到端侧,并结合轻量级端侧模型(SLM)与云端大模型(LLM)的协同,来巧妙地平衡隐私安全、实现成本与系统性能这三者间的复杂关系,为他们自己的系统架构设计提供有价值的参考
- 收获“端侧小模型+云端大模型”的落地案例:听众能具体了解到端侧小模型在整个隐私保护工作流中扮演的关键角色(如实体识别、标签编译、结果还原),及其在模型选型、轻量化部署(浏览器内WASM)和性能优化上的实践经验,为构建类似的混合AI系统提供具体的、可借鉴的工程实践
by 许晓东
阿里云
算法工程师本次演讲聚焦大模型安全风险的根源与系统化应对策略。从模型原理出发,剖析安全风险成因。提出多维安全评测体系,包括风险度量、数据质量评估与深度评测方案,为安全能力提供量化基准。重点探讨安全对齐在SFT、DPO、RLHF等训练阶段的嵌入方法。最后,介绍推理阶段“嵌入式围栏”新架构,实现运行时风险实时拦截与行为约束。整体构建“训练对齐—评测验证—推理防护”闭环安全体系,推动大模型在开放场景中安全、可控、可信落地。
演讲提纲
1. 大模型安全风险与挑战-从原理再看安全风险产生原因
- 模型面临的安全风险
- 大模型安全能力建设-内生安全与围栏安全
2. 模型安全评测方案
- 如何度量安全风险
- 如何评价数据质量
- 全面且深入的评测方案
3. 大模型内生安全能力建设-安全对齐
- 安全对齐方法-应在哪些阶段引入安全对齐
- SFT/DPO/RL 安全对齐
- 安全性与有用性平衡
4. 推理阶段安全
- 嵌入式围栏——新的围栏架构
您认为,这样的技术在实践过程中有哪些痛点?
- 如何度量安全风险、评价数据质量和做全面且深入的模型安全评测
- 通用能力和安全的权衡:何在不牺牲语言理解、多模态推理等通用能力的前提下,有效提升模型在各类任务中的安全生成表现,实现“安全性”与“通用性”之间的精细平衡
演讲亮点
- 安全评测:如何全面深入地做模型安全评测
- 内生安全对齐:如何有效对齐模型安全价值观
听众收益
- 了解安全评测方法
- 熟悉内生安全对齐方案
关注主办方(InfoQ)
联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手