DeepSeek 的横空出世,对 LLM 领域产生了多维度、深层次的变革,促进了... 展开 >
Data Infra for AI
会议室:台州宴会厅 2出品人:郭俊
- Topic 1
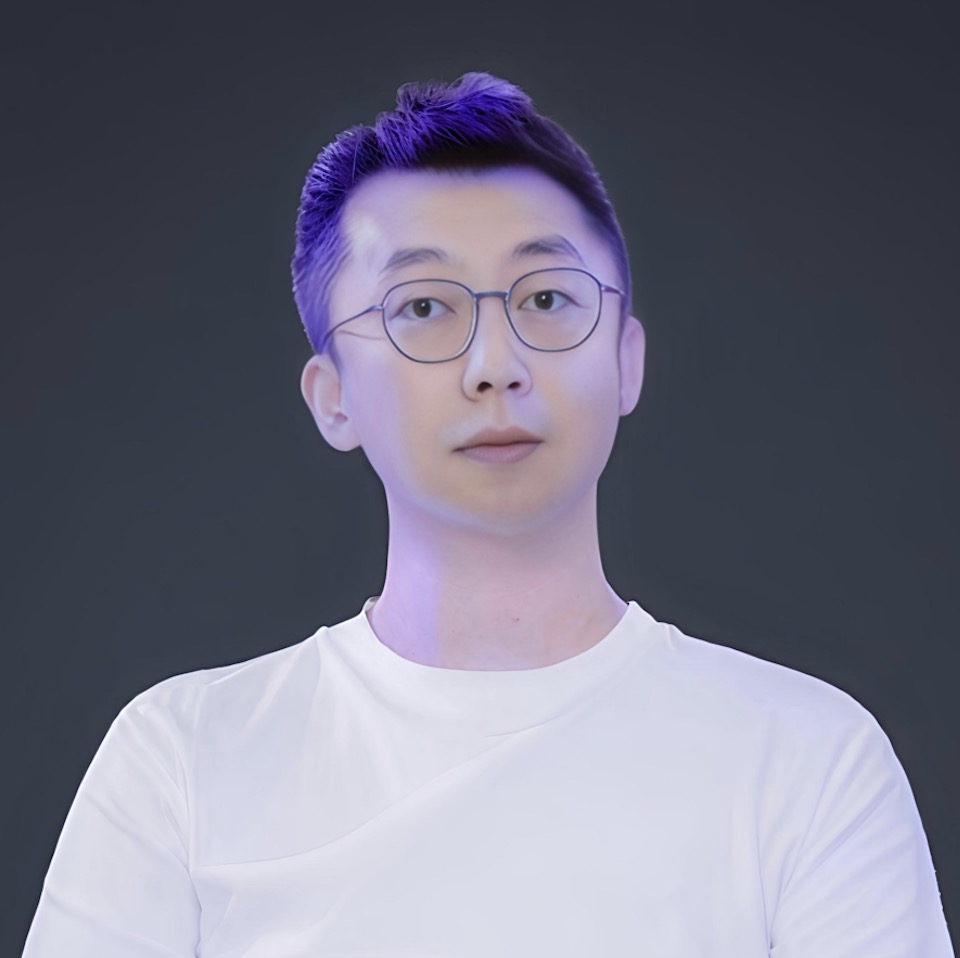
丁远普
火山引擎 AI 数据湖研发负责人 - Topic 2
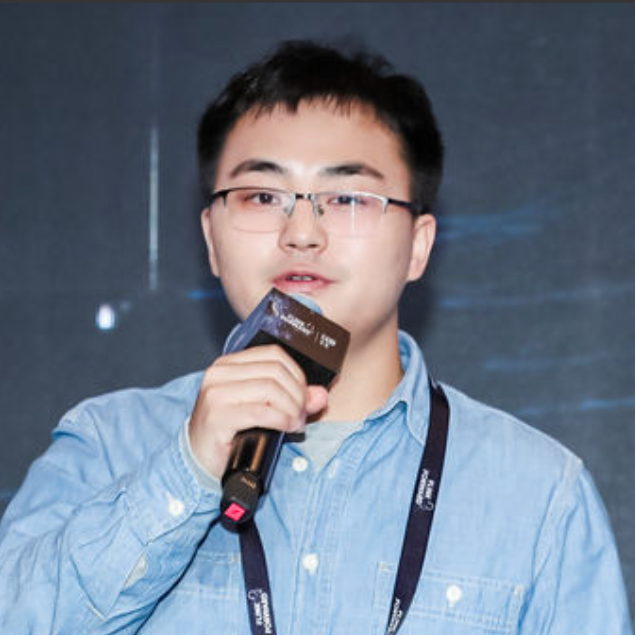
徐榜江
阿里云 高级技术专家 - Topic 3
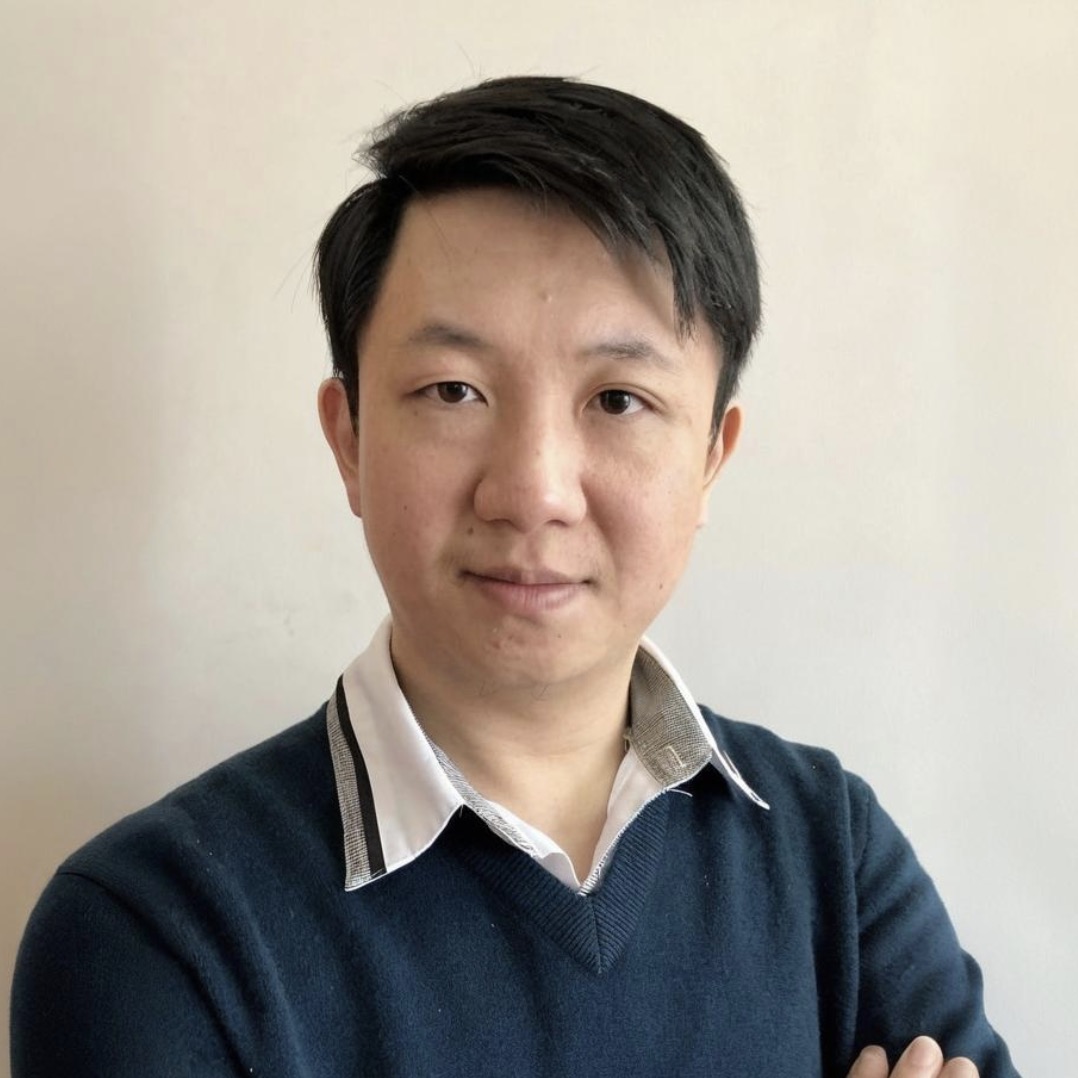
郑志升
哔哩哔哩 技术专家
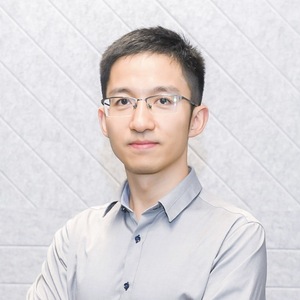
专题出品人:郭俊
字节跳动数据引擎团队负责人
郭俊,字节跳动数据引擎团队负责人。负责火山引擎 EMR、LAS 的研发及产品等工作,同时负责字节跳动内部 Spark、Doris、Presto、native engine 等大数据引擎的研发及运维工作。
地点:台州宴会厅 2
专题:Data Infra for AI
DeepSeek 的横空出世,对 LLM 领域产生了多维度、深层次的变革,促进了 LLM 技术的民主化及创新的去中心化。Multi-Agent 等技术也越来越流行。数据技术作为支撑 AI 技术发展的重要一环,将面临哪些挑战和革新?本专题将从 LLM、多模态数据处理、多模态数据湖、多模态数据管理等方向,结合头部企业实践,探讨大模型时代的 Data Infra 演进方向。
本专题讨论的方向包含:
-
数据资产的管理:如何面向大模型提供一套高效的数据管理平台,包含数据集管理、血缘管理、版本管理、算子管理等核心能力
-
面向大模型的多模态数据存储底座与存储格式:什么样的存储系统/范式以及存储格式能够应对非结构化数据,尤其多模态数据带来的挑战
-
计算范式及引擎:大模型数据处理往往需要异构计算资源,同时数据处理与分析的软件技术生态与传统大数据有较大差异
专题受众
-
数据处理团队:为大模型的训练或推理准备数据
-
大数据引擎团队:为 AI 场景设计并优化数据存储及计算引擎
-
算法团队:基于传统算法或大模型对多模数据进行处理,如内容识别和内容生成
by 丁远普
火山引擎
AI 数据湖研发负责人随着 LLM 和多模态 AI 技术的飞速发展,非结构化数据量呈指数级增长,这极大地增加了数据管理、检索、计算和存储的复杂性。传统的数据湖解决方案已难以适应 AI 场景下对数据的新需求。
为了应对这一挑战,新一代数据湖必须解决以下多模态数据带来的关键问题:
- 数据管理:传统数据管理侧重于库表结构,而面对多模态非结构化数据,如何实现高效管理 ?
- 数据处理:如何从非结构化数据中挖掘潜在价值,如何提高 CPU 和 GPU 利用率,如何使用模型来处理数据 ?
- 数据存储:传统数据湖格式在非结构化数据存储方面存在局限,是否可实现全模态数据的统一湖格式存储 ?
- AI 场景支撑:多模态数据湖如何支撑 预训练、后训练、知识库、AI 搜索、智能体等场景的数据诉求?
本次演讲我将分享下一代多模态数据湖探索与实践,包含新一代的技术架构,关键开源技术的更迭等。
演讲提纲
1. 传统数据湖架构面临的挑战
- 传统数据湖架构与特点
- 无法高效管理多模态数据
- 数据处理技术栈的限制
- 传统湖格式存储多模态数据的问题
- 数据处理人员角色、经验、数据规模的变化
- 企业创新阵地的变更
2. 下一代面向 AI 的多模态数据湖
- AI 数据湖参考架构
- 元数据 vs 数据集
- 数据处理引擎 or 模型
- 数据处理引擎 Ray 的优化与实践
- 面向AI设计的多模态数据处理新引擎介绍
- 引擎 & 模型统一数据处理
- DataFrame and SQL AIQuery
- 如何优化模型调用
- 多模态数据湖格式 Lance
- 多模态数据存储的痛点
- Lance 湖格式的优化和实践
- 异构存储的数据流动、分层、汰换
3. AI 数据湖的实践案例
- 模型训练场景实践
- 智驾行业实践案例
- AI 应用场景实践案例
- ……
4. 未来规划与展望
- 当前未解的问题
- 看到的趋势
- 下一阶段的规划
您认为,这样的技术在实践过程中有哪些痛点?
- AI 时代的数据湖架构是否会逐步形成一套标准,需要时间校验
- 新技术栈的成熟需要不断的迭代与演进,是挑战也是机遇
- AI 时代的变化日新月异,对 Data Infra 的诉求也在快速变化中
演讲亮点
- AI 时代对数据的诉求变更
- 新一代的技术架构,关键开源技术的更迭
- 遇到的问题与解法
听众收益
- 大数据时代的数据湖与 AI 时代的数据湖有巨大变化,全新的需求驱动下一代技术变革
- 了解服务于 AI 创新的多模态数据湖新架构、新技术介绍,我们的技术优化、实践、思考和总结
- 一起探讨下一阶段的创新
by 徐榜江
阿里云
高级技术专家随着 AI 与多模态应用的爆发式增长,现有数据湖架构在处理文本、图像、音频、视频等多模数据时面临数据延迟高、查询效率低等挑战。本次分享我将介绍如何结合 Fluss(实时流存储)与 Lance(多模态湖),高效构建一个支持实时写入、高效检索的多模态数据湖架构。我们将深入分析 Fluss 的湖流一体架构设计,以及在该架构中无缝集成 Lance,并通过一个 Python 开发的 demo展示如何便捷地构建实时多模态数据湖。
演讲提纲
1. 背景与问题
- 多模态应用爆发带来的数据管理挑战
- 现有数据湖在实时性与查询效率上的不足
2. 核心技术介绍
- Fluss:实时流存储架构与典型应用场景
- Lance:面向多模态优化的列式存储与检索能力
3. 湖流一体架构实践
- Fluss 插件化架构解析
- Fluss 与 Lance 的无缝集成方案
- 实时多模态数据入湖机制
4. 实战 Demo
- 使用 Fluss Python SDK 接入与写入 Lance
- 与常见 AI 工具链集成,支持多模态分析
5. 总结与价值
- 架构在实时性、性能、开发效率上的优势
- 可复用的实时多模态数据湖建设方案
您认为,这样的技术在实践过程中有哪些痛点?
- 湖流一体的架构,为了更好的稳定性和性能,将入湖组件外置,带来了一定的复杂度,但通过无状态的组件设计,极大地简化了运维操作
- Fluss 和 Lance 项目都还处于项目孵化早期,对接过程中不完善的地方较多,需要两个社区高效协作
- Python API 支持对于AI用户非常重要,Fluss 在 Python Client 的设计上,在性能和工程复杂度上做了考量,最终选择了性能更优的 Python binding on Rust
演讲亮点
- 率先在在业界探索实时多模态数据湖架构
- 通过湖流一体的设计,提供端到端的低延迟解决方案
听众收益
- 掌握 Fluss 实时流存储的核心能力与最佳实践,理解其在实时分析场景下的优势
- 掌握 Lance 的多模态数据存储,理解 Fluss 的湖流一体高效入湖方案和核心收益
- 理解湖流一体架构的设计和收益,获得一套可落地的实时多模态数据湖架构方案
by 郑志升
哔哩哔哩
技术专家本次演讲我将分享如何基于 Ray 构建高效的分布式 AI 架构,重点解决多模态数据处理、近离线的大模型推理链路和强化学习训练工程三大挑战。通过流批一体的推理管道实现近线和离线的统一及异构资源整合的灵活弹性计算。训练方面通过 Ray 的强大底座优化强化学习 Verl 框架,实现异构组网 + 异步训练的高效模式。过程展示这套方案如何通过统一的技术框架,在保证稳定性的同时提升模型推理和训练效率,为 AI 工程化提供端到端的优化方案。
演讲提纲
1. 场景概况和痛点
- 多模态 / 多源异构数据的规模化处理瓶颈
- 大规模离线推理/回刷的时效性与成本困局
- 大模型 RL 训练的资源利用率与迭代效率优化
2. 基于 Ray 构建的分布式数据管道
- 流批一体及 Checkpoint
- 结合 LLM 的分布式推理
- 潮汐混部资源的弹性融入
- 多模态数据链路的工程落地实践
3. Ray+Verl 的强化学习训练优化
- 训练效率分析
- 异构组网 + 异步通信实现
4. 总结展望
- 多模态管道、底层能力、分布式推理、分布式训练
您认为,这样的技术在实践过程中有哪些痛点?
- 各类异构资源的融合
- RL 训练过程的效率挑战
- 业务离近线推理的工程复杂
演讲亮点
- 内容上聚焦当下大模型的各个环节,从数据处理、推理到 RL 训练的实践
听众收益
- AI 工程团队:了解大模型的 GRPO 训练等 RL 工程的效率问题及相应解决方案
- 数据工程团队:了解如何通过 Ray 实现高效的多模态数据处理,大模型分布式推理应用
关注主办方(InfoQ)
联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手