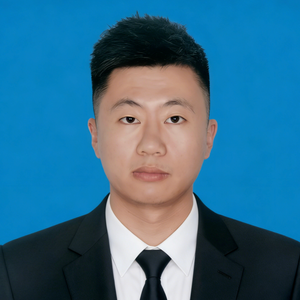
李云鑫,博士,哈尔滨工业大学(深圳)计算机科学与技术学院副教授。本硕博均毕业于哈尔滨工业大学,曾在香港科技大学访问研究,主要从事大模型及智能体方面研究,包括多模态基座大模型、多模态智能体模型、智能体框架、多模态长程推理等大模型时代的新问题、新方法,一作发表 IEEE TPAMI、ICML、ACL、SIGGRAPH 等 CCF-A/B 类期刊和会议论文10余篇,GitHub 开源项目星标累积 3 万余次,研发了 Lychee 多模态大模型 Uni-MoE 系列。曾获得首届中国科协青年人才托举工程(博士生专项)、哈工大优博;曾入选华为天才少年、腾讯青云、京东 TGT 等企业人才引进计划。个人主页:https://yunxinli.github.io/
从 Copilot 到 Director:多模态智能体如何接管 AIGC 流程
所属专题:AIGC 视觉生成技术的产业级应用
嘉宾 : 李云鑫 博士 | 哈尔滨工业大学(深圳)计算机科学与技术学院副教授
会议室 : 富力1
讲师介绍
议题介绍
地点:富力1
所属专题:AIGC 视觉生成技术的产业级应用
演讲:从 Copilot 到 Director:多模态智能体如何接管 AIGC 流程
随着 AIGC 技术的爆发,内容创作正从“工具辅助”迈向“智能主导”的新阶段。然而,复杂的生成工作流、多模态内容的一致性要求、以及长叙事的结构化难题,仍是当前 AIGC 落地的核心瓶颈。
本次演讲将系统展示我们团队在多模态智能体领域的最新探索——从辅助用户高效构建工作流的 ComfyUI-Copilot ,到能够自主完成长视频叙事与动画创作的 FilmAgent、Anim-Director 和Animaker 。我们将揭示智能体如何从“被动助手”进化为“主动导演”,逐步接管 AIGC 全流程,并分享背后的基座模型、多智能体协作机制与强化学习技术突破。
演讲提纲
1. AIGC 智能化的挑战与演进路径
- 分析当前 AIGC 工作流在规划、控制与评估上的痛点,提出从“Copilot”(辅助)到“Director”(主导)的智能体能力进化路线图
2. 基座模型与核心技术突破
- 介绍支撑智能体的全模态大模型 Uni-MoE-2.0-Omni,以及针对工作流规划的多目标强化学习算法,如何提升智能体的理解、推理与决策能力
3. 从 Copilot 到 Director:四大视觉生成智能体实践
- ComfyUI-Copilot:智能助手实现 AIGC 工作流自动构建与调试,降低使用门槛,已被 ComfyUI 官方平台集成,并落地应用于阿里国际、Runaway AIGC 云平台
- FilmAgent:多智能体协作框架,在 3D 虚拟片场中自动生成电影级内容
- Anim-Director:首个基于多模态大模型的动画生成智能体,实现分镜级控制
- Animaker:引入 MCTS 搜索与多角度评估,生成连贯且角色一致的长视频动画
4. 通用 AIGC 智能体的构想
- 如何融合底层工具智能与高层叙事智能,构建可自主进化、跨模态迁移的通用创作智能体
您认为,这样的技术在实践过程中有哪些痛点?
- 如何将文本、图像、视频、音频等多种模态数据在统一框架下进行深度对齐与协同表示,避免模态间的信息丢失与语义鸿沟,是构建全模态智能体基座的首要挑战
- 面对复杂的 AIGC 工具链(如 ComfyUI 的数百个节点),智能体如何准确理解用户意图,规划出合理的工作流节点序列,并在执行过程中自动调试与优化,降低幻觉现象
- 在跨场景、多镜头的长视频生成中,如何保证角色、场景、动作的视觉连贯性,并确保剧情逻辑与情感表达的自然过渡,避免生成内容的碎片化
演讲亮点
- 首次系统梳理多模态智能体在 AIGC 领域的四阶能力跃迁——从工具助手(Copilot)、场景执行者(Director)、多角色协作者(FilmAgent)到自主创作者(Animaker),呈现完整的演进路径
- 在 3D 虚拟片场中,导演、编剧、演员、摄像等多角色智能体通过协同反馈机制,自动生成具有连贯剧情与合理镜头的完整电影短片,实现端到端的创作自动化
- 通过多目标强化学习,仅 7B 参数的智能体在节点调用准确率、工作流结构合理性和幻觉抑制上,全面超越 GPT-4o 和 Claude 3.7 等主流闭源模型
听众收益
- 深入了解从基座模型到专业智能体的全栈技术体系,为构建自有 AIGC 智能体提供可复用的方法论
- 深入理解多元奖励驱动的强化学习算法如何提升智能体在复杂工具链中的规划准确率
- 如何将执行经验沉淀为可复用的知识库
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手