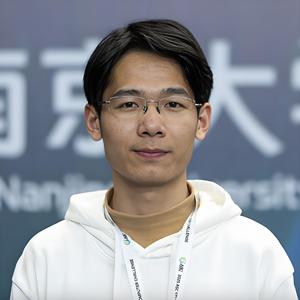
vLLM-Omni 和 vLLM 贡献者,中科院软件所基础软件与系统重点实验室研究生。
讲师介绍
议题介绍
地点:首府1
所属专题:AI 原生基础设施
演讲:从 LLM 到 Omni:vLLM-Omni 的全模态推理架构演进
vLLM 一直专注于为大语言模型(LLM)提供高吞吐、低显存的推理能力。但今天的生成式模型已经远不止“文本输入、文本输出”:新的模型可以同时理解和生成文本、图像、音频、视频,背后也不再是单一自回归架构,而是由编码器、语言模型、扩散模型等异构组件拼接而成。vLLM-Omni 是最早一批支持“omni-modality”模型推理的开源框架之一,它把 vLLM 在文本推理上的性能优势,扩展到了多模态和非自回归推理领域。这是 vLLM 生态向“全模态(omni-modality)”时代迈出的关键一步,专门为新一代看得见、听得懂、会说话、能生成多种媒介的模型设计的推理框架。
本次演讲将从推理系统视角出发,解析全模态(Omni)模型给基础设施带来的新挑战,并结合 vLLM-Omni 的架构设计,分享如何在多模态输入输出、异构算子和多阶段生成链路下实现高效推理与工程优化。
演讲提纲
1. Omni 时代与系统挑战
- 全模态输入输出
- 非传统 LLM 推理框架
- 异构链路与生成流程复杂
2. vLLM-Omni 的统一架构
- OmniStage 统一抽象
- Encoder / LLM Core / Generator
- AR 模块 + Diffusion 模块
- Any-to-Any 全模态生成
3. 性能优化与解耦部署
- qwen3-omni 等模型案例展示
- Native Disaggregation
- Async Chunk
- Streaming Output
- 多阶段独立扩缩容
4. 能力边界与演进方向
- Diffusion Acceleration
- Cache / Parallel / Quantization
- CPU Offloading
- OmniConnector / OmniRouter
- 大规模部署与持续优化
您认为,这样的技术在实践过程中有哪些痛点?
全模态模型仍在快速发展,模型结构、生成路径和部署形态都没有完全收敛,框架设计需要避免过早绑定特定范式。相比传统文本 LLM 推理,全模态场景需要同时处理多模态输入输出、异构算子和多阶段流水线协同,系统复杂度显著增加。与此同时,解耦部署、异步 chunk、流式输出等优化虽然能够改善时延和资源利用率,但也会带来新的通信、调度、状态管理和运维复杂度,因此实践中一定存在明显 tradeoff。
演讲亮点
本次分享的亮点在于,从推理系统视角讨论 Omni 模型带来的新挑战,以及为什么它不是传统 LLM 推理框架的简单延伸。分享将结合 vLLM-Omni 的架构设计,介绍其如何基于 vLLM 生态扩展到全模态场景,并重点展开 Native Disaggregation、Async Chunk、Streaming Output、IO-Compute Overlap 等关键优化机制背后的设计思路与工程取舍。
听众收益
听众可以理解 Omni 模型对推理框架提出的新要求,建立对全模态推理系统的整体认识;同时获得一套分析解耦部署、流式传输、跨阶段调度和性能优化 tradeoff 的工程视角。对于正在关注多模态/全模态推理基础设施的团队,也能借此了解 vLLM-Omni 的适配路径和未来演进方向。
本专题下其他演讲
关注主办方(InfoQ)


联系我们
交通指南
北京富力万丽酒店
Renaissance Beijing Capital Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手