2014 年 6 月于北京理工大学取得计算机硕士学位,现任百度资深研发工程师,加入百度后一直从事 AIOps 算法与架构方面的工作,致力于黄金指标异常检测体系、AIOps 前沿算法研究与落地、新一代报警系统等相关工作。
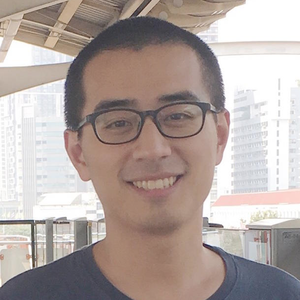
专题演讲嘉宾:王博
百度资深研发工程师
by 王博
百度
资深研发工程师故障管理是运维的重要场景,是决定业务高可用性的关键,当前很多故障的处理都依赖运维工程师对于监控实时数据的分析,但这个过程其实未必可靠。即使是一个小型分布式系统涉及到数据量也是海量的,故障期间运维工程师也很难综合所有数据进行分析,更多的是依靠历史经验基于局部少量信息做决策,一方面如果历史没见过类似故障,经验不再奏效,故障诊断时间将被拉长,另外一方面,基于局部少量信息做决策往往是不够理性的,可能以错误方式试图恢复故障,更可能造成次生灾害。
因此,我们一直在尝试借助算法对监控系统采集的时序指标和日志文本,并在故障管理场景进行落地,解决一些实际问题。例如故障发现环节如何对于黄金指标进行异常检测?如何降低海量指标的阈值配置成本?故障止损环节如何对常见的单机房故障进行流量自动调度切换?故障诊断环节,如何组合海量多样的数据加速诊断的过程,降低运维工程师的诊断成本?如何通过数据的启发对故障进行预测,使运维工作从救火向防火转变?
本次分享,我们将介绍百度在故障管理的一些经验,并且分别介绍在故障发现、故障止损、故障诊断和故障预测环节的一些智能运维算法探索,最后将分享百度在故障管理场景的一些实践案例。
内容大纲
1. 百度运维平台历史
2. 智能运维的意义和基础
3. 故障管理场景
- 故障管理场景模型
- 故障管理场景痛点
4. 故障管理场景的AIOps探索
- 故障发现:黄金指标异常检测算法
- 故障止损:单机房止损
- 故障诊断
- 故障定位:黄金指标推导算法
- 辅助故障定位
- 日志异常分析
- 主机指标排查
- 业务指标排查
- 变更故障诊断
- 故障预测
- 资源容量预测
- 智能变更检查
- 容量监控模型
- 容量退化监控
- 容量水位超限
- 预警指标挖掘
听众收益
- 了解百度的运维平台发展历史,对于智能运维算法的理解和实施要素
- 了解百度在故障管理场景遇到的难点问题、智能运维算法思想和落地案例
- 了解百度在故障预测环节的具体实践和未来工作思路
关注主办方(InfoQ)


联系我们
交通指南
中国石油科技交流中心
Beijing International Convention Center
地址:北京市昌平区沙河镇黄河北街一号院石油科技交流中心



Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 17310043226

微信联系我们
小姐姐 Ring