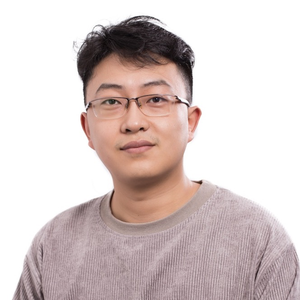
杨雪峰, 腾讯TEG高级研究员,新加坡南洋理工大学博士,深圳市海归高层次人才。现在腾讯TEG主要从事前沿技术探索与实践工作,推动预训练技术落地应用。 主要研究方向为文本的向量化表达、文本分类、阅读理解、信息抽取以及对话系统。在TASLP、EMNLP和IEEE Intelligent Systems发表多篇研究论文。 在企业服务和金融科技等领域的AI技术落地方面有多年经验。曾获CMRC2018、CoQA、SMP2020-EWECT等多项比赛冠军。
讲师介绍
议题介绍
演讲:腾讯TEG NLP中文预训练模型探索与应用
2018年BERT问世,对众多下游任务带来了明显的效果提升。预训练语言模型逐渐成为NLP领域内的焦点方向,也在学术界和工业界都引起了极大地关注和投入。
本次分享将回顾文本表达的背景意义与重要里程碑,并介绍目前领域内关注的一些焦点问题,比如预训练模型与知识图谱的融合,预训练的快速推理等。 针对这些问题,我将介绍TEG NLP工作组相关同学的一些解决方案并分享TEG NLP工作组的开源框架。
听众受益
- 了解预训练模型的历史与现在
- 学习领域内核心问题的解决方案
- 了解预训练模型的落地应用实例
适合人群
对机器学习、NLP有一定基础知识。 适合NLP、推荐系统和对话系统工作从业者。
关注主办方(InfoQ)


联系我们
交通指南
深圳机场凯悦酒店
Hyatt Regency Shenzhen Airport
地址:广东省深圳市宝安区空港八道12号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 17310043226

微信联系我们
小姐姐 Ring