目前是 vivo AI 研究院计算平台组的资深工程师,负责计算平台容器方向。毕业于浙江大学,曾就职于 Oracle、Rancher 等公司,有丰富的云原生技术实践经验,积极参与开源社区,是kube-batch, tf-operator 等项目的 Contributor。
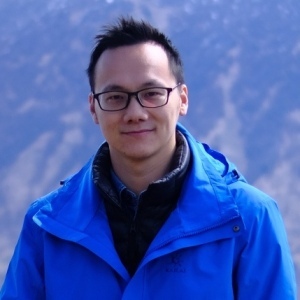
专题演讲嘉宾:吴梓洋
vivo资深工程师
by 吴梓洋
vivo
资深工程师vivo AI 研究院的业务覆盖了AI各方向,包括语音、视觉、NLP、推荐等,有众多复杂的训练推理场景,对 GPU 算力有海量需求。 GPU 设备成本昂贵,使用门槛高,整体使用率较低。AI 计算平台基于 K8s 搭建了 GPU 集群,并结合一系列开源技术实现了批调度、弹性伸缩和 GPU 算力超卖等核心特性,有效提高资源利用率和降低工程门槛。经过两年的持续迭代,平台建设和落地取得了很大进展,成为 vivo AI 领域的核心基础平台,集群有上千个节点和超过 100 PFlops 的 GPU 算力,同时运行着上千个训练任务和上百个推理服务。
演讲提纲:
1. 背景:vivo AI 业务在 GPU 上的工程痛点
- 深度学习的推理、训练、开发调试需要大量 GPU 资源
- GPU 资源成本昂贵和稀缺,但 GPU 资源整体使用率较低
- 基于 GPU 的深度学习训练和推理的使用门槛较高
2. 整体架构概览
3. 建设实践
- 离线资源调度的建设实践
- 弹性伸缩的建设实践
- GPU 算力超卖的建设实践
- GPU 集群的高效运维和稳定性保障
4. 总结和展望
你将获得:
- 了解如何通过 Kubernetes、Kube-batch、KEDA 等云原生技术构建具备批调度、弹性伸缩的 GPU 集群
- 了解大规模 GPU 集群的高效运维和稳定性保障的实践
关注主办方(InfoQ)


联系我们
交通指南
上海宝华万豪酒店
Shanghai Marriott Hotel Parkview
地址:上海市静安区广中西路 333 号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 18514549229

微信联系我们
小姐姐 小倩