目前就职于阿里云开源大数据,长期从事分布式流 / 批处理系统领域的工作,也对数据湖和 OLAP MPP 有一些研究。同时也是 Apache Beam / Flink / Iceberg 的 Committer,对底层调度、通信机制、用户模型、SQL 流批计算、存储有一定了解。目前专注于 Flink Table Store 项目的开发,希望给 Flink 带来一个最适合的存储。
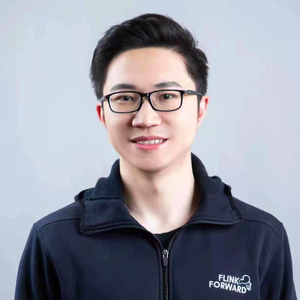
专题演讲嘉宾:李劲松
阿里云 技术专家 & Flink PMC
by 李劲松
阿里云
技术专家 & Flink PMCFlink Table Store 是一个流批统一的存储,用于在 Flink 中为流批处理建立动态表,支持实时流消费和实时 OLAP 查询。Flink Table Store 已经发布了第一个前瞻版本,但是缺少了生态和稳定性的不少工作。目前我们已经开始研发第二个版本,我们希望第二个版本能够带来更多的生产能力,通过此次分享你可以了解到我们通过加强哪些方面来提高存储的可靠性和生态。另外,我也会分享后续的架构,以及如何达成统一的流仓的存储。
演讲提纲:
- 实时存储现状及问题
- 流批存储概念不统一
- 流批存储复杂度太高
- Flink Table Store 0.1 实践
- 统一的 API 和易用性
- 流批统一的架构
- 实时的流消费和 OLAP 查询
- Flink Table Store 0.2 前瞻
- 目前的问题和需求
- 核心能力增强
- 加强生态
- Service 模式
- Service 的架构设计
- 实时离线一套存储
- 总结和展望
你将获得:
- 了解分布式流批一体存储相关的设计和取舍
- 了解一些技术细节
关注主办方(InfoQ)


联系我们
交通指南
广州万富希尔顿酒店
Hilton Guangzhou Baiyun
地址:广州市白云区云城东路515-517号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 15600537884

微信联系我们
票务经理