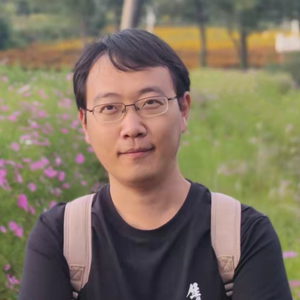
百度云原生可观测方向技术负责人,2012 年加入百度,先后负责构建运维数据仓库,网络监控平台、智能监控平台,故障自愈平台、云原生可观测平台的架构设计与研发工作。在监控与可观测领域有丰富经验。
讲师介绍
议题介绍
地点:大宴会厅 1
所属专题:云原生时代的可观测最佳实践
演讲:Prometheus 大规模业务监控实战
Prometheus 作为云原生时代指标监控的事实标准已经深入人心,其优秀的指标数据模型、强大的查询分析能力以及丰富的周边生态支持,让监控变的更加便捷易用。
但在业界常见的实践案例中,更多是介绍如何做基础的 Kubernetes、主机、中间件监控。而对于大型互联网、金融等行业,则会更加关注交易/请求量、成功率、响应时间等业务层指标监控,同时基于细分业务维度进行细粒度的故障发现与定位。这就对监控系统提出了大规模高性能、计算报警低延迟、数据高可靠、平台高可用多方面要求,对常见的 Prometheus 解决方案带来巨大挑战。
本次演讲将介绍百度云原生团队是如何针对互联网、金融等行业大规模业务监控的需求,构建基于 Prometheus 的高性能、高可用解决方案。
演讲提纲:
1. 大规模业务监控在 Prometheus 架构中遇到的挑战
- 业务监控在 Prometheus 中的落地场景
- 大规模业务监控在 Prometheus 架构下的挑战
- 大规模数据量级带来的数据采集与存储压力
- 大规模数据计算与报警带来的性能与时延问题
- 数据高可靠与平台高可用挑战
- 原生 Prometheus 的解决方法与存在的问题
2. 针对业务监控场景的高性能、高可用的 Prometheus 监控方案实践
- 高性能 Prometheus 架构实践
- 基于主动探测的探测任务负载均衡
- “降维打击”业务指标降维预聚合方案
- 高性能流式计算与报警引擎
- 时序存储降采样与高性能缓存实现方法
- 数据高可靠与平台高可用方案
- 采集层高可用容灾架构
- 计算与存储的数据高可靠保障
- 两地三中心高可用保障
- 在 Prometheus 应用中踩过的坑
- PromQL 算子带来的数据丢点与准确性问题
3. 总结与展望
- Prometheus 在业务监控应用中前景与优势
你将获得:
- 加深对 Prometheus 整体架构实现原理的理解
- 了解针对大规模监控场景下,构建高性能、高可用 Prometheus 解决方案的思路和方法
- 了解 Prometheus 生产应用中存在的坑,以及如何解决
关注主办方(InfoQ)


联系我们
交通指南
北京·四季酒店
Beijing International Convention Center
地址:北京市朝阳区亮马桥路48号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 15600537884

微信联系我们
小姐姐