2007年硕士毕业于中国科学技术大学。精通英特尔软件架构、英特尔产品与技术以及IA平台性能优化。在英特尔工作期间,为国内主流ISV开发出基于IA平台的云计算产品过程中提供关键支持,并优化了多家主要互联网公司的核心产品,使其性能提升数倍。对PyTorch,Tensorflow等AI框架有深入研究,并拥有10年以上软件优化经验。工作期间曾获得英特尔中国个人员工最高荣誉奖,与国内互联网厂商多个部门进行深度合作,并在2019年助力某云厂商云在 MLPerf 评测中创下了业界领先的 Performance/TOPS 性能记录。他致力于基于IA架构平台的深度学习、机器学习研究和在互联网行业的落地推广工作,最新工作包括创建并开源了CPU上大语言模型的极致优化方案 xFasterTransformer。
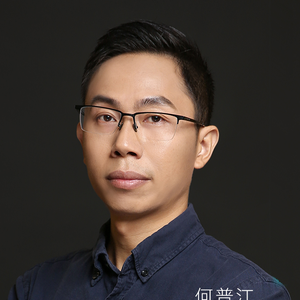
专题演讲嘉宾:何普江
英特尔数据中心与人工智能事业部AI软件架构师
by 何普江
英特尔
数据中心与人工智能事业部AI软件架构师本次演讲将探讨在大语言模型时代充分利用 CPU 资源的关键策略。具体介绍一些结合硬件特性的优化方法,例如利用 CPU 的多核特性、采用并行计算和 AMX 指令集扩展技术来提高处理速度。
此外还将介绍一种结合 CPU 和 GPU 的投机采样方法,通过在 CPU 上运行部分计算任务,充分利用 CPU 资源并减少对 GPU 的依赖。最后,我将分享一些最新的性能情况,让您了解这些优化策略的实际效果。通过这些方法,您将能够更好地利用 CPU 资源,提高模型推理速度,以更快速高效的实现生成式模型部署落地。
演讲提纲:
- 大语言模型时代为什么需要最大化 CPU 价值
- CPU 上的大模型优化策略
- 大语言模型计算特点
- CPU 硬件特性概览
- 优化方法
- 从向量化到张量化
- 从并行执行到分布式推理
- 低精度优化
- 深入 CPU 微架构的软件优化
- 各优化策略的实际性能数据对比及效果展示
- 结合 CPU 和 GPU 的投机采样方法
- CPU 和 GPU 协同工作的背景
- 投机采样技术的介绍
- 利用 CPU 进行部分计算任务的优势
- 优化方法:选择合适的投机采样策略、任务调度等
- 总结与展望
- 各优化方法的核心优势与局限性总结
- 对未来大语言模型时代的展望与挑战
听众收益点:
- 理解并结合硬件特性进行优化,提高模型推理速度和处理能力
- 了解 CPU 上的最新性能情况,为实际业务的大模型线上部署提供更多选择
- 掌握结合 CPU 和 GPU 协同工作的优化策略,减少对 GPU 的依赖,提高资源利用率
关注主办方(InfoQ)


联系我们
交通指南
上海中优城市万豪酒店
Shanghai Marriott Hotel Pudong South
地址:上海市浦东新区沪南公路7688弄上海中优城市广场1号楼1楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小姐姐