2014 年浙江大学本科毕业加入阿里,一直从事搜索推荐引擎和 AI 相关基础设施工作。参与过 HA3 搜索引擎研发,是内部系统 RankService、RTP 的核心设计者之一,在机器学习系统设计和优化方面有丰富的检验。目前是推理引擎团队 TL,负责阿里集团内核心搜索推荐、AIGC 及大模型等在线推理服务平台建设,支撑着淘宝、天猫、聚划算、优酷、闲鱼等集团内各大 BU 的业务。
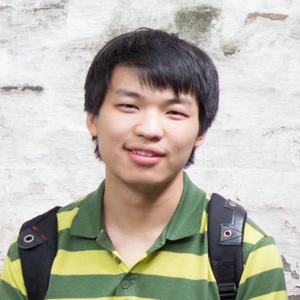
专题演讲嘉宾:刘侃
阿里巴巴高级技术专家
在大规模语言模型 (LLM) 的训练和推理实践中,工程和算法需求间存在许多需要细心权衡的问题。这些问题涉及到从软硬件协同优化,到分布式处理,以及至算法工程 Co-design 等多个领域。为了解决这些挑战,我们深入研究了不同的应用场景和流量特性,并因此对我们的系统进行了全面优化。
尽管从 HuggingFace 上可以拿到 LLaMA 等模型的代码,但用自己的数据训练一个 LLaMA 模型对个人用户或中小型组织并不是一件低成本且简单的工作。Megatron-LLaMA 框架基于有着成熟社区的 Megatron-LM 项目,充分降低了 LLaMA 等开源模型的训练成本和门槛。
Megatron-LLaMA 中包含了:
1. 基于社区 HuggingFace LLaMA 模型的续训能力;
2. 在不同规模、硬件上大模型训练的最佳实现;
3. 针对训练成本的性能优化。
在推理方面,基于 TensorRT LLM,我们进一步研发了 Maga Transformer 框架和 LLM 推理平台产品。这个系统通过应用一套统一的框架和多种不同的策略,成功地优化了不同推理场景下的成本和用户体验。我们全面支持各种开源和内部 LLM 模型,以 LLaMA 7B 和 Falcon 180B 为例,我们的系统达到了xxx的性能水平,这一结果充分证明了我们的系统在处理大规模数据时的卓越性能。
此外,我们的系统还广泛支持各种量化和剪枝方法,以及 KVCache Reuse、Speculative Decoding、Medusa 等辅助优化方法,这可以进一步提高推理效率并降低存储和计算需求。这一系列的特性使得我们的系统在处理大规模语言模型推理时表现出强大的竞争力。
关注主办方(InfoQ)


联系我们
交通指南
上海中优城市万豪酒店
Shanghai Marriott Hotel Pudong South
地址:上海市浦东新区沪南公路7688弄上海中优城市广场1号楼1楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小姐姐