从事 Kubernetes 和容器相关产品的开发。尤其关注利用云原生技术构建机器学习平台系统,CNCF 项目 Fluid 的联合创始人和主要维护者,也是业界第一个 GPU 共享调度的主要作者和维护者。他还是 Alluxio 开源项目的管理委员会成员(PMC Member),Kubernetes,Docker 和 Kubeflow 等社区的积极贡献者。
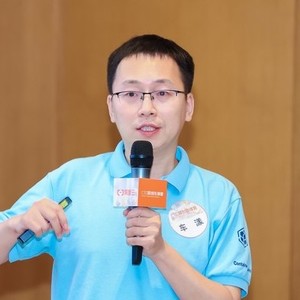
专题演讲嘉宾:车漾
阿里云高级技术专家
by 车漾
阿里云
高级技术专家人工智能生成内容(AIGC)和大型语言模型(LLM)在近一年内方兴未艾,进一步提升了大众对生成式模型的期望值。然而,正如 Gartner 报告中所提到的:“启动 AI 应用程序试点项目看起来轻而易举,但将它们部署到生产环境中则极具挑战性“。AIGC 模型推理服务相比于传统的模型,在云上的工程化落地存在许多挑战,包括如何应对模型复杂的架构和规模,计算资源需求,弹性扩缩容和模型更新等问题。而模型从存储加载到 GPU 的性能制约了弹性伸缩和模型频繁升级等核心场景。
在本次分享中,我将介绍在 Fluid 项目作为云原生AI场景下的数据和任务编排框架,在 AIGC 模型推理工程化落地方面做了许多优化探索的工作,包括简化云原生 AI 场景的分布式缓存管理和运维,降低资源成本;以及优化推理服务读取模型数据的效率,加速模型加载过程。我们也会演示如何通过 Fluid 将一个 LLM 模型的推理加载速度提升近7倍,同时提供缓存弹性的能力,避免资源浪费。
演讲提纲:
- 背景与挑战
- AI/大模型应用云原生化的趋势
- AIGC 模型推理服务在云原生场景下的痛点和挑战
- Fluid 对于 AIGC 模型推理场景的优化实践
- Fluid 简介
- 可自运维的计算側分布式缓存
- 数据流编排实现大模型缓存的自动化管理
- 数据访问性能优化
- 用户案例 & 演示
- 总结和展望
听众收益点:
- 理解 AIGC 模型推理服务在云原生工程化落地中的挑战
- 对 Fluid 项目的了解,包括其背景、目标和优化方法,以及解决缓存管理、资源成本降低和模型加载效率的具体策略
- 学习解决云上 AIGC 模型推理服务挑战的实际方法,可以应用在类似场景和问题,并且通过演示了解实际效果
- 探讨未来展望和可能的改进方向
关注主办方(InfoQ)


联系我们
交通指南
上海中优城市万豪酒店
Shanghai Marriott Hotel Pudong South
地址:上海市浦东新区沪南公路7688弄上海中优城市广场1号楼1楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小姐姐