伴随着人工智能在各行各业的深入应用,底层的基础架构也跟着不断升级,以满足其日益增... 展开 >
AI 基础架构
会议室:紫禁厅 2出品人:郑曌
- Topic 1
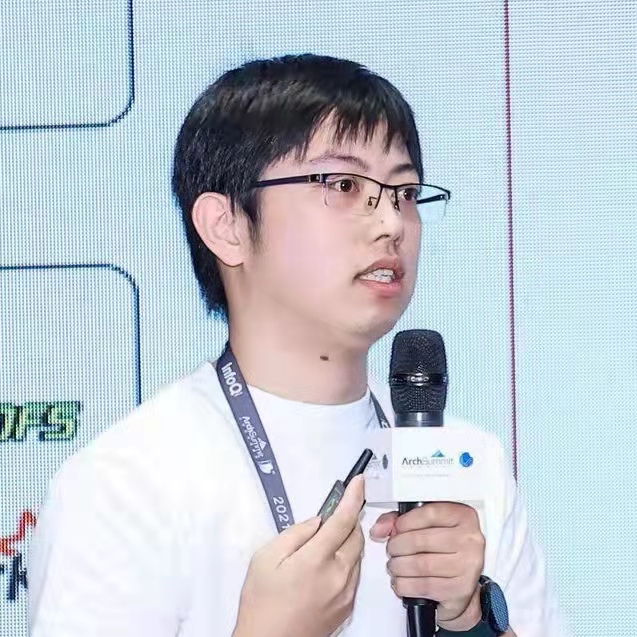
陈迪豪
第四范式 平台架构师 - Topic 2
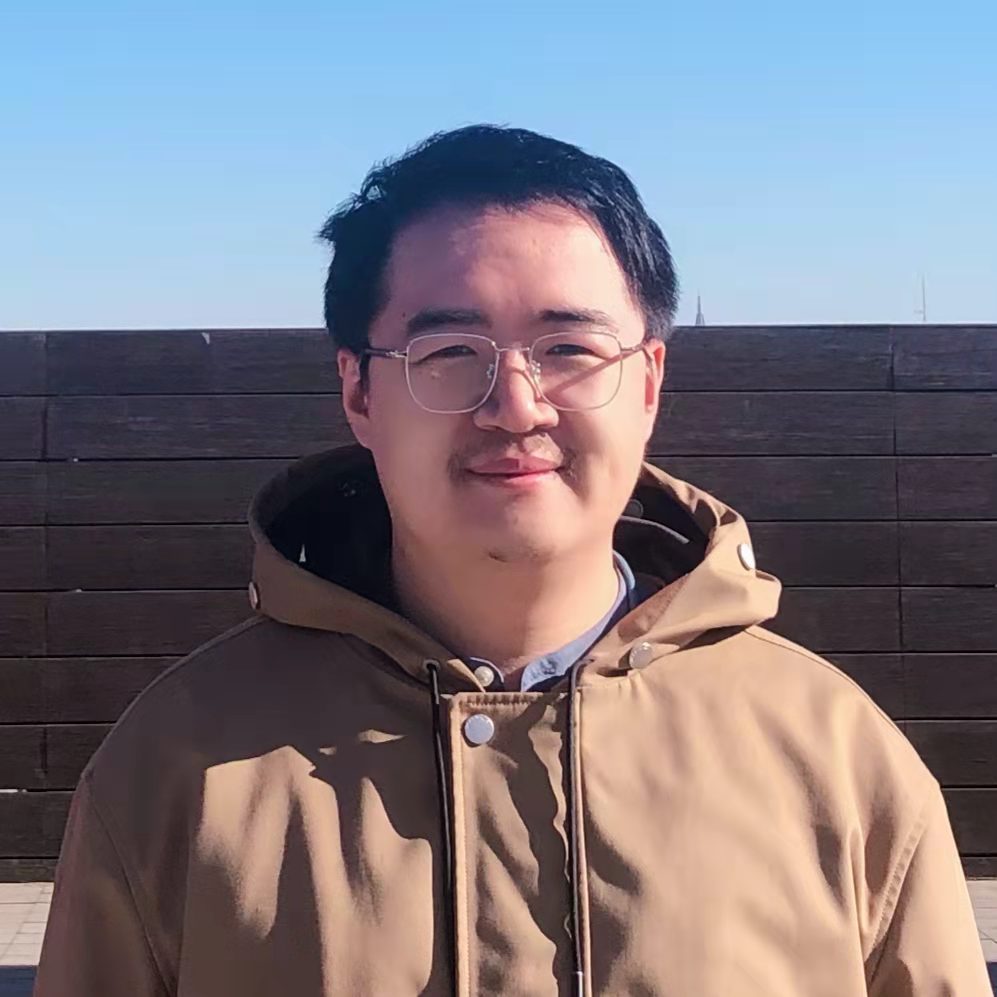
孙鹏
百度 资深研发工程师 - Topic 3
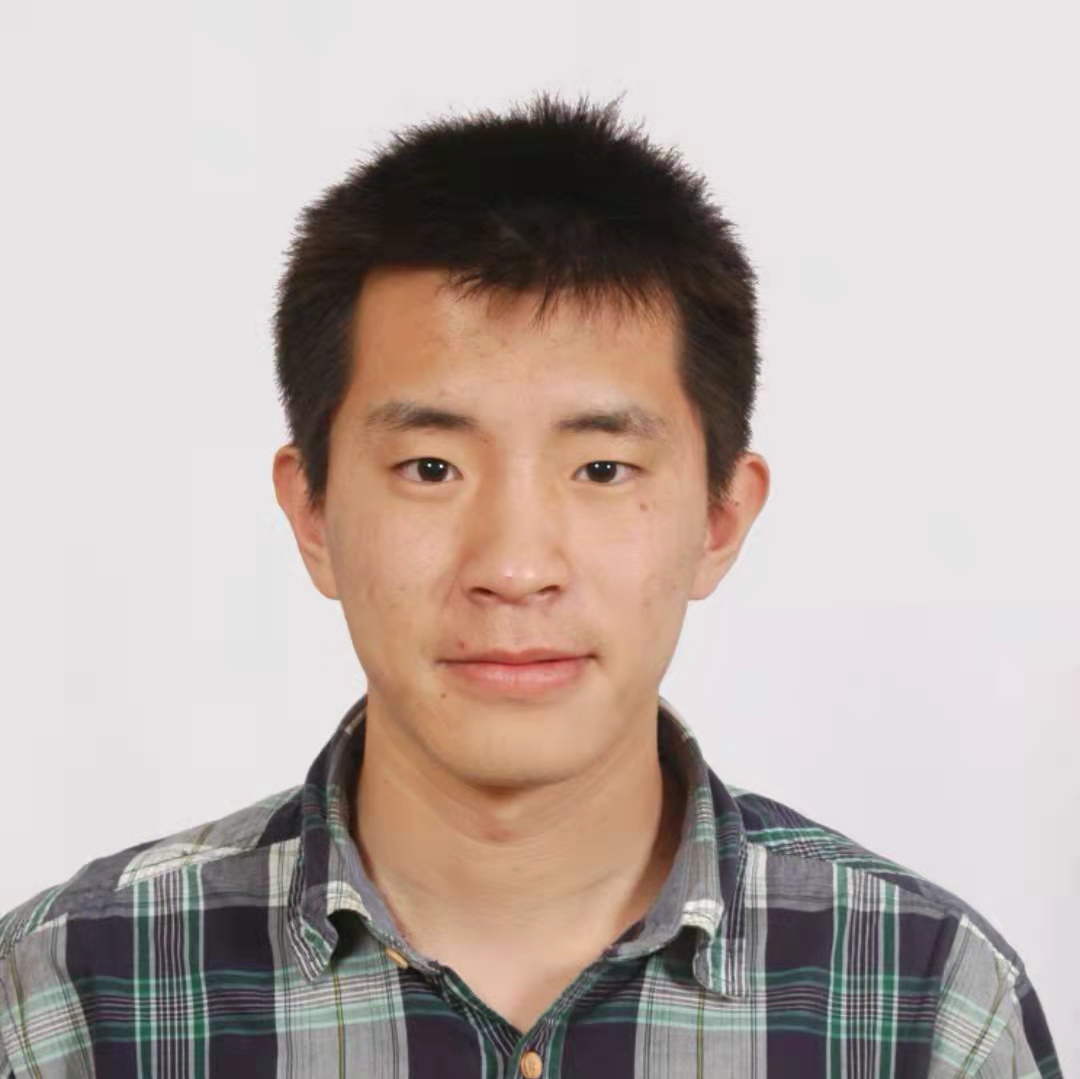
栾小凡
Zilliz 合伙人 - Topic 4
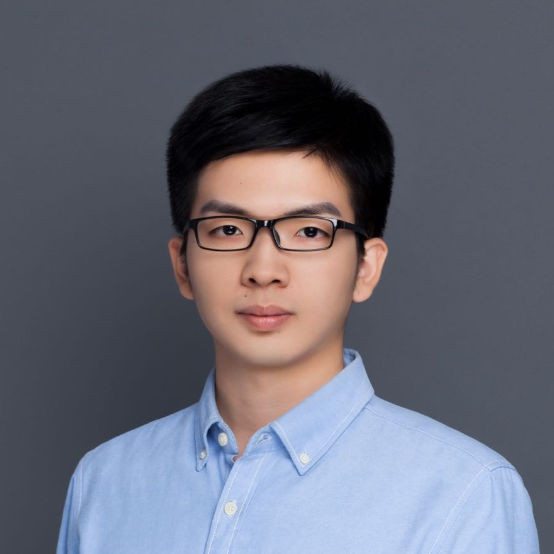
江逸敏
火山引擎 AML机器学习系统工程师
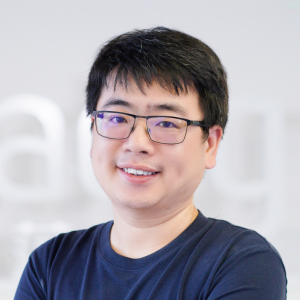
专题出品人:郑曌
第四范式研发副总裁、基础技术负责人
第四范式技术架构委员会主席,主持设计、带领团队攻坚开发自主可控的自动机器学习技术、大规模分布式计算框架、机器学习数据库等核心技术;主持设计与研发中国市场份额第一的AI操作系统 Sage AIOS,作为核心系统支撑并覆盖诸多AI应用场景,构建从营销、风控、反欺诈、运营等全生命周期的AI业务场景;主持设计国内首个开源AI操作系统内核 OpenAIOS 及开源机器学习数据库 OpenMLDB,所主导的 OpenMLDB 优化创新论文被国际数据库顶会 VLDB 录用。软件定义算力技术总设计师、主导设计国内首个以AI为驱动的算力平台。曾任 Pinterest 个性化推荐与搜索部门技术负责人、Google 展示广告架构团队架构师,拥有丰富的分布式机器学习系统架构、个性化推荐架构经验。计算机编程“奥林匹克”ACM大赛世界冠军。
地点:紫禁厅 2
专题:AI 基础架构
伴随着人工智能在各行各业的深入应用,底层的基础架构也跟着不断升级,以满足其日益增大的强算力、高性能需求。本专题将聚焦 AI 的基础设施变革。
by 陈迪豪
第四范式
平台架构师AI 已经成为计算机基础架构中不可或缺的一环,而针对 AI 场景优化的数据库也应运而生。AI 数据库不仅功能上要满足特征工程以及机器学习模型的上线需求,在离线和在线性能上也有更高的要求。数据库的内存优化不仅可以让线上服务器存储更多在线数据,在离线分布式计算上也可以让每个分区占用资源更少,计算性能也有大幅提升。OpenMLDB 是针对 AI 场景深度优化的数据库,为了实现以上内存优化目标,设计并落地了一套内存优化方案,希望通过精巧的内存布局设计以及跨语言指针传递来实现极致的性能优化。但在实际做的过程中,我们也遇到了内存格式不匹配、跨语言数据传递等问题,最终通过统一编解码优化方案解决了这些问题,可以实现特定场景下数倍甚至数十倍的性能提升,本次将给你分享我们的经验。
演讲提纲:
1. AI 数据库与内存性能优化
2. OpenMLDB 与 Spark 内存方案
3. OpenMLDB 统一编码优化实现
4. 内存优化在 AI 场景的应用实践
你将获得:
- 了解前沿的 AI 数据库架构设计
- 了解数据库内存优化思路以及实现细节
- 了解 OpenMLDB 内存优化在 AI 场景的实践
by 孙鹏
百度
资深研发工程师千亿、万亿、十万亿……超大规模预训练模型是目前AI行业最火热的方向之一,百度近年也分别在 NLP、VIS 等领域发布多个效果领先的超大规模预训练模型。模型参数短时间内的爆炸式增长,搭配海量训练数据,一方面为业务带来很大的生产价值,另外一方面也对基础设施的建设提出了前所未有的挑战。 本次演讲站在基础设施的视角,从超大模型训练需求出发,结合训练过程中实际遇到的生产问题,分析基础设施各环节(如单机、网络、通信、调度、框架等)的问题与优化空间,介绍相关优化技术方案、选型及最佳实践。
演讲提纲:
1. 自顶向下——超大模型训练对基础设施提出新的需求
2. 逐层拆解——从单机硬件到大规模集群各层次的问题与优化空间分析
3. 系统优化——AI工程化中软硬结合联合优化方案与案例分享
4. 未来展望——异构算力发展为大模型训练带来新的机会
听众收益:
- 了解大模型训练全过程对基础设施带来的问题和挑战
- 学习业界前沿的大模型训练软硬结合联合优化方案与效果
- 了解百度智能云从基础设施视角看未来大模型训练的观点
by 栾小凡
Zilliz
合伙人随着 AI 技术的发展,产生了越来越多的非结构化数据,如图片、视频、音频、分子式、时间序列数据、用户信息,业界通过深度学习训练生成向量,并通过向量的近似度匹配实现搜索、推荐、风控等不同的应用场景。传统向量检索的方式效率较低,扩展性差,面对海量数据愈发束手无策,这时候,Milvus 应运而生。其解决了超高维、低延迟、向量/标量混合查询和数据实时可见性等问题。
本次演讲将主要介绍如何基于云基础设施打造优质的开源向量数据库,以及向量数据库未来的发展方向。
演讲提纲:
1. 向量检索101——什么是向量检索
- Embedding - 面向非结构化数据的数据类型
- 向量数据库 vs 传统数据库
2. Milvus 2.0——下一代云原生向量数据库
- 向量数据库面对的新 Tradeoff
- 以日志为中心
- 批流一体化
3. 云原生实践
- 微服务化设计带来的复杂度
- 多云/开源下复杂依赖治理
- 可观测性
4. 向量数据库未来展望
你将获得:
- 了解 AI 基础设施当下最新的演进趋势
- 了解向量检索的使用场景
- 学习云原生的设计理念以及 Milvus 社区在云原生的实践经验
by 江逸敏
火山引擎
AML机器学习系统工程师字节跳动已是全球最大的信息产生与分发平台之一。为将信息准确地传递到相应的受众上,机器学习技术发挥了至关关键的作用。因此,机器学习模型的迭代速度也直接影响了公司业务的发展速度。在大模型、大数据的今天,大规模的分布式训练成为加速模型训练的必需条件。然而,模型参数量大、分布式计算的节点间通信带宽受限等诸多因素,使得提升大规模训练的效率成为挑战。本次分享将以 CV/NLP/推荐/广告等不同场景为例,介绍字节跳动在大规模训练方向的技术实践和经验总结。具体技术方面将涉及到训练通信架构、RDMA 传输优化、大模型的切分策略等,最终目标都是加速端到端的训练速度。这些实践使我们能够更好地支撑公司业务的发展。
关注主办方(InfoQ)


联系我们
交通指南
北京·四季酒店
Beijing International Convention Center
地址:北京市朝阳区亮马桥路48号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询


电话咨询
联系电话:+86 15600537884

领取往期热门演讲视频
小姐姐