大模型带来了 AI 开发新范式,全新的 LMOps 登场,这里面,构建高质量数据... 展开 >
从 MLOps 到 LMOps
会议室:首府 5出品人:谢永康
- Topic 1
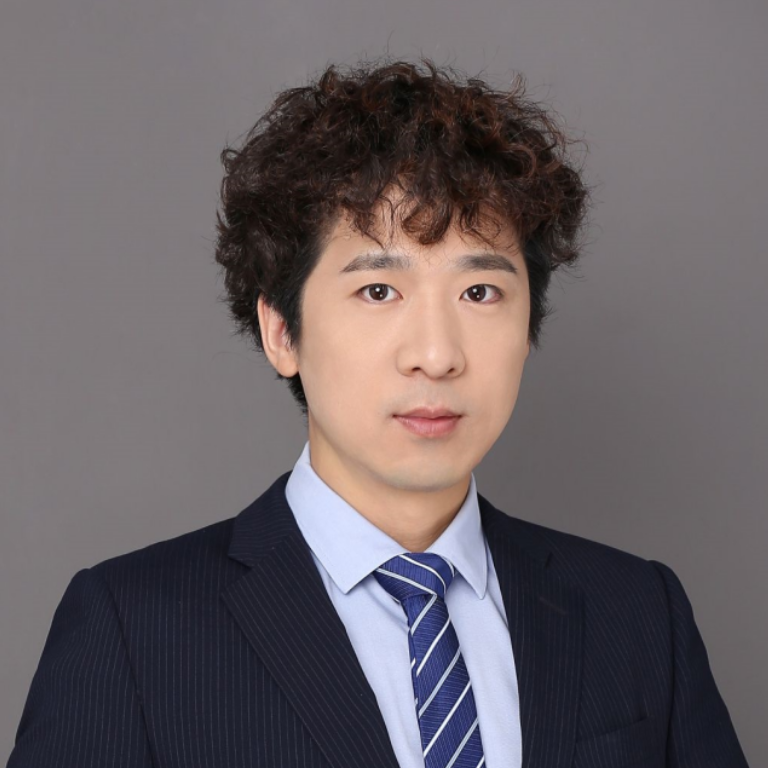
靳伟
百度智能云 千帆大模型平台产品架构师 - Topic 2
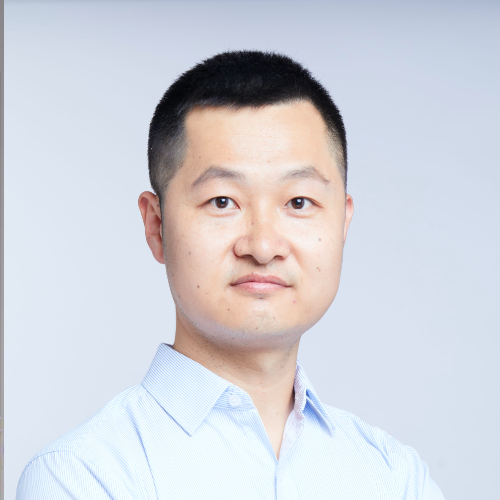
刘喆
白海科技 联合创始人兼技术负责人 - Topic 3
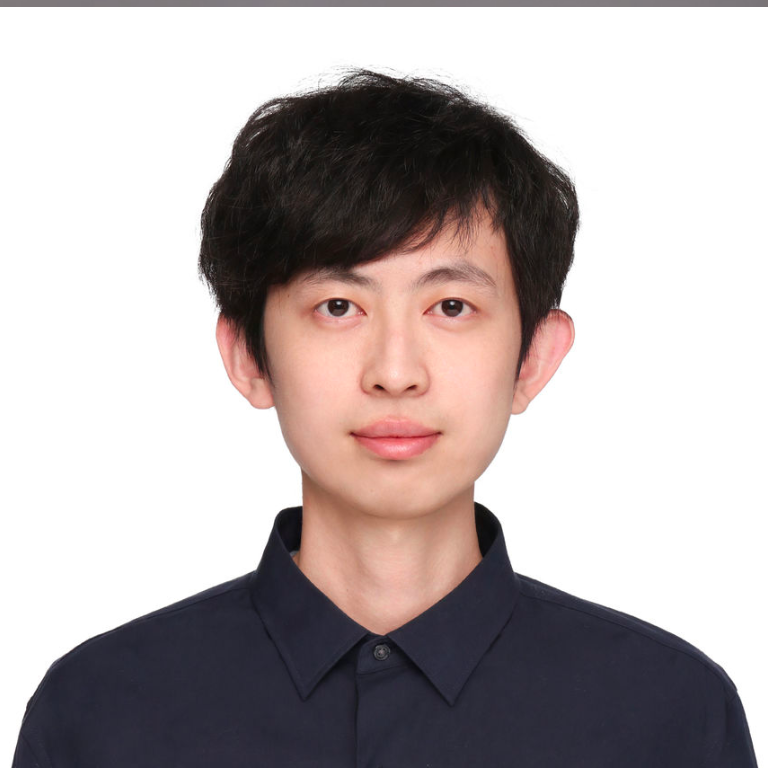
高策
TensorChord 联合创始人兼 CEO - Topic 4
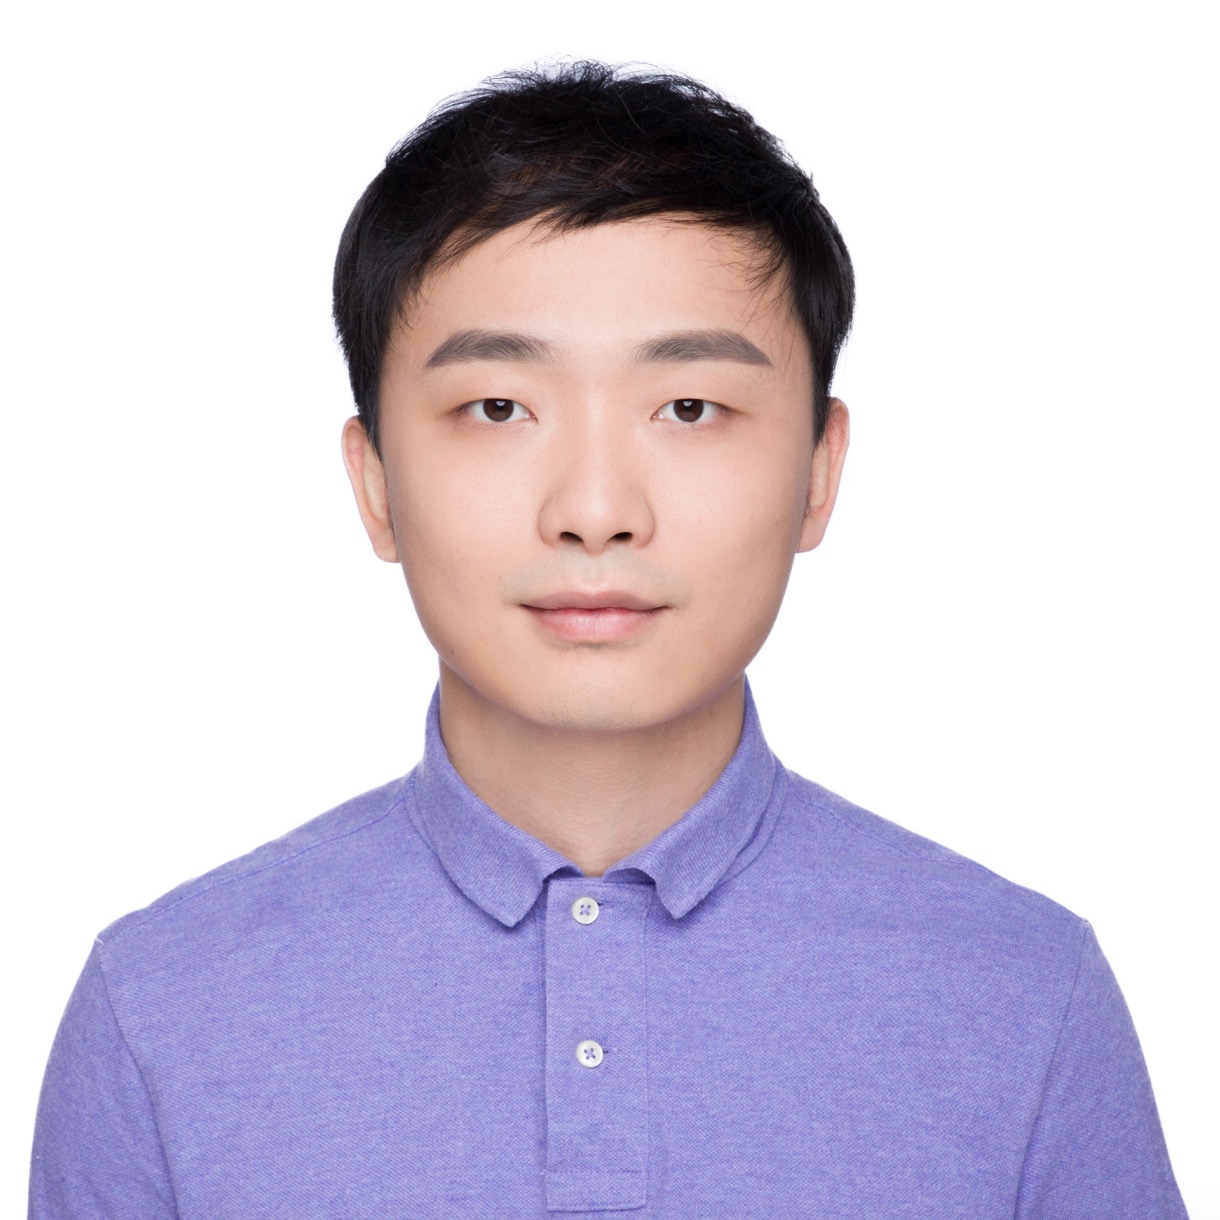
张路宇
Dify.AI 创始⼈
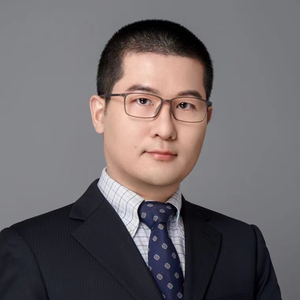
专题出品人:谢永康
百度 AI 中台总架构师
2009 年复旦大学自然语言处理和机器学习方向硕士毕业后加入百度。先后在日文搜索、凤巢策略、大数据和 AI 平台技术部门负责平台架构和算法设计。主导了百度统计、EasyDL、BML、千帆等大数据和 AI 平台的建设,在大数据和 AI 领域有十余年的系统设计和场景化应用经验。目前,担任百度 AI 中台总架构师。同时,是上海人工智能标准化技术委员会委员。
地点:首府 5
专题:从 MLOps 到 LMOps
大模型带来了 AI 开发新范式,全新的 LMOps 登场,这里面,构建高质量数据集、数据清洗是关注的重点。
by 靳伟
百度智能云
千帆大模型平台产品架构师这次演讲将探讨从 MLOps(机器学习开发运营一体化)到 LMOps(大模型开发运营一体化)的关键技术嬗变。我们将介绍 MLOps 的挑战以及解决方案。随后,我们将聚焦 LMOps,探讨大模型带来的新问题,并深入探讨 Prompt 管理、Context 外推、量化、剪枝等关键技术。此外,我们将讨论实施 LMOps 所面临的挑战,如资源管理和部署复杂性,并探讨未来的发展方向。
演讲提纲:
1. 引言
- 介绍演讲主题:从 MLOps 到 LMOps 的技术演进
- 解释 MLOps 和 LMOps 的概念:机器学习开发运营一体化和大模型开发运营一体化
2. MLOps 概述, 挑战与解决方案
- 简要阐述 MLOps 的定义和重要性
- 探讨 MLOps 实施过程中的挑战:数据质量、模型漂移、环境一致性等
- 分享应对这些挑战的解决方案:持续集成/持续交付、自动化测试、模型监控等
3. LMOps 的兴起
- 分析大模型引发的新问题:参数量大、训练时间长、推理成本高等
- 解释为何需要 LMOps 来支持大模型的开发和部署
4. LMOps 实施挑战与对应技术策略
- 讨论 LMOps 引入的新挑战:资源管理、调试困难、部署复杂性等
- Prompt 管理:如何获取和管理 Prompt
- Context 局限:如何延长 Context
- 大模型压缩:介绍模型量化和剪枝等技术,减少模型体积和推理成本
5. 未来展望
- 探讨 LMOps 未来的发展方向:更智能的资源管理、跨模型优化等
- 强调 LMOps 在支持 AI 创新和研究方面的重要性
你将获得:
- 深刻理解从 MLOps 到 LMOps 的演进过程以及掌握在大模型时代应对挑战的关键技术
- 收获关于 Prompt 管理、Context 外推、大模型压缩等实用技能,帮助你们更高效地开发、部署和管理庞大复杂的模型
- 对如何应对大模型运维中的各种挑战有清晰的策略,为未来的 AI 创新和研究做好准备
by 刘喆
白海科技
联合创始人兼技术负责人LLMOps,即 Large Language Model Operations,是指对大语言模型全生命周期的运营,以确保大语言模型落地的高效、稳定。LLMOps 是 AI 研发的新范式:包括一系列技术和工具,支持大模型的开发、训练、优化和部署等全流程工作。
白海科技研发了低门槛的 LLMOps 工具——IDP LM。用户可以零代码一站式完成数据清洗、训练、评估和部署等全流程。我们重点优化了多机多卡分布式情况下的数据预处理、模型训练的优化,并自动处理了反馈数据回流审核和模型评估。
LLMOps 目前仍处于新兴领域,处于快速发展和高速迭代之中。目前在降低大模型训练成本、微调门槛以及提升大模型推理速度等方面,仍需要持续不断地努力和探索。
演讲提纲:
1. 介绍 LLMOps :概念、起源、与MLOps的对比
- LLMOps 诞生:解决大模型训练挑战的必然选择
- 对比 LLMOps 与传统MLOps:数据处理、实验过程、评估方法等
- 目前典型的 LLMOps 工具分析
2. 白海科技实践经验分享:构建高效的 LLMOps 平台
- 大规模数据处理:数据预处理与增强
- 模型微调训练:微调流程的工具化、大规模分布式训练优化等
- 模型评估:自动评估与人工评估
- 模型部署:量化、格式转换、Task 分配等
3. 面向未来: LLMOps 的应用前景
- AI 平台建设
- 从 MLOps 到 LLMOps 的必由之路
- LLMOps 的未来发展
- 大模型驱动 AI 应用:LLMOps 的典型应用案例
你将获得:
- 了解 LLMOps 的概念及其在大模型落地应用中的重要性
- 掌握 LLMOps 与传统 MLOps 的差别,深刻理解大模型训练的挑战
- 听取来自实践的经验分享,学习构建高效、稳定的 LLMOps 平台的最佳实践
- 预测 LLMOps 的发展趋势及其在未来 AI 应用中的前景,拓展技术应用的视野
by 高策
TensorChord
联合创始人兼 CEO生成式模型在 NLP、图像生成等领域有着广泛的应用,但其复杂的部署需求往往成为一大挑战。以 LLM 为代表的生成式模型相比于传统的模型,具有更多的模型参数、需要更多的 GPU 算力与显存。通过采用无服务器架构,我们可以有效地解决这些挑战,并实现高效、灵活、可伸缩的模型服务。
在本次分享中,我们将首先介绍生成式模型部署时遇到的挑战,以及我们如何使用 Serverless 架构来解决这些挑战,如将模型容器化并部署到无服务器环境中,利用服务指标进行自动扩缩容,进行模型和镜像加载的加速等。
演讲提纲:
1. 背景与挑战
- 生成式模型的应用与分类
- 图像生成和 LLM 不同的模型特点与各自部署的挑战
- 弹性部署为生成式模型带来的好处
2. 已有系统对生成式模型的部署支持
- kserve、seldon core 等已有系统对生成式模型的部署支持
- 已有系统的不足之处
3. 新的系统设计
- 设计目标:多框架支持、Scalability、易用性
- 架构设计:Kubernetes 原生的设计、指标的选择与采集、模型调用与监控、为易用性做的诸多设计等
4. 基于新系统的部署实践
- 通用的优化策略:镜像加速、节点预热等
- LLM 的部署实践:模型加载的加速、如何支持上线前的模型服务器参数调整等
- Stable Diffusion 的部署实践:Web UI 启动速度优化、Gradio/Streamlit 等框架的支持等
5. 总结与展望
- 新的挑战:存储系统的优化、冷启动、containerd snapshotter 的优化等
- 未来展望:LLM 模型的收敛、开源模型 vs 闭源模型、模型与向量召回的联合训练与部署等
你将获得:
- 理解无服务器架构:您将了解无服务器架构的基本概念和特性,了解其如何为生成式模型的部署提供解决方案
- 解决部署挑战:您将了解到生成式模型部署所面临的挑战,并学习如何应对模型大小、计算资源需求和模型更新等问题
- 部署实践分享:您将获得实践经验和最佳实践的分享,帮助您在实际应用中更好地部署生成式模型
- 未来发展趋势:您将了解无服务器模型服务在生成式模型部署领域的潜力和挑战,为您在未来的工作和项目中提供前瞻性的思考和决策依据
by 张路宇
Dify.AI
创始⼈LLM 应⽤从 Hard Coded 到 AutoAgent as Service 的技术演进脉络中,LLMOps 在其中举⾜轻重。本次演讲的核⼼重点在于深⼊剖析了私有化数据在 LLM 落地过程中的关键作⽤。通过透彻阐明私有化数据清洗与嵌⼊的技术原理,通过 RAG 索引增强⽣成、内容增强⽣成、模型增强的以及数据嵌⼊经济学的实践案例,全⾯系统诠释⾼质量私有化数据是实现 LLM 强⼤推理能⼒的基⽯。 最后,通过 Dify.AI 的开源实践共同解锁⼤语⾔模型的⽆限可能。
演讲提纲:
1. LLM 应⽤技术栈全景
- 解析当前 LLM 应⽤⼯程⾯临的挑战 :从 Hard Coded 到 AutoAgent as Service 的⼯程演进
- 为什么需要 LLMOps:基于运⾏数据持续改进模型与应⽤
- 被低估了的 Prompt ⼯程:从 Design First 到 Prompt First 编程协作变⾰
2. ⼤模型应⽤落地挑战:私有化数据清洗与嵌⼊
- 私有化数据清洗与嵌⼊的技术原理:从嵌⼊到微调的技术阶梯
- 数据嵌⼊经济学:⾃定义分段模式、Q2Q 匹配⽅式与聚点萃取总结压缩⽅法
- 模型能⼒与检索的增强(RAG):通过编排、索引、插件实现嵌⼊⽣成到推理⽣成的进化
- Dify 私有化数据清洗与嵌⼊实践:构建针对业务场景优化的 AI 应⽤
3. Dify.AI 的开源⽣态构建
- Dify 180 天的故事:开源产品的研发经历与挑战
- 依靠开源社区⽣态⼒量,让所有开发者低成本获得 LLM 应⽤开发的能⼒
你将获得:
- 全⾯解析 LLM 应⽤技术栈:学习当前 LLM 应⽤从 Hard Coded 到 AutoAgent as Service 的技术演进,以及 LLMOps 等⼯程化平台的作⽤
- 深⼊理解 Prompt ⼯程化:通过从 Design First 到 Prompt First 的转变,学习 Prompt 设计、优化的技术⽅法
- 系统掌握数据嵌⼊技术:全⾯解析数据嵌⼊的技术原理,经济学思考,以及 RAG 相关能⼒。体验 Dify 数据嵌⼊的⼯程化实践
- 开源⼯具应⽤指南:通过 Dify 等项⽬案例,学习如何利⽤ LLM 开源⼯具提升⾃身应⽤开发能⼒,降低应⽤落地成本
- 提升 LLM 应⽤开发技能:通过对 LLM 应⽤全流程的理解,获得应⽤需求分析、数据处理、Prompt 设计、模型训练、部署落地等⽅⾯的技术指导
关注主办方(InfoQ)


联系我们
交通指南
北京·富力万丽酒店
Renaissance Beijing Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小姐姐