由浅入深,由理论到实践讲解某一技术细节,帮助听众掌握具体的实践流程,解决工作中的... 展开 >
深度培训
会议室:待定- Topic 1
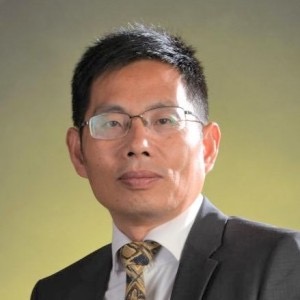
范煜
中国商业联合会 数据分析专业委员专家 - Topic 2
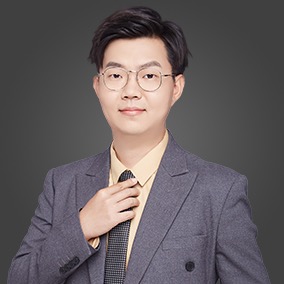
陈旸 博士
阿里云 MVP,数字化转型专家
专题:深度培训
由浅入深,由理论到实践讲解某一技术细节,帮助听众掌握具体的实践流程,解决工作中的问题。
9 月 北京
- 9月1日(周五)《基于开源大模型,如何一步一步自己搭建一个自己的私有模型》
- 9月2日(周六)《基于大模型的私有知识应用开发》
by 范煜
中国商业联合会
数据分析专业委员专家ChatGPT 的成功激励很多大公司在开发类似系统,和 OpenAI 公司竞争。但大多数人还是希望借助ChatGPT 的东风,利用 ChatGPT 类似技术开发私有模型,加入自有知识库实现本地化部署。不幸的是ChatGPT 没有开源,而且目前还没有对中国开放,因此如果想依赖 OpenAI 的 API 开发类 ChatGPT 是不可行的。此外,要训练自己的大语言模型成本太高。目前最佳路径是利用现有的预训练大语言模型进行指令微调,训练出自己的类 ChatGPT 私有模型。
类 ChatGPT 私有模型的开发吸引了很多人的投入,发展很快。目前主要基于 Meta 的 LLaMA 模型。OpenAI 看到 LLaMA 模型开放后吸引了很多开发者,一虎难敌群狼,所以也有开源 GPT3 的计划。LLaMA 模型的硬伤是不支持商用,性能更好的阿联酋技术创新研究所(TII)的 Falcon 40B,现在免收特许权使用费,未来有可能替代 LLaMA 的地位。
本课程从技术和实战角度介绍了类 ChatGPT 私有模型开发过程,涉及现有的预训练模型的增量训练、指令微调、中文支持、推理模型部署、数据集格式等,一步一步指导你搭建一个自己的私有模型。
课程大纲:
- 搭建你自己的私有大模型
- 模型选择
- 预训练大语言模型
- 指令微调模型
- 量化模型
- 推理模型部署
- LangChain 开发
- 训练你自己的私有大模型
- 预训练大语言模型(LLM)的选择
- 增量预训练预权重合并
- 监督微调(SFT)数据集
- 监督微调(SFT)训练
- 模型部署
- 实操环节设置
- 服务器开发环境安装
- LLM 权重文件下载
- LLM 增量训练语料(自有资料)准备
- LLM 增量预训练
- LLM 增量权重文件的合并
- SFT 训练数据(自有知识库)准备
- SFT 训练
- SFT 增量权重文件的合并
- 模型推理服务部署
目标人群:
创业者、企业中高管、相关项目负责人,具有 Linux 和 Python 语言基础
现场开发环境建立:
- GPU 服务器、Linux 操作系统
- PyTorch、Transformer 开发环境
- 模型库:已有微调模型权重文件、LLaMA 预训练模型的权重文件
- 利用已有微调模型,部署推理服务,可以输入一段文字,生成后续内容
- 自己进行微调生成模型,需要在预训练模型(如LLaMA)上,准备数据集,进行监督微调训练,生成的模型可用于推理
学员收益:
- 深入了解大语言模型:学员将了解大语言模型的原理、应用领域和潜力,掌握如何将自有知识加入大语言模型中;
- 私有知识应用开发技能:学员将学习如何搭建私有化大模型、开发及部署个性化、安全性强的企业内部类 ChatGPT 应用。他们将掌握 LangChain 开发、预训练模型的增量训练及监督微调等关键技能;
- 企业场景应用:构建企业内部知识智能客服、开发私有知识问答系统等。这将帮助他们将所学应用于实际工作场景中,提升工作效率和解决业务挑战。
by 陈旸 博士
阿里云 MVP,数字化转型专家每个企业都需要将内部的经验、案例、最佳实践等萃取为规律,然后在日常工作中进行推广和使用。比如:项目流程管理,项目施工标准,新产品设计方法,业务流程优化,内部知识管理,法务合同审核,政策合规审核等;
本工作坊旨在帮助您掌握利用大型语言模型构建私有知识应用,将企业的私有知识进行有效的萃取及利用。共同探索大模型的潜力,并掌握如何开发个性化、安全性强的企业内部私有知识应用。
课程大纲:
一、搭建你的私有化大模型:
- 开源大模型:LLaMA, Alpaca, Vicuna
- ChatGLM-6B 与 ChatGLM-130B
- ChatGLM-6B 使用(预训练模型)
- ChatGLM-6B 定制(训练你的模型)
- Lora 原理
二、LangChain 开发:
- LangChain 核心组件
- Models,Prompts,Chains
- Memory,Agents,Indexes
- Agent 设计
- ReAct 范式
- Case:动手搭建一个本地知识智能客服
三、企业私有知识问答系统:
- 内部知识管理:PDF,Word 解析
- 向量数据库使用
- 搭建本地知识智能问答(LangChain + ChatGLM)
- WebUI 搭建
四、实操环节设置:
- ChatGLM 训练与微调
- 使用 LangChain 搭建本地知识智能客服
- 企业私有知识问答系统
- 数据解析与切分
- 向量数据库使用
- LangChain+ChatGLM
- WebUI 搭建
目标人群:
- 企业中高管,项目负责人,业务负责人、数据分析师、业务人员
学员收益:
- 深入了解大型语言模型:学员将了解大型语言模型的原理、应用领域和潜力,掌握如何有效利用大模型进行知识应用开发;
- 私有知识应用开发技能:学员将学习如何搭建私有化大模型、开发个性化、安全性强的企业内部私有知识应用。他们将掌握 LangChain 开发、ChatGLM 训练与微调、向量数据库的使用等关键技能;
- 实践能力提升:通过实操环节设置,学员将亲自动手进行 ChatGLM 训练、LangChain 开发和 WebUI 搭建。这将帮助他们加深对知识应用开发流程和方法的理解,并提升实践能力;
- 企业场景应用:构建企业内部知识智能客服、开发私有知识问答系统等。这将帮助他们将所学应用于实际工作场景中,提升工作效率和解决业务挑战。
动手操作环境:
- ChatGLM 训练与微调
- 使用 LangChain 搭建本地知识智能客服
- 企业私有知识问答系统
学员要求:
- 准备本地安装 Python,或者有 Google Colab 账号
关注主办方(InfoQ)
联系我们
交通指南
北京·富力万丽酒店
Renaissance Beijing Hotel
地址:北京市朝阳区东三环中路61号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小姐姐