主要负责公司技术与研发活动的管理和规划,带领团队建设【DOTS-AD自动驾驶平台】、【大模型服务平台】等众多核心产品。曾就职于微软互联网工程院,担任首席研发总监一职。负责的工作包括:利用机器学习提升必应搜索引擎的文本理解和文本摘要能力,利用NLP和数据挖掘等技术打造大规模中文知识库,利用分布式高并发技术建立全球地理信息数据处理平台;贡献覆盖必应搜索、必应网典、微软地图等多款微软重要互联网产品。
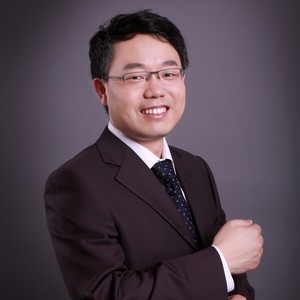
专题演讲嘉宾:黄宇凯
海天瑞声首席技术官兼自动驾驶事业部总经理
by 黄宇凯
海天瑞声
首席技术官兼自动驾驶事业部总经理目前,大模型对 AI 训练数据的质量要求不断上升,数据模态呈多样化。文成图、图生文、文生视频等技术不断涌现,本次演讲将会对多模态大模型的底层数据构建进行解析,以及目前多模态大模型数据需求与挑战,并阐述如何通过高质量训练语料激发多模态大模型展现出更为强大和灵活的潜力,生成持续时间、宽高比和分辨率多样的视频和图像。同时也将会围绕海天瑞声多模态数据标注平台功能以及背后的硬核技术进行讲解,提高数据的生产效率。
演讲提纲:
- 大模型发展趋势——多模态
- 多模态大模型底层数据构建
- 多模态大模型数据需求与挑战
- 多模态数据标注平台功能及技术解析
听众收益:
- 多模态大模型底层数据架构以及目前多模态大模型所面临的数据需求及挑战;
- 如何通过高质量训练语料激发多模态大模型展现出更为强大和灵活的潜力,生成持续时间、宽高比和分辨率多样的视频和图像;
- 最前沿的多模态数据标注平台功能以及背后的硬核技术。
内容亮点:
- 文生图、文生视频技术不断涌现、Sora 大模型底层数据架构解析
- 目前大模型的数据需求及挑战
- 最前沿的多模态数据标注平台功能以及背后的硬核技术
关注主办方(InfoQ)


联系我们
交通指南
北京国测国际会议会展中心
GUOCE International Convention And Exhibition Center
地址:北京市顺义区临空经济核心区汇海南路6号院20号楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 17310043226

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手