安全威胁和挑战一直存在,本专题将聚焦数据安全技术的最新进展,不仅关注如何利用大模... 展开 >
大模型助力数据安全
会议室:国粹厅出品人:孟昌华
- Topic 1
申书恒
蚂蚁集团 大安全风险图、端智能、全网巡检算法负责人 - Topic 2
江明
抖音集团 业务安全质量保障的负责人
万明阳
字节跳动 智能服务算法团队 Tech Leader - Topic 3
Nicky
腾讯 朱雀实验室蓝军负责人
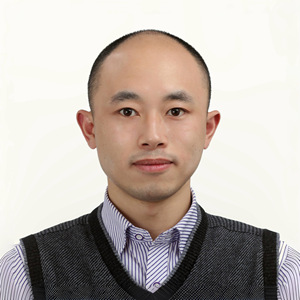
专题出品人:孟昌华
蚂蚁集团安全服务智能部总监
孟昌华,蚂蚁集团安全服务智能部总监,负责蚂蚁集团安全大模型算法及建设,专注 AI 在安全场景的算法研发和落地应用,推动交互式风控、大规模实时图在蚂蚁安全的应用落地。主导研发的 AI 安全对抗检测平台“蚁鉴”,获世界人工智能大会镇馆之宝。持续致力于 AI 安全的前沿研究,带领团队获得 KDD CUP 等多项顶级赛事的冠军,并在 NeurIPS、ICLR、CVPR 等多个人工智能顶会发表多篇学术论文。
地点:国粹厅
专题:大模型助力数据安全
安全威胁和挑战一直存在,本专题将聚焦数据安全技术的最新进展,不仅关注如何利用大模型在数据安全领域实现实际应用,还将着重探讨大模型本身所面临的数据安全问题。
by 申书恒
蚂蚁集团
大安全风险图、端智能、全网巡检算法负责人大模型时代,数据安全问题重要性愈加凸显,例如常见的大语言生成模型如 ChatGPT 和图像生成模型 Stable Diffusion 等需要大量的数据进行训练,这些数据中不乏个人信息、商业机密等隐私敏感信息,暴力、恐怖、涉政等法律违规信息,以及部分训练数据的知识产权信息等。确保大模型生成内容的数据安全变得尤为关键。
在过去的一年中,我们在大模型主体的数据安全测评以及实时调用大模型时的内容数据安全检测方面进行了一些系统性的思考和设计,本次演讲将分享我们的实践与探索。
演讲提纲:
1. 大模型时代的数据安全威胁
2. 大模型主体的数据安全测评体系
3. 大模型应用时输入内容和生成内容的数据安全检测系统
听众收益:
- 了解大模型时代带来的数据安全挑战
- 共同探讨大模型数据安全问题上的测评方案和防御系统
方案痛点:
- 数据安全检测需要做到既准又全,同时保障用户体验和风险可控
- 由于大模型本身的推理耗时已很高,为保障用户体验,对数据安全检测系统的效率要求极高
LLM 在广泛任务中表现出了超凡的能力。当前已经部署在许多下游应用程序中。然而 LLM 作为生成任务时,也存在潜在风险,特别是在安全场景,LLM 可能会生成涉及隐私、违法犯罪、公序良俗等有害或误导性的内容。为了有效利用 LLM 的能力,并确保其安全和有益的发展,对 LLM 进行严格和全面的评估至关重要。字节跳动的抖音、剪映等多个业务场景,都在推进 LLM 能力的应用和落地,在上线前需要建立 LLM 安全智能评测能力,通过自研的一站式 LLM 安全评测服务,已支持 600+LLM 评测任务。
by Nicky
腾讯
朱雀实验室蓝军负责人当今的 AIGC 热潮下,大模型的训练、部署与应用构建通常依赖于庞大且复杂的开源 AI 生态,而在过去的 2023 年中,PyTorch 等多个开源 AI 组件爆出了供应链投毒事件,OpenAI 也因开源组件漏洞导致部分用户数据泄露,如何解决大模型的软件供应链安全风险成为了一项巨大挑战。
腾讯朱雀实验室在近期的研究中发现并推动修复了多个知名开源 AI 组件漏洞,在为腾讯大模型业务保驾护航的同时,也为整个开源 AI 生态的安全建设贡献了力量。本议题主要分享团队相关实践经验。
演讲提纲:
- 大模型软件供应链攻击面分析
- 开源 AI 组件漏洞挖掘与治理实践
- 构建大模型软件供应链的主动安全防御体系
听众收益:
- 了解大模型面临的常见安全威胁
- 了解大模型软件供应链安全治理思路
演讲亮点:
包含多个团队发现的可影响大模型核心数据安全的知名 AI 组件 0day 漏洞案例分析
方案痛点:
目前需要投入一定人力成本人工挖掘关键开源 AI 组件漏洞
关注主办方(InfoQ)


联系我们
交通指南
北京国测国际会议会展中心
GUOCE International Convention And Exhibition Center
地址:北京市顺义区临空经济核心区汇海南路6号院20号楼

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 17310043226

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手