邵赛赛,Datastrato 联合创始人 & CTO,Apache member,Apache Spark PMC 成员,Apache Gravitino 创始人,专注于开源大数据基础软件的研发。
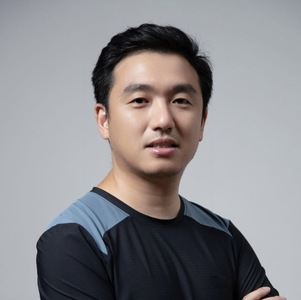
专题演讲嘉宾:邵赛赛
Datastrato 联合创始人 & CTO
在 AGI 时代,为构建一个高质量的 LLM 应用,对数据提出了新的需求。无论是数据的覆盖范围,还是数据的准确性,都对 LLM 应用的质量起到了决定性的作用。更为重要的是,LLM 使得非结构化数据的聚集以及处理变得非常关键:如何能获取并管理海量的结构化尤其是非结构化数据,如何全链路支持 LLM 的训练、调优、推理所需要的数据,解决大模型的“幻觉”,构建企业级的 RAG 应用,统一数据目录成为每个企业亟待解决的问题与挑战。本次分享会为大家介绍企业在 AGI 时代所面临的最直接的数据挑战,包括:难以高效地管理、获取全域数据,缺乏统一地进行数据治理和权限控制,传统的数据湖体系和 GenAI 框架之间的鸿沟等等。为了应对这些挑战,我们研发了Apache Gravitino项目,并做了很多前沿创新,包括:统一的结构化和非结构化数据模型来统一管理异构以及跨云跨域的数据,统一权限模型来简化云上和云下数据的管理,在主流框架如 LangChain、LlamaIndex 以及 Vector Store 的基础上构建下一代企业级 Data Agent 来解决当前 RAG 方案的系统性问题等等。除了技术设计和实现的细节,本次分享也会结合这些技术在小米的大规模实践来为大家带来下一代数据目录体系的最佳实践。通过这次分享,听众对于构建下一代面向 GenAI 的统一数据平台会有更多的实践经验。
演讲提纲
1. 背景 & 挑战
- 生成式AI时代的数据需求与上一代数据平台的 GAP 分析
- 现有技术在解决这些问题上所面临的挑战
2. 策略:通过前沿技术 Gravitino 来解决 GenAI 时代的统一数据管理
- 抽象与实现统一的数据模型,来涵盖结构化和非结构化数据
- 实现统一的异构、跨域、跨云的数据视图
3. 策略:构建统一的权限模型来统一管理云上和云下数据
- 构建一个高效且通用的 Data Agent,来支持基于文档数据库与海量数据湖的混合语义检索
4. 实践:小米构建下一代面向 GenAI 的统一数据平台
- 从业务视角看,为什么小米需要构建下一代的统一数据与 AI 资产管理平台
- 在技术选型上,小米面临哪些选择以及最终选择该前沿技术的原则和逻辑
- 在实践过程中,小米团队遇到的技术挑战,以及如何创造性的解决这些问题的
5. 总结与展望
实践痛点
AI 的统一元数据基座,在实践过程中面临几个挑战:
- 已落地的传统数据中台与中心化数仓不能满足生成式 AI 的需求
- LLM 所需要的数据类型比传统的 BI 更多,传统的结构化数据 ETL 和中心化管理已无法满足 LLM 训练、推理的数据需求
- 企业在构建统一数据管理平台时,面对多种异构数据,如何设计统一的模型和访问模式具有很高的挑战
- 更为挑战的是构建统一的权限治理模型并适配各数据源,做到统一的权限管理
演讲亮点
- 面向生成式 AI 应用来构建新型的元数据基座,为各企业和开发者提供一个 Data for AI 的最佳实践
- 在 AGI 场景如何高效和统一地管理数据提供标准化的参考技术案例
听众收益
- 了解当前生成式时代传统的数据架构的痛点
- Gravitino 的设计架构是如何解决这些痛点问题的
- 小米如何使用 Gravitino 统一管理 AI 数据,以及在落地过程中的挑战和解决方案
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手