于子淇,小红书资深技术专家,RLHF 自研框架负责人,主要从事 RLHF 系统从 0 到 1 的构建以及训推一体性能优化,帮助团队拿到端到端的模型效果收益;曾担任阿里云高级开发工程师,卓越工程师,技术布道师,参与 AIACC( DawnBench 榜单第一)加速库开发,NCCL 通讯库优化等分布式训练的性能优化工作。
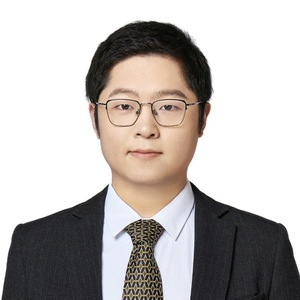
专题演讲嘉宾:于子淇
小红书资深技术专家
by 于子淇
小红书
资深技术专家多模态大语言模型(Multimodal Large Language Model,MLLM)从大规模预训练中获得图文理解、创作、知识、推理、指令遵循等能力(Capability),通过可监督微调(Supervised Finetune,SFT)激发对应的能力。除此之外,我们还希望模型输出具备特定的风格、符合人类偏好、对齐人类价值观,因此需要引入基于人类的反馈信号的强化学习方法(Reinforcement Learning from Human Feedback),进一步优化模型效果。PPO(Proximal Policy Optimization)算法是 OpenAI 在 RLHF 阶段采用的算法。PPO 算法中涉及到多个模型的协同训练和推理,设计和实现一套高效、准确的 RLHF 训练系统,是关键挑战之一。
本次演讲主要介绍小红书大模型团队自研 MLLM RLHF 训练框架的实现以及性能优化。通过训练和推理的混布调度优化等实现,保证极致的性能,希望能给大家带来一些帮助。
演讲提纲
1. RLHF 的背景
- PPO 算法
- 训练原理
- 效果评估
2. RLHF 框架设计和优化
- 基于 actor/critic 的 offload 同构组网架构
- 基于 Ray 的训推一体的训练调度优化,异步算子并发执行优化
- 精度对齐:RM 精度要求
3. 推理引擎优化
- 训推一致性
- Medusa 提升采样效率
4. 实践案例与展望
- 多模 LLM 展示
- 未来计划
实践痛点
- RLHF PPO 算法的资源消耗复杂度过高
- RLHF 训练 PPO 精度的敏感性
演讲亮点
- 收敛速度超越 trlx 1 倍
- 训练速度超越 openrlhf 1 倍
听众收益
- RLH F对于 PPO 架构上的优化
- RLHF 精度细节上的踩坑点
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手