姜慧强,微软亚洲研究院上海实验室的研究型软件开发工程师,毕业于北京大学。他的研究主要集中在高效推理和训练方法上,包括动态稀疏注意力(MInference)、提示压缩(LLMLingua)、KV 缓存压缩、推测性解码、模型压缩、稀疏推理(PIT)、神经架构搜索和高效调优,特别是在大型语言模型上。他在 NeruIPS、ACL、EMNLP、ICCV 等顶会上发表过数十篇论文,并作为审稿人和 AC 服务于社区。
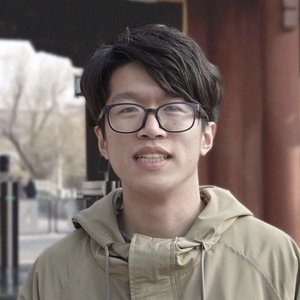
专题演讲嘉宾:姜慧强
微软亚洲研究院软件开发工程师
by 姜慧强
微软亚洲研究院
软件开发工程师Long-context LLMs Inference的prefilling 阶段由于 Computation bottleneck 造成的长时延 (单卡 A100,1M 8B 约 30 分钟) 给 Long-context LLMs 的应用造成了困难。而 Attention 尤其是Long-context Attention 实际上是非常稀疏且动态的。利用这种动态稀疏性,我们将 Long-context Attention 存在的动态稀疏归纳成三种 Pattern,通过离线搜索出每个 Head 最优的稀疏Pattern,并利用很小的 overhead 在线确定动态稀疏 index,再结合动态稀疏编译器 PIT 和 Triton 进行高效的动态稀疏 GPU 运算,产生实际加速比。我们对市面上主流的 Long-context LLMs , like LLaMA-3-1M, GLM-4-1M, Yi-200K, Phi-3-128K, Qwen2-128K 在RULER,InfiniteBench,Needle Test,LM 等任务中进行了测试,结果显示其具有几乎相同的性能。
本次演讲将主要跟大家分享 LLMs 推理算法侧优化方法,包括量化,剪枝,模型架构优化,FFN 动态稀疏计算等方面的研究和实践。
演讲提纲
1. LLMs 推理算法侧优化方法讨论:如量化,剪枝,模型架构优化,FFN 动态稀疏计算等
2. 长文本 LLMs Inference 遇到的一些挑战
- Attention 结构平方复杂度导致的 Prefilling 阶段较高的 TTFT
- 解码阶段 KV cache 存储压力,计算要提供一个合理 TTFT 的 API 服务理论上需要对 Attention 进行多少倍加速
3. 研究思考
- 优化 Long-context LLMs Inference 的相关方法,包括 training from scratch 和 training-free 两大类方法。
- Attention 是动态稀疏的,Attention 的动态稀疏在空间上具有聚集性,呈现出三种不同的 pattern;
4. 解决方案
- MInference、decoding 和多轮推理
- 实现细节,包括 GPU Kernel 实现
- 评测结果,包括有效性和高效性
5. 总结和未来展望
实践痛点
- 对于短文本场景,利用动态稀疏性可能会引入 overhead,获得的加速比较低
演讲亮点
- LLMs 推理算法侧优化方法,包括量化,剪枝,模型架构优化,FFN 动态稀疏计算等方面
- 首个有效降低长文本大模型推理中预填充阶段成本并保持性能的解决方案
- 协同设计的算法和系统,能够在无需训练的情况下实现端到端加速
听众收益
- 了解算法侧优化 LLMs Inference 的思路和 Long-context LLMs inference 前沿研究动向和潜在的优化思路
关注主办方(InfoQ)


联系我们
交通指南
上海中谷小南国花园酒店
China Grain Hotel
地址:上海市杨浦区佳木斯路777号(近营口路口)

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手