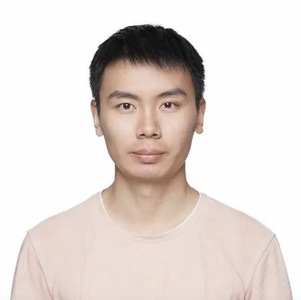
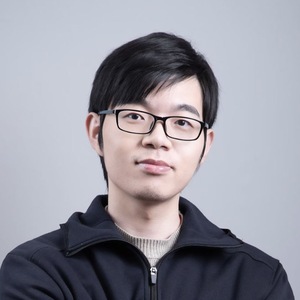
小米数据湖负责人,在小米参与流式计算 Flink,数据湖 Iceberg,Paimon,元数据湖 Gravitino 等开发工作,同时负责小米大模型数据预处理相关工作。
讲师介绍
议题介绍
地点:北京厅1
所属专题:Lakehouse 架构演进
演讲:小米数据湖架构演进:Iceberg、Paimon 与 AI 场景下的实践
本次演讲主要小米数据湖架构 Iceberg 及 Paimon 演进的历程,并介绍小米使用 Apache Gravitino 统一元数据,以及使用 Fileset 进行非表格数据管理和使用上的经验。同时将分享在实际业务中如何有效的使用 Iceberg,Paimon 和 Fileset 来实现的数据在 Data 和 AI 场景的快速流转。
演讲提纲
1. 小米数据湖架构
- 介绍小米当前数据湖架构
- 介绍当前小米数据湖的使用情况
2. 从 Iceberg 到 Paimon
- 介绍 Iceberg 使用的问题,为什么引入 Paimon
3. AI 场景下非表格数据的管理和使用
- 介绍使用 Fileset 来管理非表格数据的应用实践
4. 统一元数据
- 为什么要做统一元数据
- 介绍使用 Gravitino 来统一元数据的落地实践
5. 实际业务案例
- 以大模型数据预处理业务为例,介绍如何使用数据湖高效的完成 Data 到 AI 的数据流转
6. 未来规划
- 统一的云原生湖仓架构
- 统一元数据
您认为,这样的技术在实践过程中有哪些痛点?
- 如何高效的实现 Data 到 AI 场景的数据流转
- 表和文件如何选择,AI 场景下是否可以使用数据湖
演讲亮点
- Iceberg、Paimon 在小米最新的落地实践
- 介绍非表格和元数据在小米的实践及业务价值
听众收益
- 了解统一元数据在小米的实践案例
- AI 场景下实际的业务价值
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手