大数据架构经过多年的演进,传统数据仓库和数据湖的局限性日益凸显。在此背景下,湖仓... 展开 >
Lakehouse 架构演进
会议室:北京厅1出品人:伍翀
- Topic 1
罗宇侠
阿里云 高级开发工程师 - Topic 2
王云霏
StarRocks 研发工程师 - Topic 3
史少锋
Datastrato VP of engineering - Topic 4
闵文俊
字节跳动 研发工程师 - Topic 5
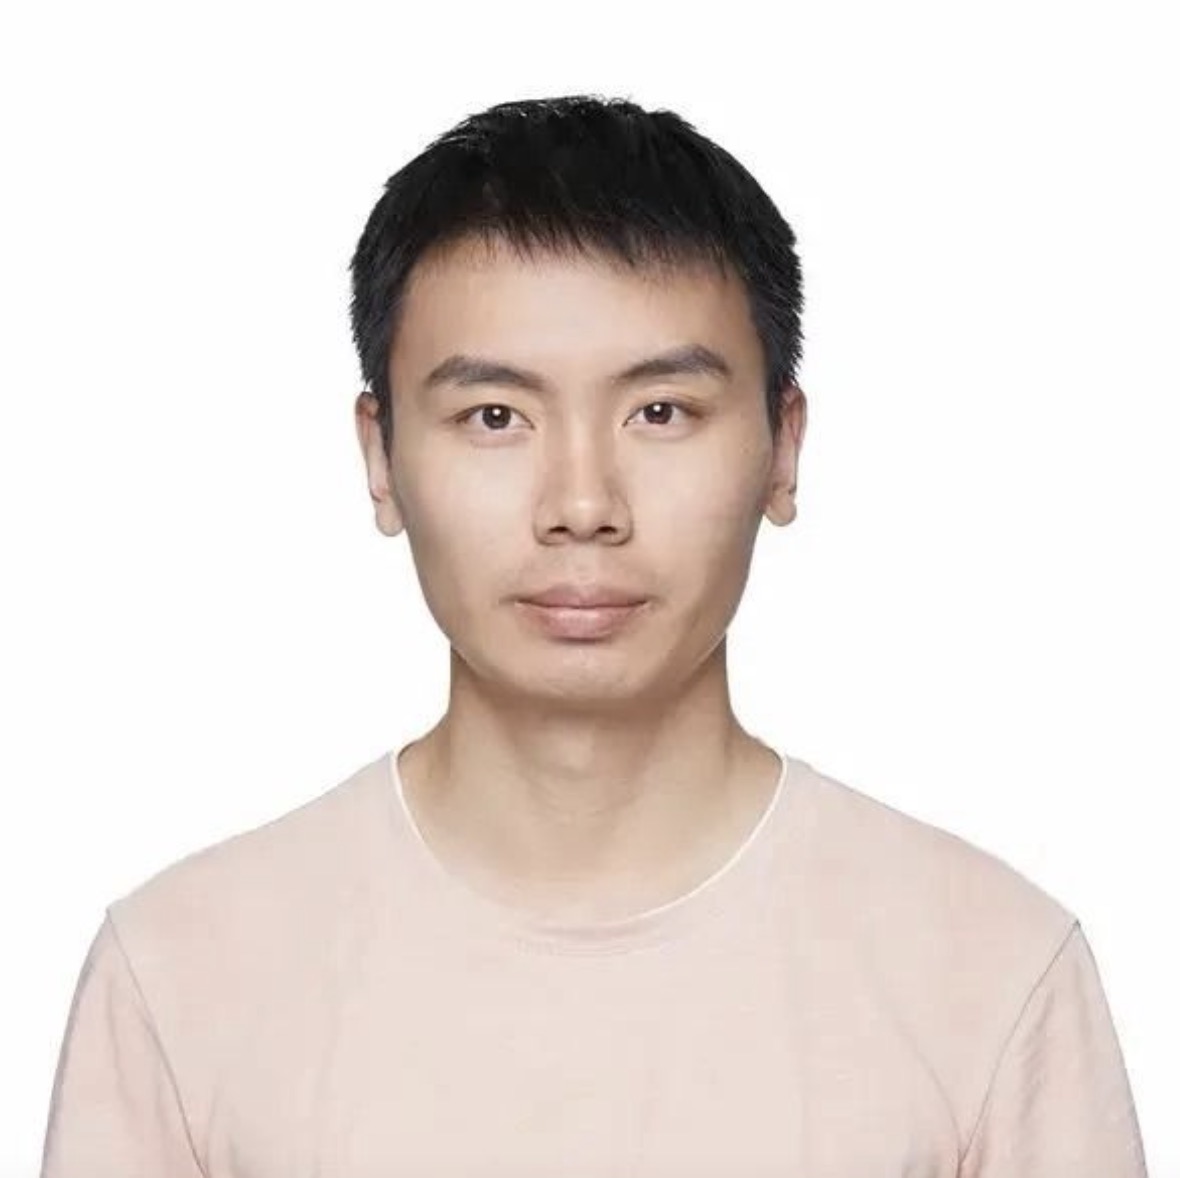
李培殿
小米 数据湖负责人
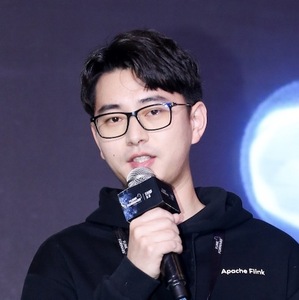
专题出品人:伍翀
阿里云智能 Flink SQL 负责人
2015年加入阿里巴巴,有 10 年的流计算领域技术经历。早期 Flink SQL 创始成员,并带领 Flink SQL 支撑多届阿里巴巴双 11 实时大屏业务及集团大部分流计算业务。长期专注于大数据计算和存储方向,带领团队孵化了 Flink CDC、Fluss 等多个创新项目。
地点:北京厅1
专题:Lakehouse 架构演进
大数据架构经过多年的演进,传统数据仓库和数据湖的局限性日益凸显。在此背景下,湖仓一体 Lakehouse 凭借其开放性和成本效益,迅速成为当今数据平台的主流架构。然而,随着进入 Data + AI 驱动的新时代,企业对实时数据分析的需求不断增加,对半结构化和非结构化数据的处理也愈显重要,如何高效整合多种数据源,实现实时分析与智能决策,已成为业界面临的重大挑战。这一过程也促使 Lakehouse 架构正在迎来新一轮的架构演进。
本次专题将围绕 Lakehouse 的架构演进,深入探讨如下方面的问题:
- Lakehouse 架构的实时化演进,如何满足数据实时化和分析实时化需求?
- Lakehouse 架构在 GenAI 浪潮下的变革,如何处理半结构化数据、非结构化数据?
- Lakehouse 架构在统一元数据管理的演进,如何统一高效管理大数据和大模型?
通过本专题,期望参会者可以了解最新的 Lakehouse 架构演进趋势,掌握 AI 和大数据结合的新技术,学习不同行业中的实际应用和成功案例,为自身的业务发展提供新思路,为未来的技术革新做好准备。
by 罗宇侠
阿里云
高级开发工程师湖仓一体 Lakehouse 凭借其开放性和成本效益,已经成为当今数据平台的主流架构。然而在 LakeHouse 架构下,数据的时效性最多只能达到分钟级。为了满足企业对实时数据分析的需求,通常需要额外引入秒级延迟的流存储(如 Kafka)。流存储游离在 LakeHouse 架构外,带来的成本、一致性、治理等问题都面临很大的挑战。
本次演讲将探讨流存储和 LakeHouse 架构割裂的现状下用户面临的问题和挑战,以及目前业界在融合两者上的趋势。然后会介绍流存储 Fluss 如何完美地融入进 LakeHouse 架构,无缝地将 LakeHouse 架构进行实时化改造,深度解析其技术架构和原理,分析该架构相比割裂地使用流存储和 LakeHouse 架构能带来的收益。最后将分享基于 Fluss 来构建实时 LakeHouse 架构的最佳实践,希望能给听众带来一些帮助。
演讲提纲
1. 湖流割裂的现状和挑战
- LakeHouse 架构下,流存储与湖存储割裂的现状
- 流存储与湖存储割裂面临的挑战
2. 湖流融合的业界趋势
- 业界在流批融合方向上的趋势
- 业界在流批融合方向上提出的解决方案
3. Fluss 湖流一体架构和技术原理
- Fluss 湖流一体的架构设计
- Fluss 湖流一体的技术原理解析
4. 基于 Fluss 构建实时 Lakehouse
- 结合湖格式 Paimon,分析 Fluss 构建实时 Lakehouse 的收益
- Fluss 构建实时 Lakehouse 最佳实践
5. Demo 演示 & 未来规划
- Demo 展示 Fluss 湖流一体的能力
- Fluss 在湖流一体方向的未来规划
您认为,这样的技术在实践过程中有哪些痛点?
- 不可避免依然需要引入提供秒级延迟的流存储
- Fluss 同步到湖存储的 Service 依然需要管理
演讲亮点
- LakeHouse 架构在实时化方向上的演进趋势
- Fluss 作为面向实时分析设计的流存储,如何无缝融合进 LakeHouse 架构,满足数据分析的实时化需求
听众收益
- 了解当前 LakeHouse 架构在数据时效性上的痛点
- Fluss 的湖流一体架构是如何解决 LakeHouse 架构时效性上的痛点的
- 收获基于 Fluss 来构建实时 LakeHouse 架构的最佳实践
by 王云霏
StarRocks
研发工程师Lakehouse 通过融合数据湖与数据仓库的优势,能实现 “One Data, All Analytics” 的业务价值,基于 StarRocks 构建 Lakehouse,只需三步:选择开放的数据湖作为底座,例如 Iceberg 、 Paimon;StarRocks 直接分析湖上的数据,满足绝大部分场景的性能诉求;如果分析性能不满足要求,则基于数据湖创建物化视图加速。StarRocks 查询 Iceberg 的性能是 Trino 的 3-6 倍,查询Delta Lake 的性能是 Databricks Photon 的 2 倍。本次演讲将介绍典型案例,分享 StarRocks 在 Lakehouse 架构中的定位和未来规划,揭开 StarRocks 极致查询性能的面纱。
演讲提纲
1. 数据分析架构演进与挑战
- Warehouse -> Data lake -> Lakehouse
- StarRocks 快速迭代,持续创新 1.x 极速查询-> 2.x 融合统一-> 3.x 湖仓一体 Lakehouse
2. 基于 StarRocks 构建 Lakehouse
- 如何构建 Lakehouse 架构 Storage-> Catalog -> Engine
- StarRocks Lakehouse 基本架构
- StarRocks x Iceberg 构建 Lakehouse,案例小红书/携程/微信
3. StarRocks x Iceberg 性能优化
- StarRocks 最新 Performance benchmark
- Metadata Cache + 分布式 Plan
- 增量投递
- Native Parquet Reader
- Data Cache
- 物化视图
- ...
4. StarRocks Lakehouse 未来规划
您认为,这样的技术在实践过程中有哪些痛点?
- 性能对于 Lakehouse 架构至关重要,StarRocks 通过不断提升性能上限,实现 Lakehouse 极致查询性能,真正实现 “One Data, All Analytics”
演讲亮点
- 基于 StarRocks 解锁 Lakehouse 极致查询性能,以及 StarRocks 在 Lakehouse 架构中的定位与未来规划
- 着重介绍 StarRocks 如何打造极致性能
听众收益
- 了解 StarRocks 在 Lakehouse 架构上的最新进展和极致性能,为技术选型提供更多参考
- 了解 StarRocks 性能优化的底层原理
- 了解 StarRocks Lakehouse 架构的未来规划
by 史少锋
Datastrato
VP of engineeringLakehouse 架构在当下已经获得多数企业的认可,得到广泛采纳;为了满足不同场景,企业会引入多种 Lakehouse 架构(如历史数据、实时数据),以及多引擎(如处理引擎、分析引擎)等。企业在采用多 Lakehouse 后,往往面临一些挑战,如:
- 如何实现多 Lakehouse 中数据的发现和共享,让应用、引擎以统一的方式接入;
- 如何实现多 Lakehouse 的统一管理和治理,使用方式不一致导致的数据治理问题等。
对此,基于标准协议的 Rest Catalog 以及支持多引擎的统一元数据服务,可以帮助企业统一管理 Lakehouse,解决上面提到的问题,此次分享将为您带来以上方面的最佳实践。
演讲提纲
1. Lakehouse 架构背景
- 什么是 Lakehouse 架构
- Lakehouse 的核心优势:数据湖与数据仓库的结合
- Lakehouse 在企业中的典型应用场景
2. 多 Lakehouse 趋势
- 企业为何需要多 Lakehouse
- 多 Lakehouse 的典型架构模式
- 多 Lakehouse 带来的机遇与挑战
3. 多 Lakehouse 治理挑战
- 数据发现与共享难题
- 统一管理与治理困境
- 实际案例:企业面临的具体问题
4. 什么是统一元数据湖
- 统一元数据湖的定义与核心价值
- 统一元数据湖的关键特性
- 统一元数据湖与传统元数据管理的对比
5. 基于统一元数据湖的 Lakehouse 架构
- 架构设计原则
- 技术实现
- 实际应用案例
6. 未来展望
您认为,这样的技术在实践过程中有哪些痛点?
- 协议适配问题:尽管基于标准协议的 Rest Catalog 是核心优势之一,但在实际企业环境中,不同的 Lakehouse 架构可能是在不同时期、由不同供应商构建的。这些系统可能对标准协议的支持程度参差不齐,存在部分功能无法完全适配 Rest Catalog 的情况。
- 企业中可能同时存在多种处理引擎和分析引擎,这些引擎对元数据的理解和使用方式存在差异。统一元数据湖服务要支持多引擎,就需要针对每种引擎的特点进行定制化开发。
演讲亮点
- 介绍基于标准协议的 Rest Catalog 及其在多 Lakehouse 环境中的技术优势,展示统一元数据湖
- 如何实现跨平台、跨引擎的数据管理。
- 分享如何通过统一元数据湖解决多 Lakehouse 环境中的数据发现、共享和治理难题,提供可落地的解决方案和实际案例。
- 探讨统一元数据湖在数据架构中的未来发展方向,为企业提供战略性的技术选型建议。
听众收益
- 掌握多 Lakehouse 治理的关键挑战与解决方案
- 学习统一元数据湖的核心技术与实践
- 获取可落地的数据治理最佳实践
by 闵文俊
字节跳动
研发工程师本次演讲将探讨传统实时和离线开发中遇到的问题与挑战,并介绍 Paimon 作为数据湖的新星,在流式湖仓场景中的核心价值与能力。同时,我们将分享如何在实际业务场景中有效应用 Paimon,以及如何解决其在大规模场景中的稳定性和性能问题,希望能给同行带来一些参考和借鉴。
演讲提纲
1. 背景 & 挑战
- 传统实时和离线链路开发所面临的问题
- 引入流式湖仓架构
2. Paimon 湖格式架构
- Paimon 的发展历程
- Paimon 整体架构与核心功能
- Paimon 1.0 社区新进展
3. 业务实践
- 广告归因场景中的应用
- 大规模维表场景的应用
4. 未来规划
- 基于 Paimon 流式湖仓架构的进一步演进
- Paimon 稳定性和性能进一步的优化
您认为,这样的技术在实践过程中有哪些痛点?
- 数据湖体系下对湖表管理的新的诉求
- 在大规模流量场景如何满足稳定性和时效的要求
演讲亮点
- Paimon 在流式湖仓场景的演进
- Paimon 在实际生产实践中遇到的问题和优化手段
听众收益
- 了解 Paimon 的核心功能和社区最新动态
- 了解 Paimon 在大规模场景中的生产实践
- 了解 Paimon 在落地过程中遇到的问题和解决方案
by 李培殿
小米
数据湖负责人本次演讲主要小米数据湖架构 Iceberg 及 Paimon 演进的历程,并介绍小米使用 Apache Gravitino 统一元数据,以及使用 Fileset 进行非表格数据管理和使用上的经验。同时将分享在实际业务中如何有效的使用 Iceberg,Paimon 和 Fileset 来实现的数据在 Data 和 AI 场景的快速流转。
演讲提纲
1. 小米数据湖架构
- 介绍小米当前数据湖架构
- 介绍当前小米数据湖的使用情况
2. 从 Iceberg 到 Paimon
- 介绍 Iceberg 使用的问题,为什么引入 Paimon
3. AI 场景下非表格数据的管理和使用
- 介绍使用 Fileset 来管理非表格数据的应用实践
4. 统一元数据
- 为什么要做统一元数据
- 介绍使用 Gravitino 来统一元数据的落地实践
5. 实际业务案例
- 以大模型数据预处理业务为例,介绍如何使用数据湖高效的完成 Data 到 AI 的数据流转
6. 未来规划
- 统一的云原生湖仓架构
- 统一元数据
您认为,这样的技术在实践过程中有哪些痛点?
- 如何高效的实现 Data 到 AI 场景的数据流转
- 表和文件如何选择,AI 场景下是否可以使用数据湖
演讲亮点
- Iceberg、Paimon 在小米最新的落地实践
- 介绍非表格和元数据在小米的实践及业务价值
听众收益
- 了解统一元数据在小米的实践案例
- AI 场景下实际的业务价值
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手