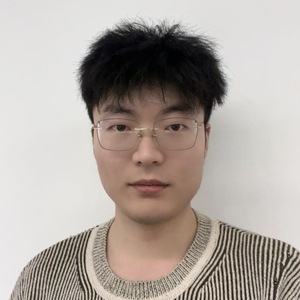
2012 年毕业后入职百度,2015 年跟随作业帮分拆出来至今,见证了作业帮初创至今十年的发展历程,经历了 OCR 和检索系统从 0 到 1 并持续迭代优化的全过程,主要参与工程架构方向的工作,重点对系统的性能和稳定性负责。
讲师介绍
议题介绍
地点:北京厅1
所属专题:更智能的企业 AI 搜索实践
演讲:作业帮检索系统重构:Havenask 实践案例分享
作业帮的 OCR 与检索系统自 2015 年上线以来,一直为作业帮各项业务提供高效算法能力支持。然而,随着流量、数据规模和业务形态的不断增长,原有召回引擎虽在时延和吞吐上有优势,但在容量及功能上的瓶颈逐渐显现。
从 2020 年开始,我们探索了多种优化方案,包括在原有系统上持续迭代、尝试自研替换,以及最终使用开源替换。新系统上线后,业务实现了 40% 以上的成本节省,系统能力天花板大幅提升。这一过程不仅推动了 Havenask 项目的开源,也为相关技术选型提供了新方案,通过大规模系统落地验证了其可用性和可靠性。
本次演讲我将分享作业帮 OCR 与检索系统在面对业务增长和技术瓶颈时的优化历程,包括选择和推动开源项目 Havenask 的落地,以及通过技术优化实现性能提升的实践经验,为 AI 时代下的检索系统选型提供参考。
演讲提纲
1. 结果很重要:十年系统能力重塑,拥抱 AI 时代
- 大规模检索系统成本节省40+%
- 低成本支撑数据爆发增长
- 业务多元化,高效支持 AI 功能需求
2. 面对的问题
- 业务背景
- 传统题目检索场景
- 系统架构和约束条件
- 提炼核心矛盾
- 特定查询范式下的时延要求
- 单位吞吐支撑的索引容量
- 高性能向量检索
3. 思路和决策
- 现有基础上迭代优化
- 彻底重构:自研 vs 开源
- 用户视角的 Havenask 开源历程
4. 实践过程
- 难点:性能效果双红线
- Bad Case:压测、Query Cache
- Good Case:索引排序、numa 绑定、大页内存、粗排优化、排序模型适配、部署方案适配、Subquery 生成和执行优化
5. 总结
- 业务层面
- 新版系统效果更好,成本更低,能力更强 - 有效支撑业务快速探索的需求
- 技术层面
- 此次实践催化了 Havenask 项目的开源,为技术选型提供了一种新的方案
- 通过大规模系统落地验证了其可用性可靠性,可作为参考案例
您认为,这样的技术在实践过程中有哪些痛点?
- 风险很高:一切都是不确定的,推动一个商业项目的核心引擎开源本身就很不确定;即便开源,在一个核心业务核心系统里启用未经验证过的项目,也是一个非常激进的想法。成,很难说功成名就,但败大概率职业生涯会大受影响。这个案例的前半部分我觉得无法复制, Havenask 的开源存在一定偶然性。我们再实施过程中也是边走边看,不断准备 PLAN B 甚至 C。直到我们落地改造前,没有哪一方是能掌控事情的发展的。
- 替换难度:即便 Havenask 开源了,也不是说开箱可用,用了就会出现奇效,动一个核心系统底层本身就有难度,再和一个新项目磨合问题就会更多,在实施过程中我们也遇到了因判断错误引发的问题,一度影响士气,甚至到了质疑自己不求有收益只求能平安上线的地步。问题解决都是一步一步磨过来的,没有多么的高大上和云淡风轻,我觉得比较难熬,但这个项目落地以后,证明这条路是可行的,搜广推还有一套新的技术方案可选,当前的不足后续的人一定会有更好的办法解决。
演讲亮点
- 拍搜检索属于一个垂类检索,与通用网页搜索行为存在较大差异,也很少对外介绍,通过这个案例可以了解一些业务场景上和实践上的区别
- 这个案例也是 Havenask 开源后首个大规模的系统落地实践,相当于是一个参考案例
听众收益
- 一定程度了解作业帮 OCR & 检索系统的工作场景
- 了解此次系统升级的发展过程,我们是如何对比判断以及决策的
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手