随着生成式大模型技术的飞速发展,AI搜索在技术层面和应用领域不断突破,为各行业带... 展开 >
更智能的企业 AI 搜索实践
会议室:北京厅1出品人:郭瑞杰
- Topic 1
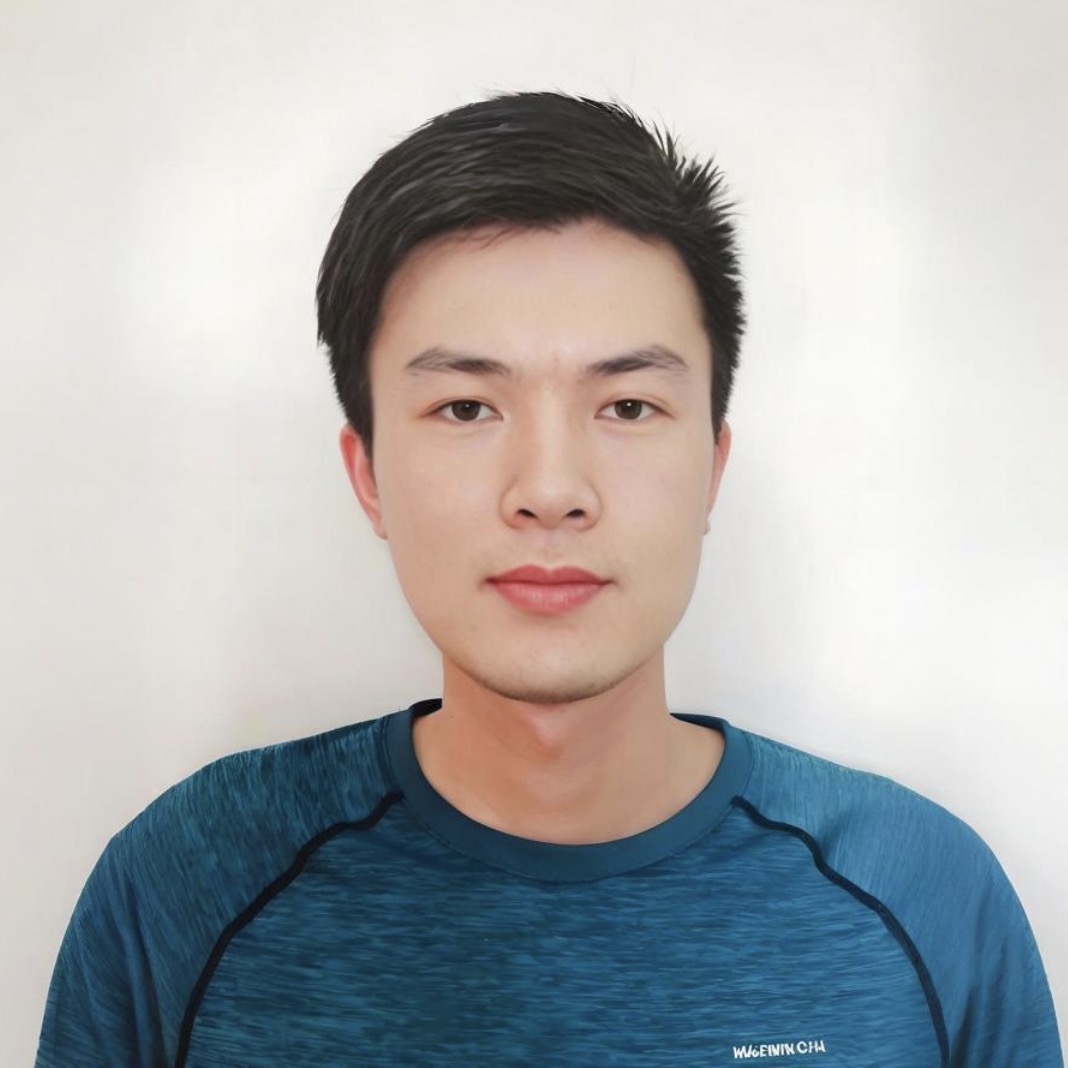
徐光伟
阿里云 高级算法工程师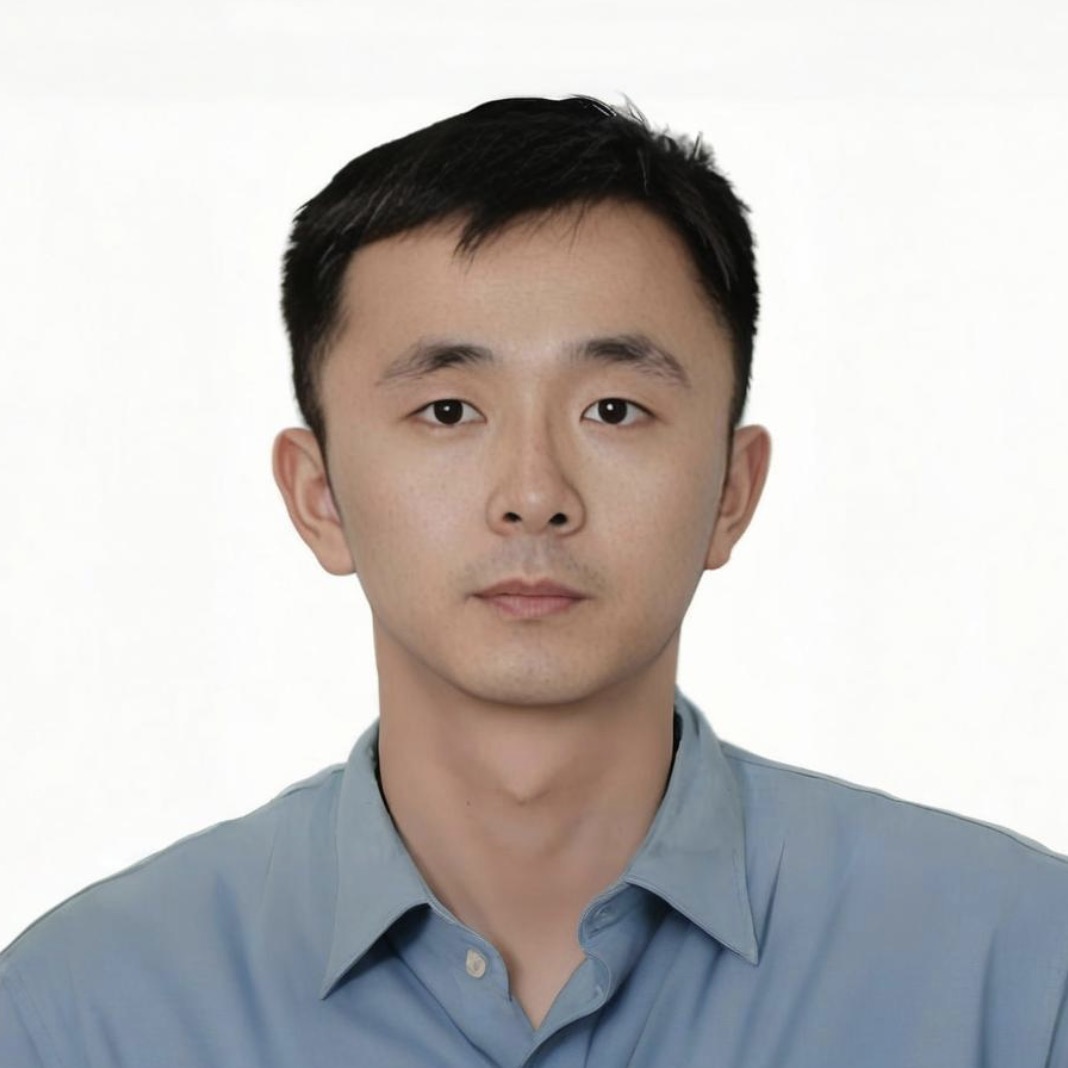
姚舰航
阿里云 高级算法工程师 - Topic 2
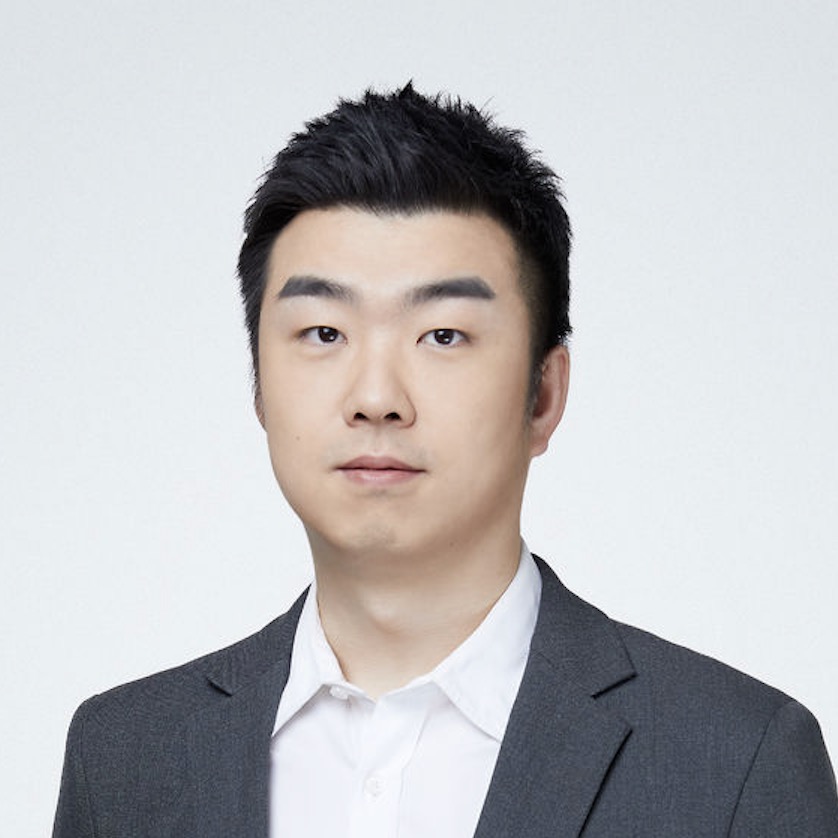
高原
句子互动 联合创始人&CTO - Topic 3
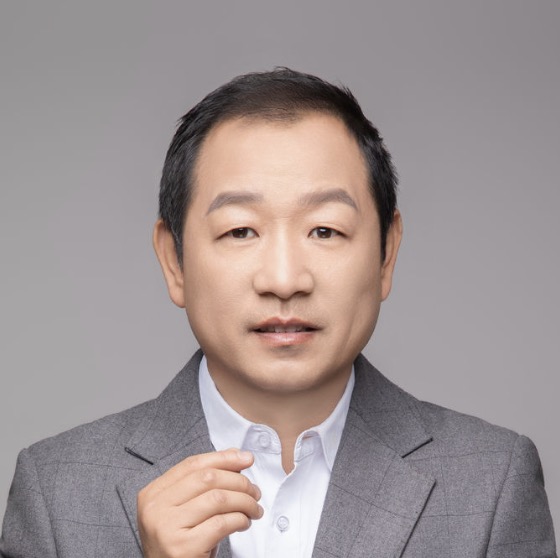
刘晓国
Elastic 中国社区首席布道师 - Topic 4
王传阳
枫清科技 合伙人、智能平台事业部总经理 - Topic 5
戚仕鹏
蚂蚁集团 技术专家
吕松霖
蚂蚁集团 开发工程师 - Topic 6
程童
作业帮 智能技术实验室工程架构团队负责人 - Topic 7
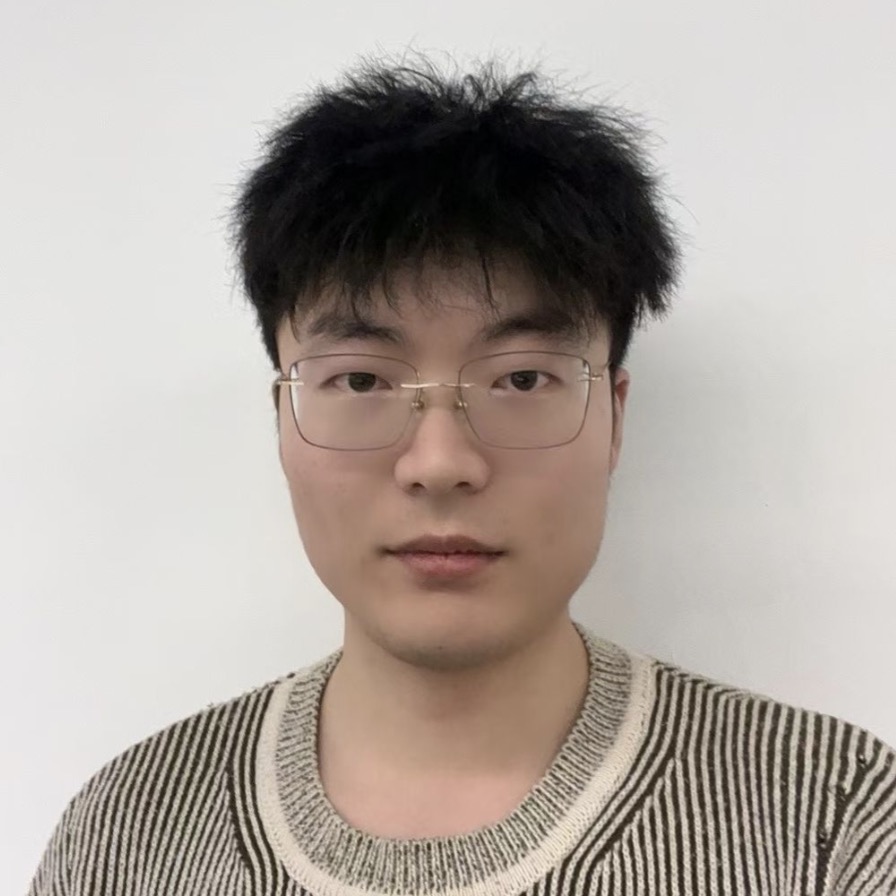
董振兴
明略科技 技术专家
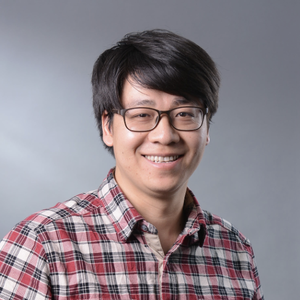
专题出品人:郭瑞杰
阿里云 AI 搜索负责人
郭瑞杰,阿里云 AI 搜索负责人,阿里巴巴开源搜索引擎 Havenask 项目负责人,中科院计算所博士,阿里巴巴搜推广工程体系 AI . OS 早期开拓者,曾负责阿里巴巴搜索引擎HA3 前后几代架构的设计和研发工作,以及负责阿里巴巴集团搜索中台业务。目前专注企业AI搜索、搜索专属大模型,以及RAG 应用平台建设,从零到一创建了阿里云AI搜索产品体系,包括 OpenSearch LLM智能问答、企业 AI 搜索开放平台、阿里云 ES 企业版、智能推荐和图计算等云产品,覆盖多轮对话式搜索、行业语义搜索、智能日志检索分析、大规模向量检索、图检索等场景。
地点:北京厅1
专题:更智能的企业 AI 搜索实践
随着生成式大模型技术的飞速发展,AI搜索在技术层面和应用领域不断突破,为各行业带来深远变革。AI 搜索包含语义搜索和检索增强生成 ( Retrieval - Augmented Generation , RAG )两个方向。语义搜索在大模型的驱动下正在全面重构,用户查询的意图理解、向量检索的相似度匹配、排序算法等能力取得显著提升,搜索结果更加精准。而 RAG 通过将外部知识库的检索与生成模型相结合,显著提升了生成内容的时效性、准确性,显著降低了幻觉率。在应用领域,AI 搜索的创新应用正在重新定义各行业的业务模式和用户体验。
本专题旨在共同探讨企业AI搜索的最新进展、应用案例及未来发展趋势,将重点讨论如下几个方面:
-
基于大模型全面增强的检索机制:语义理解、向量检索技术、排序技术等最新进展和优化实践;
-
深层次复杂问题的解答能力: 如何应用和优化 GraphRAG、 Agentic RAG 等技术来提升复杂问题的解答能力;
-
多模态:融合文本、图像、音频等多种数据形式的跨模态 RAG 的最新进展和应用创新;
-
AI 搜索在各行业的实践案例,例如电商智能搜索和导购、企业智能客服和虚拟助理、金融决策优化、在线教育虚拟培训师等。
-
AI 搜索的未来发展趋势、技术挑战和潜在的应用创新。
通过本专题,期望听众能了解企业 AI 搜索的最新进展,拓宽技术视野,能从实践案例中受到启发,在自己的业务场景中实现更智能的 AI 搜索。
随着人工智能和深度学习的迅猛发展,大模型(Large Language Model)在自然语言处理、计算机视觉等领域取得了突破性的成果。这些进步促使搜索技术迎来了新的变革。传统搜索主要依赖于关键词匹配和预定义的规则,强调精确的相关性匹配。然而,AI 大模型的引入,使得搜索技术从关键词检索转向了语义理解,从单一模态走向了多模态融合,从确定性检索演变为基于相似度的智能检索。
本次演讲将聚焦于 AI 搜索大模型的关键技术应用,涵盖文本向量化、降维、重排序、NL2Search(自然语言到搜索)、文档解析与切片、问答大模型评测与微调、 Agentic RAG(检索增强生成)及客户专属大模型的最新进展。我们将结合实际业务场景和案例(如智能问答系统、文档搜索、人工智能助手等),深入阐述这些技术如何提升搜索的质量和效率,以及在实践中如何克服各种技术挑战。
演讲提纲
- AI 大模型在搜索领域的背景与趋势
- 文本向量化与降维
- 搜索结果的重排序模型
- NL2Search:从自然语言到搜索
- 基于大模型的语义切片
- 大模型问答质量评测与微调
- Agentic RAG 实践
- 客户专属大模型训练探索
您认为,这样的技术在实践过程中有哪些痛点?
- 文本向量化与降维:向量化可能导致高维数据难以处理,而降维可能导致信息丢失,影响搜索效果
- 重排序算法:需要高效的算法以确保实时性,尤其是在大规模数据集上,但计算复杂度可能成为瓶颈
- NL2Search(自然语言到搜索):构建高质量的自然语言处理模型需要大量标注数据,且模型的准确性对于搜索体验非常关键
- 基于大模型的语义切片:切片语义完整度直接影响搜索结果的相关性
- 大模型问答质量评测与微调:大模型问答缺乏全面且高精度的质量评测体系,大模型在 AI 搜索场景中仍存在幻觉、回答不完整、回答冗余等问题
- Agentic RAG 实践:单轮 RAG 难以解答复杂问题(如多跳问题、聚合问题等)
- 客户专属大模型训练:由于大模型缺乏客户专有域知识,对客户场景特有问题的理解不足,回答不专业
演讲亮点
- 实际业务场景结合:通过智能问答系统和文档搜索案例,展示AI搜索技术如何在现实中应用,增强观众理解
- 前沿技术进展:介绍Agentic RAG的最新进展,帮助听众了解技术的未来发展趋势
- 技术问题与解决方案:不仅指出各项技术的实际痛点,还提供了相应的解决策略,使内容更加实用
- 综合性讨论:涵盖从文本向量化到问答大模型的多个技术层面,提供全方位的知识视角
听众收益
- 深入了解 AI 搜索大模型的核心技术和应用场景,掌握最新的行业动态和技术趋势
- 学习如何将大模型技术应用于实际业务中,解决传统搜索难以应对的问题,提升系统的智能化水平
- 开拓新的思路和方法,了解如何结合传统技术和大数据处理,实现高效的搜索解决方案
- 了解当前领域的技术挑战,为未来在 AI 搜索领域的研究和实践提供指引
by 高原
句子互动
联合创始人&CTO在大模型时代,Retrieval-Augmented Generation(RAG)已经成为构建 LLM 应用的核心范式之一。然而,传统 RAG 在面对复杂任务时往往力不从心,难以实现真正的“智能问答”体验。本次演讲将聚焦 RAG 的下一阶段演化——Agentic RAG,探讨其架构、能力边界与未来潜力。本次分享将展示如何通过类似人类的认知过程优化检索路径、工具组合与知识建模,从而打造更高效、可解释、更具思考能力的 AI 系统。
演讲提纲
1. Agentic RAG 的基本范式
- 程序化 RAG 与人性化 RAG 的区别
- 不同场景下的适配策略与设计考量
2. Agentic RAG 的系统架构
- 单 Agent 与多 Agent 协同架构
- Agent 可调用的工具能力
- 当前架构的限制与发展瓶颈
3. Agentic RAG 的进化方向
- 索引期间的智能优化
- 检索路径的自我决策与记忆系统
- 检索反馈索引的自迭代机制
4. Agentic RAG 落地踩坑的案例分享
5. 总结与展望
您认为,这样的技术在实践过程中有哪些痛点?
- 检索路径不稳定:Agent 在调用工具时缺乏策略记忆,容易重复冗余检索,导致延迟上升
- 缺乏长期记忆:Agent 无法利用历史经验优化当前任务,常“从零开始”
- 工具调用碎片化:Agent 工具能力虽然强大,但缺乏统一规划,难以形成高效组合策略
- 开发与调试困难:多 Agent 协作行为难以复现和调试,性能评估困难
- 成本控制困难:高频检索 + 多轮推理容易产生不可控的 Token 成本
演讲亮点
- 方法论视角:结合“人类解决问题”的认知路径来设计 Agent 行为策略
- 未来导向:提出索引期间智能化、Agent 自我进化等创新视角
- 适合多角色:既适合工程实现,也适合产品设计与系统规划人员理解
听众收益
- 理解 Agentic RAG 的实现原理和技术架构
- 在实现落地 Agentic RAG 的过程中可以得到思路上的启发
by 刘晓国
Elastic
中国社区首席布道师传统的词汇搜索不能满足当今时代的需求,特别是在这个智能的时代。当代企业针对搜索提出语义搜索,也就是根据文字的语义来进行搜索,而不是简单的词汇匹配。另外,我们也需要针对其它的数据类型,比如图片,语音及视频来进行搜索。Elasticsearch 自 8.0 开始提供向量搜索(密集向量,稀疏向量)。它可以完美地解决文字语义搜索及多媒体数据的搜索。此外,向量搜索也并非完美,特别是针对文字搜索。我们可以使用混合搜索(词汇搜索,向量搜索)进行多路召回并对最终结果进行排名,这种方法可以提高搜索的精度及召回率。在人工智能发展的今天,结合大模型,使用 GenAI 可以让我们得到唯一的搜索答案,而不是传统的搜索引擎提供的多页面的搜索结果。由于企业数据或私有数据在每时每刻都在生成。大模型在缺乏上下文的情况下使用大模型来进行推理,在很多的时候会产生幻觉,因为这些知识不存在于大模型中。结合 Elasticsearch 的向量搜索技术针对企业数据或私有数据进行搜索,把搜索结果作为上下文提供给大模型,从而消除幻觉。这种技术也被称作为 RAG(检索增强生成)。本次演讲将详细介绍 Elasticsearch 的向量搜索技术及如何使用它进行 RAG 的应用开发。
演讲提纲
1. 智能时代的搜索需求
- 对语义搜索的需求,而不是简单的词汇匹配
- 对多媒体数据的搜索,比如图片,声音及视频
- 非结构化数据的搜索
- 向量搜索带来的新的解决方案
2. Elasticsearch 向量搜索
- 向量搜索原理
- 向量搜索种类(密集向量,稀疏向量)
- 混合搜索介绍(多路召回,综合评分)
3. RAG 实现
- 如何使得大模型变得更聪明
- RAG 的实现方法
4. Elasticsearch 在向量搜索上的最新进展
- 硬件加速
- 并行化
- 标量量化
- 搜索效率
- 重新排名
- Semantic text 字段
- 推理 API
- AI 生态
5. 使用 Elasticsearch 在企业搜索中的案例分享
- 高级 RAG 案例分享
您认为,这样的技术在实践过程中有哪些痛点?
向量搜索需要大量的内存及计算能力,如果针对超大规模的数据进行向量搜索,存在成本上考虑。有时搜索的结果缺乏可解释性。如何结合传统的词汇搜索来实现更加精准的搜索的结果。如何使用大语言模型/人工智能来提高最终的搜索结果排名。在使用 GenAI 时,如何针对私有或者企业数据来规避幻觉。
演讲亮点
- 使用 Elasticsearch 来针对企业进行大规模的商用、规避搜索幻觉
- 结合大模型,使用混合搜索来得到更加精准的搜索结果
听众收益
- 了解如何运行 Elasticsearch 来进行语义搜索
- 了解如何结合大模型,针对企业数据进行 GenAI 搜索
by 王传阳
枫清科技
合伙人、智能平台事业部总经理随着大语言模型(LLM)与检索增强生成(RAG)技术的深度整合,知识库检索与问答系统已在智能客服、医疗辅助诊断、金融智能投研等场景实现规模化落地。然而,在企业级复杂知识交互场景中,传统 RAG 技术在诸如知识片断的语义关联与跨模态融合推理等方面遇到瓶颈。当检索到的文字内容散落于不同的段落、文档、以及不同的数据源时,如何能高效准确地检索并关联所有相关片段汇总准确生成最终答案?针对此类挑战,本演讲将深入剖析基于跨模态知识联邦与统一语义推理的 RAG 架构,并结合生产实践分享实际应用成效,以及后续技术演进方向。
演讲提纲
1. 传统 RAG 技术难以应对知识的碎片化与跨模态挑战
- 知识碎片化
- 知识跨模态
2. 基于跨模态知识联邦与统一语义推理的 RAG 架构
- 架构概览
- 核心模块与流程设计
- 与已有架构的横向对比
3. 生产实践成效
- 真实场景介绍
- 实际应用效果分享
4. 未来演进方向
您认为,这样的技术在实践过程中有哪些痛点?
- 技术复杂性高:跨模态知识联邦和统一语义推理本身都是复杂的技术挑战,将它们整合到 RAG 架构中,会增加技术实现的难度和复杂度
- 跨模态数据处理难度大:不同模态的数据(文字、图表、图像、视频等)在数据结构、语义表示等方面存在差异,如何有效地进行跨模态数据融合和处理是一个挑战
- 语义关联和推理的准确性:如何准确地进行知识碎片之间的语义关联和统一语义推理,保证检索和问答的准确性,仍然是一个需要持续优化和改进的问题
- 系统性能和效率:在处理复杂场景和大规模知识库时,如何保证 RAG 系统的性能和效率,满足实际应用的需求,是一个重要的工程挑战
演讲亮点
- 面向复杂场景应用:聚焦企业级复杂知识交互,解决实际业务痛点
- 跨模态知识联邦:突破传统 RAG 模态限制,实现多模态数据融合
- 统一语义推理:提升知识关联和问答准确性,更智能
听众收益
- 理解 RAG 技术演进:把握复杂场景下 RAG 技术的最新发展方向
- 掌握新架构思路:学习跨模态知识联邦与统一语义推理的 RAG 架构,解决知识碎片化和跨模态难题
高性能图数据库 TuGraph 由蚂蚁集团和清华大学共同研发,是蚂蚁集团蚂蚁核心开源项目,历经蚂蚁 50 万核图计算集群和 300+ 实际业务场景锤炼,在国际图数据库基准测试中多次获得性能第一。在AI时代的浪潮下,为了进一步加强图数据库的数据分析能力,TuGraph 技术团队不断探索 TuGraph 与 AI 相结合的可能性,在 Text2GQL、GraphRAG、MAS 等多方面进行了相关的探索。本次演讲我主要分享 TuGraph 团队在 Text2GQL、GraphRAG、MAS 等多方面的探索成果,并展望图数据库与 AI 的未来结合点。
演讲提纲
1. RAG 技术的现状与趋势
- 大模型的幻觉问题
- RAG 增强 AI 检索
- RAG 技术现状
2. GraphRAG 增强 AI 搜索
- GraphRAG 的技术优势
- 向量驱动的 GraphRAG 检索
- NLU+Text2GQL 驱动的 GraphRAG
3. 从自然语言到 GraphRAG
- Text2GQL 模型微调与评测
- Text2GQL 语料生成
4. 总结与展望
- GraphRAG 实践分析
- RAG 技术赋能 MAS
您认为,这样的技术在实践过程中有哪些痛点?
- 模型微调的复杂性
- 用户需求多样性和动态变化
演讲亮点
- Graph+AI 的深度融合
- 高性能图数据库的实际应用案例
听众收益
- 了解图技术与 AI 结合的最新进展
- 获取实际应用的技术方案
by 程童
作业帮
智能技术实验室工程架构团队负责人作业帮的 OCR 与检索系统自 2015 年上线以来,一直为作业帮各项业务提供高效算法能力支持。然而,随着流量、数据规模和业务形态的不断增长,原有召回引擎虽在时延和吞吐上有优势,但在容量及功能上的瓶颈逐渐显现。
从 2020 年开始,我们探索了多种优化方案,包括在原有系统上持续迭代、尝试自研替换,以及最终使用开源替换。新系统上线后,业务实现了 40% 以上的成本节省,系统能力天花板大幅提升。这一过程不仅推动了 Havenask 项目的开源,也为相关技术选型提供了新方案,通过大规模系统落地验证了其可用性和可靠性。
本次演讲我将分享作业帮 OCR 与检索系统在面对业务增长和技术瓶颈时的优化历程,包括选择和推动开源项目 Havenask 的落地,以及通过技术优化实现性能提升的实践经验,为 AI 时代下的检索系统选型提供参考。
演讲提纲
1. 结果很重要:十年系统能力重塑,拥抱 AI 时代
- 大规模检索系统成本节省40+%
- 低成本支撑数据爆发增长
- 业务多元化,高效支持 AI 功能需求
2. 面对的问题
- 业务背景
- 传统题目检索场景
- 系统架构和约束条件
- 提炼核心矛盾
- 特定查询范式下的时延要求
- 单位吞吐支撑的索引容量
- 高性能向量检索
3. 思路和决策
- 现有基础上迭代优化
- 彻底重构:自研 vs 开源
- 用户视角的 Havenask 开源历程
4. 实践过程
- 难点:性能效果双红线
- Bad Case:压测、Query Cache
- Good Case:索引排序、numa 绑定、大页内存、粗排优化、排序模型适配、部署方案适配、Subquery 生成和执行优化
5. 总结
- 业务层面
- 新版系统效果更好,成本更低,能力更强 - 有效支撑业务快速探索的需求
- 技术层面
- 此次实践催化了 Havenask 项目的开源,为技术选型提供了一种新的方案
- 通过大规模系统落地验证了其可用性可靠性,可作为参考案例
您认为,这样的技术在实践过程中有哪些痛点?
- 风险很高:一切都是不确定的,推动一个商业项目的核心引擎开源本身就很不确定;即便开源,在一个核心业务核心系统里启用未经验证过的项目,也是一个非常激进的想法。成,很难说功成名就,但败大概率职业生涯会大受影响。这个案例的前半部分我觉得无法复制, Havenask 的开源存在一定偶然性。我们再实施过程中也是边走边看,不断准备 PLAN B 甚至 C。直到我们落地改造前,没有哪一方是能掌控事情的发展的。
- 替换难度:即便 Havenask 开源了,也不是说开箱可用,用了就会出现奇效,动一个核心系统底层本身就有难度,再和一个新项目磨合问题就会更多,在实施过程中我们也遇到了因判断错误引发的问题,一度影响士气,甚至到了质疑自己不求有收益只求能平安上线的地步。问题解决都是一步一步磨过来的,没有多么的高大上和云淡风轻,我觉得比较难熬,但这个项目落地以后,证明这条路是可行的,搜广推还有一套新的技术方案可选,当前的不足后续的人一定会有更好的办法解决。
演讲亮点
- 拍搜检索属于一个垂类检索,与通用网页搜索行为存在较大差异,也很少对外介绍,通过这个案例可以了解一些业务场景上和实践上的区别
- 这个案例也是 Havenask 开源后首个大规模的系统落地实践,相当于是一个参考案例
听众收益
- 一定程度了解作业帮 OCR & 检索系统的工作场景
- 了解此次系统升级的发展过程,我们是如何对比判断以及决策的
by 董振兴
明略科技
技术专家随着生成式大模型技术的飞速发展,企业 AI 搜索需求呈现爆发式增长。纯文本 RAG 虽然在处理文本数据方面表现出色,但难以应对企业内部复杂多样的数据类型。多模态 RAG 技术通过整合文本、图像和音频等多种数据形式,实现了更全面的信息检索和利用,显著提升了生成内容的准确性和时效性,并有效降低了大模型产生幻觉的风险。
本次演讲将聚焦于 RAG 在多模态数据场景下的实践应用和技术挑战。具体将探讨多模态数据的向量化策略,深入剖析检索增强和生成增强的关键技术与解决方案,包括如何有效进行跨模态数据处理、检索和问答,以在海量异构数据中精准定位信息。此外,还将探讨借助 Agentic RAG 等前沿技术,通过大模型的推理和反馈机制,处理复杂搜索查询,提升检索的智能化和精准度。通过对这些核心技术的深入解析,旨在为听众提供构建高效、智能的多模态 RAG 增强系统的全面思路。
演讲提纲
1. 智能时代对多模态搜索的需求
- 当前 AI 搜索的发展趋势,以及对更智能信息检索的需求
- 企业内部数据的多样性和复杂性对传统文本 RAG 的挑战
2. 多模态数据的解析与向量化
- 企业中常见的多模态数据类型(文本、图像、音频等)及其特点
- 针对不同模态数据的向量化策略
3. 多模态信息的检索增强
- 多模态数据检索策略
- 如何将检索到的多模态信息有效地融入生成过程,提升生成内容的质量
- 多模态场景下基于 Agentic RAG 的复杂查询处理与智能检索
4. 总结和展望
您认为,这样的技术在实践过程中有哪些痛点?
- 多模态数据处理的复杂性与难度。不同模态的数据拥有各自特有的存储格式和编码方式,需要进行复杂的预处理、转换、解析才能统一处理
- 多模态数据的对齐问题。例如一段文本描述了一张图片的内容,如何将这两者在语义上对齐是一个挑战
- Agentic RAG 的鲁棒性与可解释性差,且调试困难。如何保证 Agent 在各种复杂的场景下都能稳定运行,并且其决策过程具有一定的可解释性,是实际应用中需要考虑的问题
演讲亮点
- 聚焦多模态数据:深入探讨如何处理和利用文本、图像、音频等多种数据形式进行 RAG
- 强调实践性:结合实际开发和调优经验,分享关键技术和解决方案
- 提供全面的思路:从数据处理、检索增强到生成增强,提供构建高效智能多模态 RAG 系统的完整框架
听众收益
- 深入了解多模态 RAG 系统的核心技术和应用场景
- 学习如何针对不同模态的数据进行向量化和检索
- 掌握多模态 RAG 系统的开发流程和关键优化策略
- 了解当前领域的技术挑战和未来发展方向
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手