毕业于华中科技大学计算机专业硕士,专注于分布式存储领域,拥有超过 15 年的大规模公有云存储架构开发和 AI 存储架构设计,参与主导了 YRCloudFile 高性能分布式文件存储系统从 0 到 1 的设计研发及产品落地工作,并在 AI 场景应用落地方面具备一定的实战经验。在 AI 及高算力场景项目交付上,有着丰富的整体架构设计和性能优化经验。中国智能计算产业联盟专委会技术专家组,上海 TGO 鲲鹏会成员。
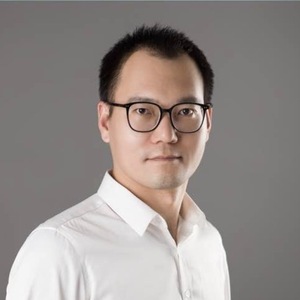
专题演讲嘉宾:张文涛
焱融科技CTO
by 张文涛
焱融科技
CTO在深度学习领域中,数据是基⽯,算⼒是引擎。训练⼀个模型,需要⼤量的数据和算⼒ ,并且需要反复迭代和验证才能得到想要的模型。 为了提升训练效率,缩短训练时间,所有组件之间都需要快速响应,这其中就包括了计算和存储之间的交互。对于⼀个 AI 系统⽽⾔,模型的能⼒随着模型尺⼨和训练数据的增加⽽显著提升,但随着数据集和模型规模不断增加,训练任务载⼊训练数据所消耗的时间越来越⻓,进⽽影响了训练效率,缓慢的 IO 严重拖累 GPU 的强⼤算⼒。
本次演讲,我将介绍焱融的全闪⽂件存储的整体架构和技术细节,并逐⼀介绍 YRCloudFile 是如何解决 AI 训练过程中遇到的海量⼩⽂件访问慢、 带宽峰值、 内存访问瓶颈和多任务并发访问性能⼲扰等问题。
演讲提纲
1. AI 训练的 IO 特点和存储难点
- 海量数据的存储、查询和访问
- 训练的 IO 读取和 Checkpoint 的保存性能
- 多打⼀的⽹络拥塞问题
2. YRCloudFile 的整体解析
- YRCloudFile 整体架构
- 数据并⾏访问,⾼性能存储的核⼼
- 分布式元数据集群 ,⽀撑千亿级⽂件系统的关键
- 缓存和数据⼀致性策略
- 多租⼾隔离和访问流控
- ⾼级运维特性
3. 典型案例
4. 总结和未来展望
您认为,这样的技术在实践过程中有哪些痛点?
- 为了提高缓存的性能,弱化了数据的一致性语义,从强一致性弱化到 open-to-close 的一致性语义
- 性能、可靠性和成本是一个不可能三角,为了尽可能提升性能和降低成本,我们选择采用 2 副本的方式,提升写性能的同时也极大地降低了成本,在 AI 存储以读为主的场景中,这个选择是非常合适的,但是在传统存储场景中就会面临可靠性不足的问题
演讲亮点
- 分享 YRCloudFile ⾼性能⽂件系统的核⼼技术
- 分享在 AI 训练场景中遇到的疑难问题和解决⽅案
- 分享焱融对未来存储发展的思考
听众受益
- 了解 AI 训练对存储的需求
- 对 AI 存储有更深⼊的了解
- 了解性能优化的常见⼿段
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手