黄维啸,月之暗面系统工程师。毕业于清华大学,7 年 AI Infra 系统经验。目前在月之暗面负责 Infra 平台、系统优化相关工作。曾在旷视科技公司主导公司 AI 平台 Brain++ 从 0 到 1 的研发工作。
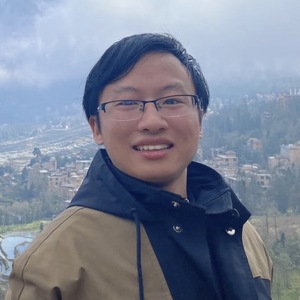
专题演讲嘉宾:黄维啸
月之暗面系统工程师
by 黄维啸
月之暗面
系统工程师随着大模型训练的 Scaling up,对于基础设施的稳定性和高效性提出了更高的要求。本次演讲我将分享月之暗面在训推混部集群中的实践经验,重点探讨如何快速定位并隔离故障,实现任务的高效恢复,从而提升系统整体稳定性。同时,我还会分享如何在资源有限的情况下最大化利用率,避免浪费,进一步将该思路应用于强化学习任务的训练中。希望能为关注大规模模型训练的同行们提供一些可靠的技术思考与实践参考。
演讲提纲
1. 大规模训练推理集群的挑战
- 大规模集群中机器故障频率高,任务失败率高
- 推理场景中的用户请求具备潮汐效应
- 强化学习场景存在资源浪费情况
2. 提高训推混部集群稳定性和资源利用率
- 任务检查点的高效存储和回复
- 故障节点快速发现和隔离,提高训练可观察性,快速找到慢节点
- 潮汐优先级调度,最大化提高资源利用率
3. 通过混合架构提高强化学习效率
- 混合 Sidecar 部署架构
- 训推任务高效切换
您认为,这样的技术在实践过程中有哪些痛点?
- 大规模集群中机器故障问题难以彻底解决,系统上需要做一些权衡
- 训推混部集群存在资源利用率不均衡的问题
演讲亮点
- 通过实际大规模集群的训推混部经验以及框架侧的优化,真实提高了整个系统的可靠性和可扩展性
听众收益
- 了解大模型训练和推理中遇到的稳定性问题及相关实践方案,并进一步提高资源利用率
- 了解在强化学习中如何高效利用显存并提高系统可扩展性
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手