从业十余年,一直从事运维相关的工作。 2016 年加入美图公司,现任美图 SRE 负责人,目前整体负责美图公司线上服务的稳定性保障工作。 曾多次参与或主导过美图公司多项基础设施、运维架构的调整和改造,在监控、灾备、故障管理、稳定性运营等方面有一定的经验积累和行业输出。 致力于推广 SRE、稳定性运营相关的理念及实践,编著有「SRE 系统建设指南」图谱,参与过业界多个 SRE、DevOps 相关案例集/期刊/标准/白皮书的编纂或供稿。 业界多个技术峰会的分享嘉宾、金牌讲师或出品人,SRE 精英联盟成员,中国信通院「稳定性保障实验室」认证专家、关键技术工作组-技术监督委员会委员兼应急工作组组长。
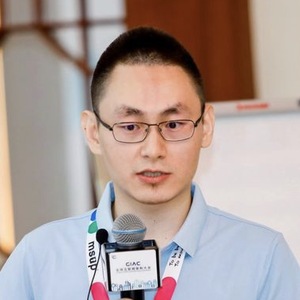
专题演讲嘉宾:石鹏
美图高级运维经理
by 石鹏
美图
高级运维经理在 VUCA 时代,IT 系统日趋复杂、多变、脆弱,线上故障频发,如何快速有效地进行应急处置、保障系统的稳定性是每一位 SRE 必须直面的问题。
本次分享将结合美图 SRE 团队的实践经验,深入探讨故障应急的各个环节。并由此展开,给大家呈现一个典型的“故障生命周期”。我将沿着这个脉络对故障的本质和常见原因进行剖析,对可观测性建设、灾备建设、应急预案及演练、故障复盘等日常高频工作场景进行讲解。此外,也将对 AIOps、LLM Ops 等前沿的技术做一些探讨和交流。相信这些内容对于听众,尤其是中小型企业的 SRE 同学,在提高应急响应能力、提升系统稳定性建设水平等方面会有所帮助。
演讲提纲
1. 引子:你是否会“谈故障色变”,遇到故障慌不慌,为个啥?
2. 洞若观火:洞察本质,掌握规律
- SRE 的核心职责 与 企业发展的关系
- 构建「大框架」:可靠性工程的「全生命周期」
- 构建「大框架」:稳定性运营的「全景图」
- 建立对故障的正确认识
- 稳定性工作的度量 和 工作目标
3. 未雨绸缪:体系建设,主动出击
- 体系化建设清单
- 可观测性建设
- 高可用建设
- 应急预案及预案演练
- SRE 工具箱建设
4. 指挥若定:有章可循,有条不紊
- 原则和建议
- 流程机制约定
- 故障现场指挥
- 常见故障场景 及 常见手段
- 非常规模式 及 处置方法
- 血泪案例分享
5. 复盘改进:吃堑长智,举一反三
- 工作清单复盘
- 故障复盘:从“黄金三问”到“深度思考”
- 如何进行故障的定级、定性、定责?
- 周期回顾 和 数据洞察
6. 补充总结 & 未来展望
- 故障管理 之 体系化框架
- 前沿技术探索及展望
您认为,这样的技术在实践过程中有哪些痛点?
- “老生常谈”的几个需要平衡的问题及 SRE 所面临的典型困境
- 稳定性建设的目标、业务高速迭代的效率诉求、公司在稳定建设方面可以投入的资源之间会存在矛盾
- SRE人手不足、工具建设不到位、忙于救火、疲于应付的恶性循环。破除这些困境,需要找到合适的切入点,方法也因时、因地不尽相同
- 新技术的应用和落地:AIOps、LLM Ops 等新技术为故障应急带来了新的可能性,现在业界也有很多探索和实践。尤其是随着DeepSeek开源之后,有很多团队也在积极拥抱和尝试,但如何将这些技术真正应用到实践中,在落地过程中还有一些问题尚待探索和解决。
- 业务系统、环境的复杂性,可能会带来一些“未知的未知”,这些会对故障应急带来非常大的挑战。
演讲亮点
- 故障管理的流程化和规范化
- 稳定性运营的持续改进
听众收益
- 掌握故障应急的系统性方法:从故障的本质出发,系统性地思考和解决故障应急问题,而不是仅仅停留在“头痛医头,脚痛医脚”
- 提升故障处理的实战能力:了解美图 SRE 团队在故障应急方面的实践,包括可观测性建设、高可用建设、应急预案制定与演练、故障复盘等实操性实践
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手