阎栋,百川智能研究小组负责人。博士毕业于清华大学计算机系。主要从事决策算法/系统和大语言模型对齐/推理方面的研究。在 ICLR、ICML、IJCAI、AAAI、JMLR、Pattern Recognition 等会议/期刊发表论文数十篇。带领团队基于 RLHF 增强的大语言模型 Baichuan3,在 2024 年 4 月份的 Superclue 评测中荣获国内第一。开发的深度诊断模型 Baichuan-M1-ClinicReasoning,已上线百小应APP和百方医生小程序。以小于 Deepseek R1 一个数量级的模型大小,在临床推理场景下达到与 R1 相当的性能。
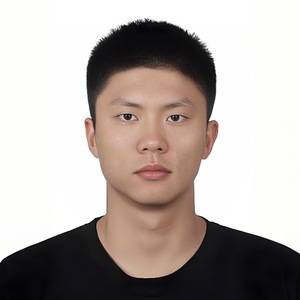
专题演讲嘉宾:阎栋
百川智能研究小组负责人
by 阎栋
百川智能
研究小组负责人自 2024 年 9 月以来,大语言模型在推理方面的展现出了惊人的进展。在代码、数学等需要强大推理能力的领域,大语言模型已经走出实验室走向实践。医疗领域中的临床推理,要求模型基于强大推理能力,将艰深的医学知识灵活的应用到对病人病情的分析和检验检查结果的解读上,从而最终获得正确的诊断。本次演讲从介绍合情推理开始,首先回顾强化学习视角下的大语言模型训练的数学基础,然后以 Deepseek R1 为例梳理大语言模型推理技术的发展,再介绍百川智能研究小组在训练大语言模型进行临床推理的实践,最后讨论如何继续提升模型能力的可能方向以及大语言模型与人类在智能上的差异表现。
演讲提纲
1. 推理:真实世界中的合情推理
2. 序章:强化学习视角下的大语言模型训练
- 在充满噪声的反馈回路下,带着镣铐学习跳舞
- 模仿学习、演示学习和偏好学习
3. 脉络:大语言模型的推理技术的发展,以 Deepseek R1 为例
- 少有人走的路:代码、数学和通用
- R1-Zero 带来的启示:Test Time Scaling 和 SFT Seed
4. 临床:医疗的内生复杂性,推理能力 + 领域知识的临床推理范式
- 临床推理范式:生成诊疗假设,继而通过检验检查数据进行假设证伪与排除,最终经由自反思机制对剩余假设进行概率排序,输出符合临床思维路径的诊疗建议
- 基于Monte-Carlo Tree Search进行推理的几个问题:缺乏多样性、树结构退化以及无法利用前序探索路径
- 临床推理中的state和action定义,以及基于此进行的Process Reward Model数据标注
- 在没有R1的世界大杀四方,Recall “The Bitter Lesson"
5. 展望
- 重谈场景的摩尔定律(杨植麟 vs 闫俊杰)
- 大模型是否比我们更靠近终极真理?大模型智能与人类智能的差异表现
您认为,这样的技术在实践过程中有哪些痛点?
- 专家的稀缺性对 RLHF 范式的根本挑战
- 通用技术进步的曲线仍然很陡峭的情况下,垂直领域难以构建壁垒
演讲亮点
- 一站式回顾大语言模型训练的底层数学机理和推理技术发展
- 对大语言模型与人类在智能方面表现差异的初步讨论
听众收益
- 深入了解大语言模型的训练和推理技术的发展脉络
- 获得如何将大语言模型应用到垂直领域的实践经验
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手