2015 年 NOI 金牌进入清华大学计算机系,曾获清华大学挑战杯一等奖、首都大学生挑战杯一等奖、智能体大赛一等奖等。2017 年加入清华大学自然语言处理实验室,2020 年以骨干身份加入「悟道·文源」中文预训练大模型团队,参与 CPM 系列模型的训练和研发,在此期间编写了大模型高效训练和推理工具 BMTrain、BMInf 等,并获多项发明专利。自 2021 年起担任智源研究院语言大模型加速技术创新中心副主任,并于 2022 年创立面壁智能并担任 CTO,入选 2024 年度“北京市科技新星计划”,致力于推动大模型技术的落地应用。
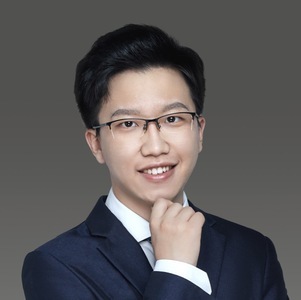
专题演讲嘉宾:曾国洋
面壁智能联合创始人 & CTO
by 曾国洋
面壁智能
联合创始人 & CTO近几年大模型技术快速发展,取得了一系列重大突破,大模型能力的核心“知识密度”逐渐为大家所认知。面壁智能一直以来致力于研发更高知识密度的大模型,在业内首先提出知识密度概念并在模型研发过程中取得实践。本次分享内容将围绕大模型知识密度展开,介绍知识密度与大模型的关系以及知识密度长期发展方向,帮助大家更好的理解大模型技术在未来一段时间的发展趋势,提前布局保障企业的核心竞争力。
演讲提纲
1. 大模型技术趋势
- 从 GPT-3 到 Deepseek-R1 大模型技术演变历程
- 下一次 Deepseek 时刻会发生在哪
- 预训练终结后的大模型前景
2. 知识密度的现状与挑战
- 知识密度的定义与模型发展规律
- 知识密度与模型能力上限的关系
- 突破知识密度的技术实践
3. 思维链与强化学习
- 大模型为什么需要思维链
- 强化学习与思维链技术结合对大模型的意义
4. 大模型应用落地展望
- 未来大模型格局如何演变
- 知识密度之外,大模型应用落地还存在哪些障碍
- 大模型快速发展时代,如何不落后于潮流
关注主办方(InfoQ)


联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Jin
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手