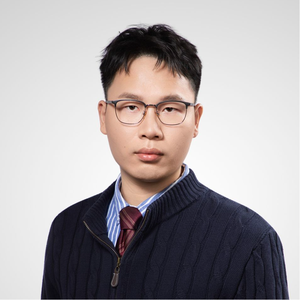
蒋佳军,飞桨大模型部署技术负责人,负责文心大模型在线推理服务,同时负责飞桨大模型高效推理部署套件 FastDeploy 开源工作,在自然语言处理、计算机视觉和推理部署等领域拥有国内外 20 余件发明专利。
讲师介绍
议题介绍
地点:多功能厅 1
所属专题:大模型推理工程实践
演讲:飞桨大模型推理实践:从集中式部署到分离式部署架构的演进
随着生成式 AI 与大模型在智能客服、内容创作等场景的广泛落地,大模型推理的成本瓶颈日益凸显。用户和企业对高性能、低成本的推理能力需求持续攀升。自 2024 年以来,飞桨在大模型推理方向持续发力,先后完成了基于 Prefix Caching 以及投机解码的集中式部署架构的优化,随后演进到分离式部署架构,实现了 PD 分离下的 MTP 加速和高性能 EP 并行优化;此外,通过 MEPC 无损压缩技术与针对昆仑芯 P800 芯片的深度适配,进一步提升了端到端推理效率。本次分享我将系统阐释上述优化思路与实战成果,为大模型在产业级落地提供参考。
演讲提纲
1. 大模型推理的背景与挑战
- 背景与挑战的概要介绍
- 飞桨推理系统的技术演进路径概览
2. 集中式部署阶段的优化实践
- 集中式部署架构特点与瓶颈
- 分布式 Prefix Cache 的设计与优化
- 投机解码机制在高并发场景下的效能提升
3. 分离式部署架构的演进与优化
- 架构演进:从集中式到 PD-EP 分离的设计动因
- MTP 推理并行优化的实现方式与收益
- EP 通信链路的双阶段优化策略
- MEPC 无损压缩技术与量化加速
- 针对昆仑芯 P800 的推理性能适配实践
4. 实践挑战与系统思考
- 架构链路复杂度提升带来的运维与调度挑战
5. 总结与展望
- 架构升级的核心收益
- 飞桨推理系统的下一步优化方向
演讲亮点
- 系统性梳理从集中式到分离式推理架构的演进路径,详解每阶段的关键优化策略
- 飞桨在分布式 Prefix Cache 管理、投机解码、 MTP 并行推理以及 EP 并行等方向的工程创新
- 自研 MEPC 无损压缩方案,助力推理性能与资源效率双提升
- 针对国产芯片昆仑芯 P800 的深度适配与优化实践
听众收益
- 理解大模型推理系统的典型架构形态及演进逻辑
- 学习集中式与分离式部署下的关键优化技术
- 借鉴飞桨在工程落地过程中的系统设计与性能调优经验
- 对国产芯片环境下的大模型部署适配路径获得第一手实践参考
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手