随着千亿参数级的大语言模型(LLM)、多模态模型(如 CLIP、Flamingo... 展开 >
大模型推理工程实践
会议室:多功能厅 1出品人:陈泽裕
- Topic 1
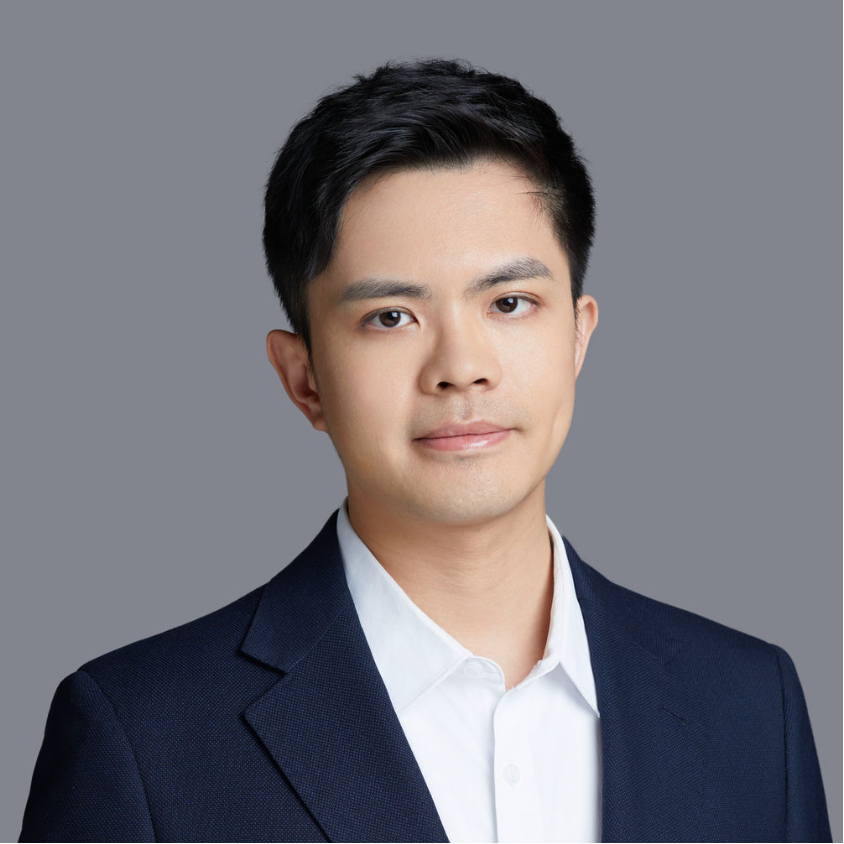
曾书霖 博士
无问芯穹 总经理 - Topic 2
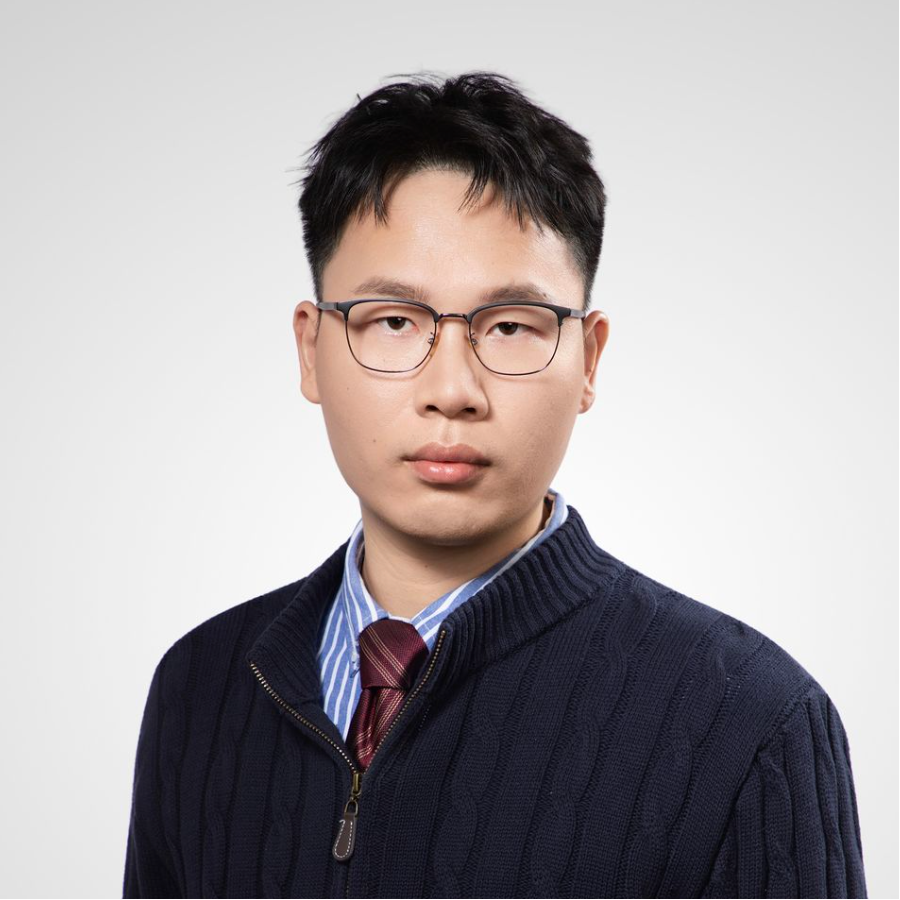
蒋佳军
百度 飞桨大模型部署技术负责人 - Topic 3
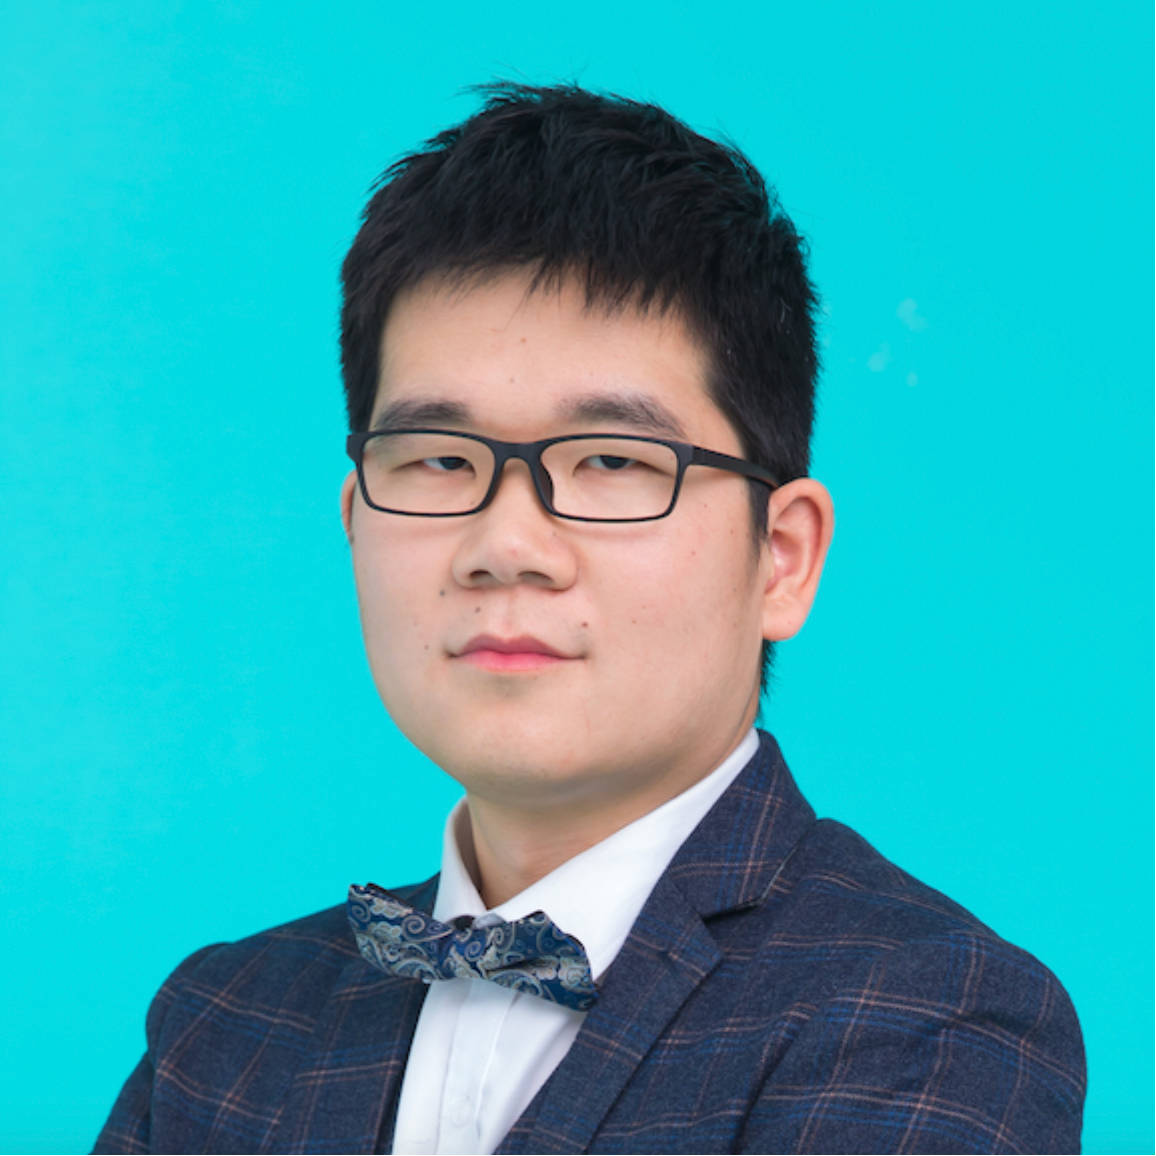
陈庆澍
昆仑芯 资深研发工程师 - Topic 4
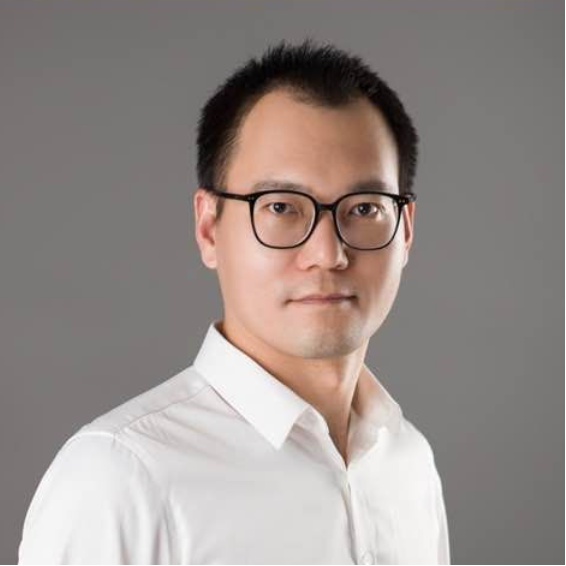
张文涛
焱融科技 CTO
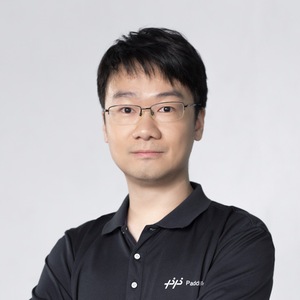
专题出品人:陈泽裕
百度杰出架构师
陈泽裕,百度深度学习技术平台部杰出架构师,现负责文心一言的多硬件推理部署和飞桨(PaddlePaddle)开发套件工作,相关成果支撑文心大模型调用的高速增长,并主导研发了多款覆盖语言、视觉和语音等领域的开源开发套件,在 GitHub 开源社区累计获得超 4 万 Star。曾获得两次百度最高奖。
地点:多功能厅 1
专题:大模型推理工程实践
随着千亿参数级的大语言模型(LLM)、多模态模型(如 CLIP、Flamingo)和生成式 AI 的飞速发展,AI 模型正从“实验室”走向“生产环境”。然而,如何高效、稳定并低成本地将这些模型部署到真实业务场景中,是一个极具挑战性的工程问题。
大模型推理不仅需要处理海量数据,还需要在高并发和低延迟的环境下稳定运行。本专题将聚焦于大模型推理的工程实践,探讨如何通过技术创新、架构优化和工程实践,提升大模型推理的效率和可靠性。
专题可能涵盖的内容:
- 推理架构设计
- 计算优化技术
- 硬件加速与部署
- GPU/TPU优化
by 曾书霖 博士
无问芯穹
总经理AI 2.0 模型对算力和数据的需求激增,导致硬件系统的能耗开销逐渐“供不应求”,亟需软硬协同为 AI 行业提供高质量的 AI 系统能效( Tokens/J) 。本次演讲我将介绍软硬件协同优化以提升智能系统能效的研究成果,包括模型稀疏量化压缩、高效推理系统设计与大模型加速器设计。并且结合华为昇腾集群的工程实践,探讨下一代 AI 推理系统的演进趋势。
演讲提纲
1. 大模型推理从 Token 到价值
- 人工智能发展历程回顾
- Tokens 作为生产要素的关键
- Tokens 实现产业价值的分析
2. 大模型推理的软硬件协同优化层次
- 能效指标的变化
- AI 2.0 的关键指标:高质量 Tokens/J
- 高质量能效优化的现状与路径
- 人工智能软硬件分层
3. 多层次优化技术
- 模型压缩:混合量化与稀疏注意力
- 推理加速:PD半融合加速范式与投机早退加速
- 硬件架构:文生文与文生视频加速器
4. 华为昇腾大模型推理加速实践
- 现状与挑战
- 工程实践
- 未来展望
您认为,这样的技术在实践过程中有哪些痛点?
- 模型规模激增与硬件算力、能效矛盾加剧
- 软件栈与硬件特性难以对齐,工程落地复杂
演讲亮点
- 首提“ 高质量 Tokens/J ”指标,重塑能效评价体系
- 从模型、系统到硬件的全栈协同优化实践
听众收益
- 掌握提升大模型推理能效的系统性方法
- 了解 AI 推理能效的演进方向,提前布局系统架构升级
by 蒋佳军
百度
飞桨大模型部署技术负责人随着生成式 AI 与大模型在智能客服、内容创作等场景的广泛落地,大模型推理的成本瓶颈日益凸显。用户和企业对高性能、低成本的推理能力需求持续攀升。自 2024 年以来,飞桨在大模型推理方向持续发力,先后完成了基于 Prefix Caching 以及投机解码的集中式部署架构的优化,随后演进到分离式部署架构,实现了 PD 分离下的 MTP 加速和高性能 EP 并行优化;此外,通过 MEPC 无损压缩技术与针对昆仑芯 P800 芯片的深度适配,进一步提升了端到端推理效率。本次分享我将系统阐释上述优化思路与实战成果,为大模型在产业级落地提供参考。
演讲提纲
1. 大模型推理的背景与挑战
- 背景与挑战的概要介绍
- 飞桨推理系统的技术演进路径概览
2. 集中式部署阶段的优化实践
- 集中式部署架构特点与瓶颈
- 分布式 Prefix Cache 的设计与优化
- 投机解码机制在高并发场景下的效能提升
3. 分离式部署架构的演进与优化
- 架构演进:从集中式到 PD-EP 分离的设计动因
- MTP 推理并行优化的实现方式与收益
- EP 通信链路的双阶段优化策略
- MEPC 无损压缩技术与量化加速
- 针对昆仑芯 P800 的推理性能适配实践
4. 实践挑战与系统思考
- 架构链路复杂度提升带来的运维与调度挑战
5. 总结与展望
- 架构升级的核心收益
- 飞桨推理系统的下一步优化方向
演讲亮点
- 系统性梳理从集中式到分离式推理架构的演进路径,详解每阶段的关键优化策略
- 飞桨在分布式 Prefix Cache 管理、投机解码、 MTP 并行推理以及 EP 并行等方向的工程创新
- 自研 MEPC 无损压缩方案,助力推理性能与资源效率双提升
- 针对国产芯片昆仑芯 P800 的深度适配与优化实践
听众收益
- 理解大模型推理系统的典型架构形态及演进逻辑
- 学习集中式与分离式部署下的关键优化技术
- 借鉴飞桨在工程落地过程中的系统设计与性能调优经验
- 对国产芯片环境下的大模型部署适配路径获得第一手实践参考
by 陈庆澍
昆仑芯
资深研发工程师2025 年初,DeepSeek 模型效果跻身全球 AI 第一梯队,且以超低推理成本引发行业震动。面对国内大规模部署需求,如何在国产芯片上实现性能与成本的双重突破成为关键。本次演讲我将深度揭秘昆仑芯团队在 DeepSeek 推理优化中的创新实践:通过软硬结合,实现推理性能数倍提升,TCO 相比 GPU 持平甚至更低,为国产 AI 生态落地提供硬核支撑,助力 DeepSeek 在千行百业规模化应用!
演讲提纲
1. DeepSeek 背景介绍
- DeepSeek 模型对算力 & 互联需求
2. GPU 技术方案解析
- PD 分离架构
- Prefill 性能上限
- Decode 性能上限
3. 昆仑芯关键优化点
- 昆仑芯 DeepSeek 推理整体架构设计
- DeepEP 性能优化
- 通算融合方案
- 性能对比
4. 总结与展望
- 下一代芯片设计
您认为,这样的技术在实践过程中有哪些痛点?
- 主流模型都是基于英伟达 GPU 设计, 有利于发挥英伟达 GPU 性能,国产 AI 芯片适配&端到端精度对齐需要更多的工程投入
演讲亮点
- 深度解析 DeepSeek 对硬件算力与互联的底层需求,提供芯片选型“避坑指南”
- 昆仑芯上软硬结合极致优化方案
听众收益
- 掌握芯片选型的核心逻辑,避免“盲目追新”
- 获得可落地的国产 AI 芯片优化方案,缩短部署周期
by 张文涛
焱融科技
CTO2025 年年初,DeepSeek 凭借免费开源的超大语言推理模型迅速走红,掀起了全民部署大模型的热潮。随之而来,如何降低大模型使用成本成为业界关注的焦点。其中,最具吸引力的当属 KVCache “以存代算”技术。
当前,KVCache 缓存技术已成为提升大模型推理效率的行业共识。但要真正发挥其价值,关键在于扩展 KVCache 的存储缓存层以增强大模型的记忆能力,同时存储缓存层也必须具备强大的支持能力。焱融科技基于自研高性能分布式文件系统 YRCloudFile 打造了 YRCache 推理加速方案,显著提升了推理效率和模型推理性价比。
在本次演讲中,我将深入介绍焱融 YRCache 推理加速方案的技术架构和核心能力,并分享其在真实业务场景中的加速效果!
演讲提纲
1. KVCache 的技术背景和挑战
- KVCache 的作用和技术原理
- KVCache 的常见优化思路
- vLLM Prefix Caching 的局限性
- KVCache 缓存对 PD 分离架构的影响
2. YRCache 多级缓存技术方案
- YRCache 数据的元数据管理方案
- YRCache 缓存数据的管理策略
- YRCache 多级缓存和调度器的协同优化
- YRCache 多级缓存对 PD 分离架构的优化
3. 针对推理业务的加速效果实践
- RAG 知识库场景的实践效果
- 代码生成场景的实践效果
- 多轮对话场景的实践效果
4. 总结和展望
- KVCache 多级缓存带来的收益
- KVCache 多级缓存的未来演进路线
演讲亮点
- 深度解析 KVCache 技术原理
- 深度解析 KVCache Offloading 主流方案
- 焱融 YRCache 方案的技术架构与整体解决方案
- 详实分享多个实际业务场景的加速效果
听众收益
- 了解 KVCache 的技术原理与应用价值
- 掌握 vLLM 生态主流的 KVCache Offloading 方案以及架构差异与优劣势
- 了解 KVCache 的适用场景以及不同场景中的最佳实践参考,助力技术选型与系统优化
关注主办方(InfoQ)
联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手