曾书霖,上海无问芯穹智能科技有限公司总经理。于 2018 年和 2023 年在清华大学电子工程系获得工学学士和博士学位,师从清华大学电子工程系系主任、IEEE Fellow 汪玉教授,研究领域为软硬协同优化研究和 AI 加速器设计。在相关领域发表高水平国际会议和期刊论文 20 余篇,谷歌学术施引九百余次,包括以第一作者或共同一作发表高水平论文于可重构计算领域旗舰会议( FPGA · 25, FPGA · 24)、体系结构领域顶级会议 (HPCA · 25, MICRO · 23)、以及顶级期刊 IEEE TC、ACM TRETS 等。曾获 FPGA 2025 会议最佳论文奖( FPGA 会议首次将该奖项授予完全由中国大陆科研团队主导的研究工作,也是亚太国家团队首次获此殊荣)、IEEE TC 2023 Featured Paper of the Month、清华大学研究生国家奖学金等。在创新创业方面,作为创始成员参与创立上海无问芯穹智能科技有限公司,并作为智能终端业务负责人,带领团队打造“端模型 + 端软件 + 端 IP ”的智能终端一体化解决方案。
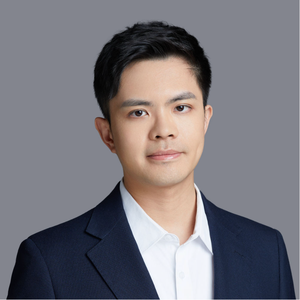
专题演讲嘉宾:曾书霖 博士
无问芯穹总经理
by 曾书霖 博士
无问芯穹
总经理AI 2.0 模型对算力和数据的需求激增,导致硬件系统的能耗开销逐渐“供不应求”,亟需软硬协同为 AI 行业提供高质量的 AI 系统能效( Tokens/J) 。本次演讲我将介绍软硬件协同优化以提升智能系统能效的研究成果,包括模型稀疏量化压缩、高效推理系统设计与大模型加速器设计。并且结合华为昇腾集群的工程实践,探讨下一代 AI 推理系统的演进趋势。
演讲提纲
1. 大模型推理从 Token 到价值
- 人工智能发展历程回顾
- Tokens 作为生产要素的关键
- Tokens 实现产业价值的分析
2. 大模型推理的软硬件协同优化层次
- 能效指标的变化
- AI 2.0 的关键指标:高质量 Tokens/J
- 高质量能效优化的现状与路径
- 人工智能软硬件分层
3. 多层次优化技术
- 模型压缩:混合量化与稀疏注意力
- 推理加速:PD半融合加速范式与投机早退加速
- 硬件架构:文生文与文生视频加速器
4. 华为昇腾大模型推理加速实践
- 现状与挑战
- 工程实践
- 未来展望
您认为,这样的技术在实践过程中有哪些痛点?
- 模型规模激增与硬件算力、能效矛盾加剧
- 软件栈与硬件特性难以对齐,工程落地复杂
演讲亮点
- 首提“ 高质量 Tokens/J ”指标,重塑能效评价体系
- 从模型、系统到硬件的全栈协同优化实践
听众收益
- 掌握提升大模型推理能效的系统性方法
- 了解 AI 推理能效的演进方向,提前布局系统架构升级
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手