吴翼,清华大学交叉信息院助理教授,博士生导师,前 OpenAI 研究员。博士毕业于加州大学伯克利分校,研究方向为强化学习。Google Scholar 引用超过 13000 次,曾获 NIPS 2016 best paper award,ICRA best demo award finalist,并获得 2025 年 WAIC 云帆奖。
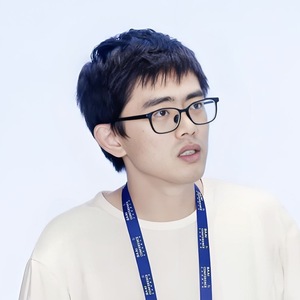
专题演讲嘉宾:吴翼 博士
清华大学交叉信息院助理教授,博士生导师,前 OpenAI 研究员
by 吴翼 博士
清华大学交叉信息院助理教授,博士生导师,前 OpenAI 研究员
随着大模型与智能体(Agent)技术的快速发展,强化学习(RL)正成为提升 AI 代理自主决策能力的关键引擎。然而,传统的 RL 训练方法面临计算成本高、数据需求大、系统复杂度高等挑战,限制了 Agent 的规模化落地。本次演讲我将重点介绍针对 Agent 模型的强化学习训练系统 AReaL 及其在 Agent 场景下的最佳实践。通过真实数据和可复现的代码,展示 AReaL 如何帮助开发者和企业高效构建智能体系统,并推动 AI Agent 从实验室走向产业应用。
演讲大纲
1. Agent 时代的强化学习新挑战
- 传统 RL 训练的瓶颈
- 数据需求:高质量人类反馈(RLHF)的获取成本
- 计算效率:长序列任务(10 K+ tokens)的显存与吞吐问题
- 系统复杂度:多模块(生成、奖励、策略优化)协同训练的工程难题
- AReaL 的破局思路
- 异步强化学习训练:2.77x 强化学习训练提升
- SOTA 推理模型:通过强化学习在多个任务轻松实现 SOTA
- 全栈开源简单易用:代码、数据、模型、脚本的完整可复现性,轻量级版本轻松入门强化学习
2. AReaL 在 Agent 场景的核心技术
3. Agent 最佳实践案例
4. 社区生态与未来计划
演讲亮点
- 面向 Agent 的强化学习技术突破
- 独家开源实践
- 前沿 Agent 场景落地
听众收益
- 获取降本增效的 RL 落地路径
- 解锁 AI 与业务场景的融合范式
- 了解 AReaL 未来支持多模态 Agent、异步训练的路线图,提前布局技术生态
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手