浙江大学计算机硕士,支付宝体验技术方向算法负责人,毕业后主要研究方向包括计算机视觉、AIGC、多模态大模型等。目前主要负责前端和体验技术领域的算法研究和工程化落地,曾参与支付宝前端 3.0 智能研发、UI 理解生成大模型、智能 UI 推荐、用户体验度量、动效 AIGC 等项目。
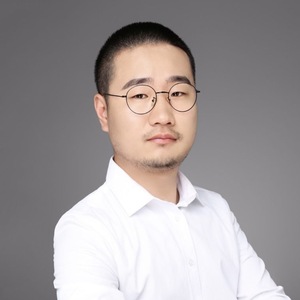
专题演讲嘉宾:杨颢
蚂蚁集团支付宝体验技术部算法负责人
by 杨颢
蚂蚁集团
支付宝体验技术部算法负责人随着大模型技术在前端领域的深度应用,如何高效整合前端领域的多模态知识、优化代码仓库理解成为核心挑战。传统知识库依赖单一文本数据且检索效率有限,而代码仓库的静态描述方法易受上下文长度限制。本次演讲我将分享通过多模态知识抽取、多样的知识存储与检索策略、端云结合的 AI 服务等优化方案,实现高效知识管理,沉淀完整又专业的前端领域知识库和搜索召回方案的实践。同时结合本地代码仓库动态分析与搜索召回能力,尝试解决大模型解决领域知识匮乏的难题,推动前端研发智能化的水平达到一个新的台阶。
演讲提纲
1. 前端领域知识库建设全景
- 多源知识融合:知识文档/代码仓库/组件库/ API 文档等异构数据接入
- 多模态解析技术:文本/图片/代码/流程图的结构化提取与向量化
- 分层存储架构:向量库/知识图谱/关系型数据库的协同
2. 仓库描述新范式 AI-Repomix
- 传统方案瓶颈:规则式仓库描述(如 Repomix )的上下文冗余问题
- AI 增强型仓库解析:大模型驱动的目录级/文件级摘要生成
- 本地化向量数据库:Embedding 缓存+实时相似度检索的混合架构
- 动态上下文压缩:精准聚焦 Query 相关代码片段和仓库
3. AI 搜索驱动的领域知识 RAG 实践
- 智能召回体系:端云协同 + 多路召回 + 分层重排的搜索策略
- 领域知识嵌入的 RAG:基于的召回内容的大模型增强生成
4. 实践案例
- 领域知识库辅助前端研发提效案例
- 领域 UI 组件库辅助前端代码生成案例
您认为,这样的技术在实践过程中有哪些痛点?
- 前端领域多源异构数据(文档/代码/图片/前端组件等)如何实现统一知识化?
- 如何解决长上下文代码仓库的理解问题?
- 如何同时解决端云两侧领域知识的召回和辅助生成问题?
演讲亮点
- 多模态知识熔炉:文本/代码/图像/前端组件跨模态关联检索
- 代码仓库描述:AI 模型优化的本地代码仓库描述解决方案
- 生成式研发辅助:领域知识驱动的组件级代码研发提效和代码生成案例
听众收益
- 获得领域知识库建设的完整技术图谱
- 掌握代码仓库动态解析和消费的完整流程
- 学习可复用的 RAG 增强模式和完整技术链路
- 洞见前端研发智能化演进趋势:领域知识与生成式 AI 的深度融合
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手