李也,阿里云云原生可观测算法专家,香港中文大学计算机博士,在智能运维和数据驱动的决策方向有近 10 年科研和落地经验。主导的异常检测和根因定位等 AIOps 算法在阿里云大规模落地。在ASPLOS、SIGMOD、WWW、VLDB、TKDE、TON 等顶会顶刊发表过多篇 AIOps 算法论文,并在这些国际会议上做报告。目前他专注于大模型 Agent 及其强化学习在智能运维场景的落地。
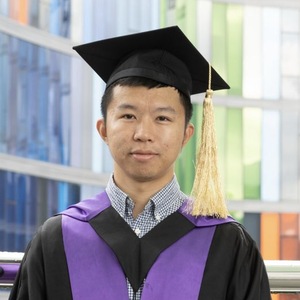
专题演讲嘉宾:李也 博士
阿里云算法专家
by 李也 博士
阿里云
算法专家大模型 Agent 在智能运维场景落地时常常遇到“做 demo 容易,泛化难”的问题。借鉴编程智能体中可验证环境的成功经验,我们构建了智能运维领域的可验证实验环境和高质量评测集。阿里云可观测团队对云原生应用的运行态进行了详尽的理论建模,构建了覆盖 APM/容器/云服务/操作系统/LLM 应用等领域的实验环境,设计了全面的故障注入机制,并在此基础上制作了大规模高质量的评测集。
本次分享我将介绍这个实验环境并发布评测集,深入探讨如何利用评测集验证并提升基于 Agent 的智能运维算法泛化性。
演讲提纲
1. 智能运维泛化之痛
- 传统的基于规则的智能运维难泛化
- 受限于基础大模型能力限制,基于 Prompt Engineering 和大模型 Workflow 的智能运维在泛化性上也会遇到瓶颈
- 用大模型 Agent 做 demo 容易,上生产难
2. 智能运维领域的评测集介绍
- 评测集的规模:数据量级与场景多样性
- 评测集的覆盖度:跨领域的全面性
3. 如何构建高质量的评测集
- 在解决智能运维场景泛化性问题之前,我们需要想清楚要泛化到哪些场景
- 对智能运维 Agent 评测问题的理论建模——把问题边界想清楚
- 实验环境的架构设计和实现
- 构建评测集过程中踩过的坑与经验教训
4. 基于评测集的智能运维 Agent 能力提升实践
- 如何用评测集验证智能运维 Agent 的泛化性及其可信度
- 阿里云智能运维 Agent 在评测集上的表现
- 如何用实验环境和评测集提升智能运维 Agent 的泛化性
您认为,这样的技术在实践过程中有哪些痛点?
- 对系统状态的建模和故障注入的覆盖度有一定的假设
演讲亮点
- 工程实践:阿里云可观测团队构建 AIOps 评测集的技术实践
- 方法论创新:把问题想清楚——关于如何构建评测集覆盖尽可能多真实问题的深度思考
- 实战指南:如何用评测集验证并提升智能运维 Agent 的泛化性
听众收益
- 了解一个可以用于验证并提升智能运维 Agent 泛化性的高质量评测集
- 掌握如何用高质量评测集提升 Agent 泛化性的方法
- 获得构建企业级 AIOps 评测体系的实践经验
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手