李志宇,博士毕业于中国人民大学,,现任记忆张量(上海)科技有限公司联合创始人兼 CTO、上海算法创新研究院研究员和上海交通大学AI学院企业青年科学家。长期从事大模型与生成式人工智能方向的研发攻关,是国内大模型“记忆增强”领域的技术先行者。曾在阿里巴巴、小红书等头部科技企业带队承担多个核心算法项目,技术成果服务双十一、营销广告等超大规模场景,累计带来数十亿营收。记忆张量创立以来,其带领团队提出“忆³”大模型创新架构及首个大模型记忆操作系统( MemOS ),技术成果已在中国银行、招商证券、中国电信、新华社等多家国央企落地应用。李博士已在 Patterns(Cell子刊)、ICLR、ACL、AAAI 等国际顶会与顶刊发表论文40余篇、引用近千次、授权专利 10 余项,现任中国中文信息学会信息检索专委会委员、大模型与生成专委会委员,入选《麻省理工科技评论》封面报道。
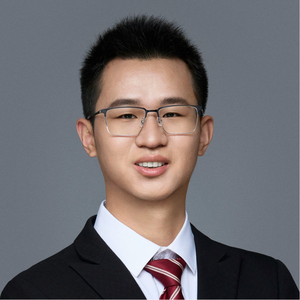
专题演讲嘉宾:李志宇 博士
记忆张量CTO
by 李志宇 博士
记忆张量
CTO随着大模型在企业和行业场景中持续落地,“记忆”正在成为继参数调优和上下文工程之后的下一个工程化核心。短时遗忘、知识碎片化、跨任务信息无法留存等问题,正在限制大模型的个性化、推理链延展与持续演化能力。
本次演讲我将结合多年的研发与落地实践,系统剖析大模型记忆工程的核心技术:记忆分层管理、多粒度调度、可信更新与安全治理,并展示这些技术在金融、工业、知识管理等业务中的应用效果。通过对架构设计、实现细节和案例经验的讲解,帮助开发者与架构师全面理解如何构建具备长期留存与动态调度能力的“有记忆的 AI”,以及它在未来产业智能化演进中的角色与挑战。
演讲大纲
1. 引入与背景
- 大模型能力跃迁:从参数驱动 → 上下文工程 → 记忆工程
- 为什么记忆成为瓶颈:个性化、跨任务学习与推理链断裂
2. 记忆工程的核心理念
- 记忆的三种形态:参数记忆、激活记忆、外部显式记忆
- 记忆的三大能力:生产、调度、学习
3. 架构与实现方法
- 分层记忆架构:时间尺度与精度需求的统一调度
- 多粒度调度机制:时间跨度、信息密度、任务相关性管理
- 高效与成本的动态平衡
4. 实践案例
- 金融:合规可控的知识留存与智能问答
- 工业:跨任务的设备状态与维护历史记忆
- 知识管理:企业内部知识的动态积累与复用
5. 工程落地挑战与治理
- 记忆可信度与幻觉控制
- 长期存储的隐私与合规治理
- 与 LLM / RAG / 多模态系统的融合
6. 未来趋势与总结
- 从“模型中心”到“记忆中心”的 AI 架构转型
- 开放生态与跨领域记忆共享的可能性
演讲亮点
- 记忆分层管理的系统化设计:不同于只做上下文扩展或向量检索的方案,MemOS 将记忆分为参数记忆、激活记忆和明文记忆,按时间尺度与精度需求进行统一调度,兼顾性能、成本与准确性
- 多粒度记忆调度机制:通过对记忆的时间跨度、信息密度和任务相关性进行分级管理,实现按需调用、动态加载和精准匹配,避免“调用过多浪费算力”或“调用不足影响准确性”
听众收益
- 理解记忆技术的全景图:从短期上下文到长期外部记忆的演进路径和关键设计点
- 掌握落地方法论:学会如何通过分层管理与多粒度调度提升大模型可用性与成本效率
- 真实案例经验借鉴:获得不同行业在引入记忆增强 AI 时的技术路线与避坑方法
关注主办方(InfoQ)


联系我们
交通指南
上海浦东滨江喜来登酒店
SHERATON SHANGHAI PUDONG RIVERSIDE
地址:上海浦东大道2288号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:+86 18514549229

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手